一、开篇:为什么你需要这个工具?
每次代码评审,你是否也遇到这样的场景:PR 改了 30 个文件,AI 工具只挑了 8 个给出意见,剩下的直接跳过;好不容易定位到一个 bug,结果行号错位,注释飘到了隔壁文件的空行;改一行 prompt,输出质量像开盲盒,时好时坏。这些问题在通用 Agent(Claude Code / Codex / Cursor)上反复出现,根源在于「纯语言驱动」架构缺乏硬约束。代码评审不是聊天,准确率和稳定性才是硬指标。
二、项目简介:一句话说明它是什么
OpenCodeReview 是阿里巴巴开源的 AI 代码评审 CLI 工具,原为阿里内部官方评审助手,服务数万名开发者两年、检出数百万缺陷后孵化而来。它采用「确定性工程流水线 + LLM Agent」混合架构,主打行级精确评论、内置多语言规则集(NPE、线程安全、XSS、SQL 注入)、兼容 OpenAI 与 Anthropic 协议。当前 GitHub Stars 突破 2 万,已通过 OpenSSF Gold 认证。
三、核心功能深度解析
1. 行级精确评论
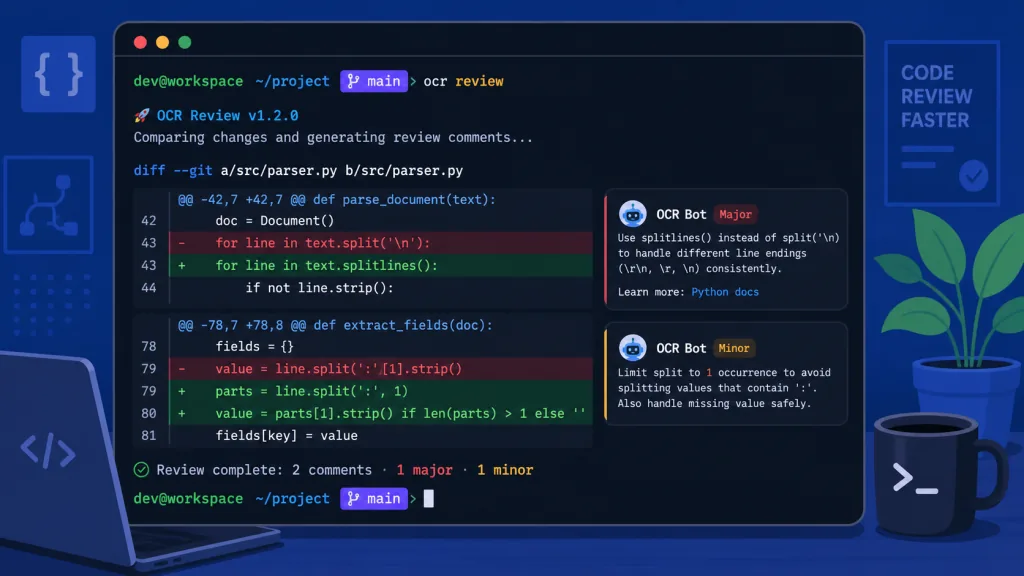
OpenCodeReview 通过「外部定位 + 反思模块」解决行号漂移难题。评论定位和内容生成由独立模块串行执行,先锁定文件与行号,再让模型反思评论是否对得上代码。相比通用 Agent「一次生成、位置随便填」的方案,定位准确率显著提升,工程师不用再为找评论翻代码。
2. 智能文件打包
面对大型 PR,系统将关联文件归入同一评审单元(如 message_en.properties 与 message_zh.properties 必须同看),每个打包作为独立子 Agent 在隔离上下文中运行。这是分治策略,既保证大变更集下的稳定性,也天然支持并发评审,CI 等待时间更可控。
3. 细粒度规则匹配
基于模板引擎的规则匹配按文件特征分发规则集,让模型注意力聚焦当前文件相关风险。相比「在 prompt 里塞一大段规则文字」的方案,匹配过程更稳定、更可预测,输出噪声显著降低。
4. 全量文件扫描(ocr scan)
不止审 diff,ocr scan 支持对整个文件做评审,适用于审计陌生代码库或没有 git 历史的目录。结合 --resume 会话恢复,断网或中断后可无缝续跑。
四、技术亮点与性能数据
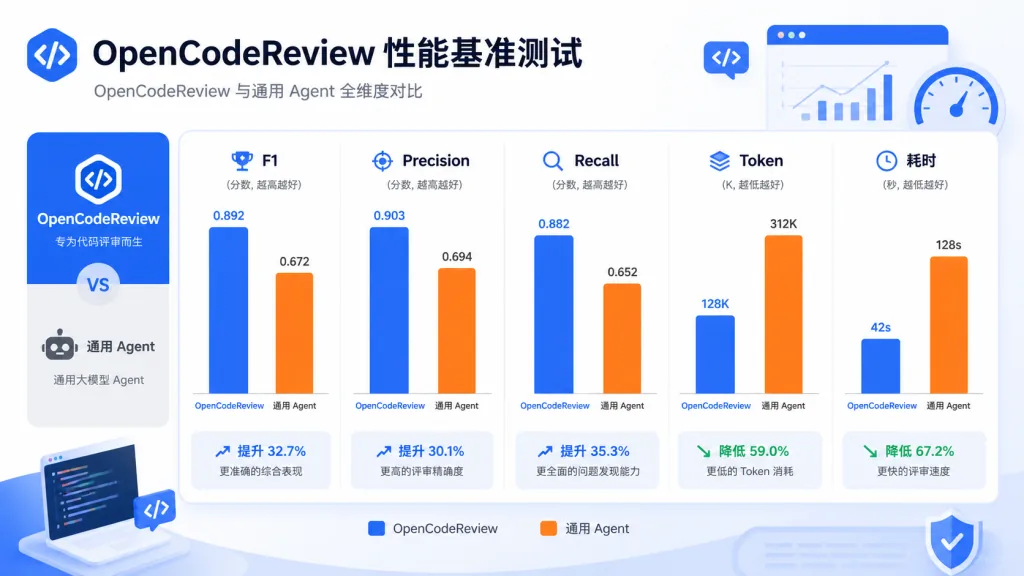
基于 50 个热门开源仓库、200 个真实 PR、10 种编程语言、由 80 余名高级工程师交叉标注的 1505 条 ground-truth 基准测试结果显示:
- F1 与 Precision 显著高于通用 Agent(同模型对比)
- 平均 Token 消耗仅为通用 Agent 的约 1/9
- 平均评审耗时更短
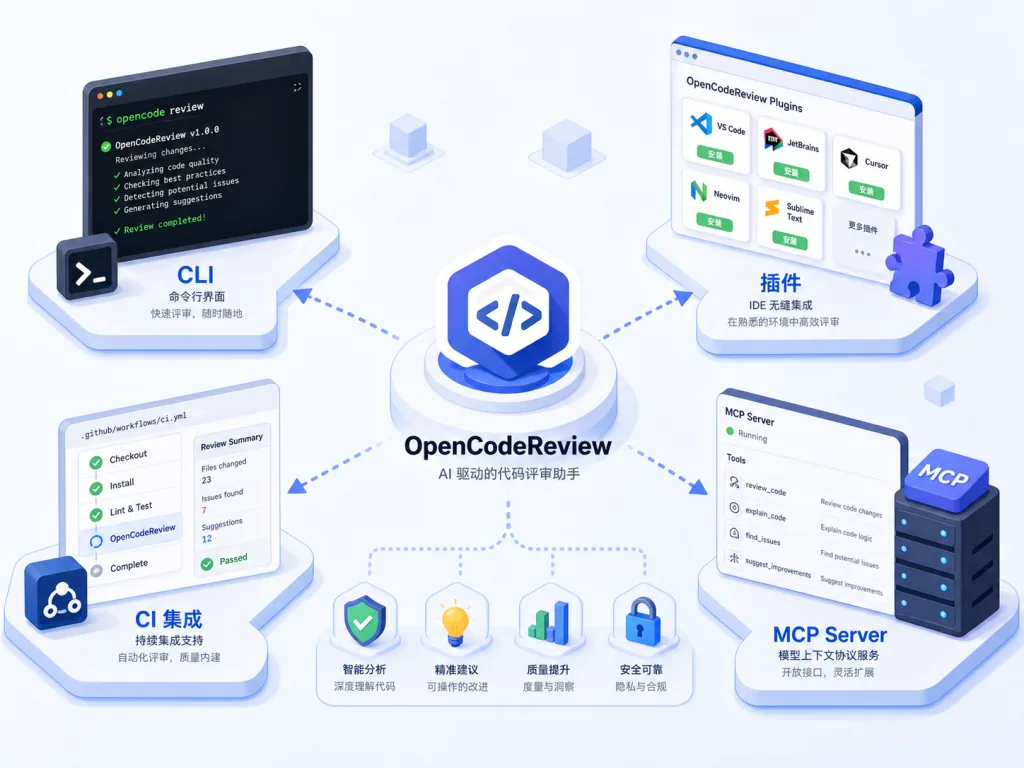
设计上,工具集经过大规模生产数据的工具调用频次、重复率、新工具影响分析蒸馏而来,专为代码评审场景定制,而非通用 Agent 工具包。生态方面,CLI 原生支持 Windows / macOS / Linux,提供 Claude Code、Codex、Cursor、OpenCode 等插件,并支持 GitHub Actions、GitLab CI、GitFlic CI、Gerrit 集成。
五、适用场景与人群
场景 1:大型 PR 评审
当一个特性分支改动 50+ 文件、跨多个模块时,OpenCodeReview 的文件打包 + 并发子 Agent 能稳定覆盖全部变更,避免通用 Agent「挑着看」的遗漏。
场景 2:CI/CD 卡点
GitHub Actions / GitLab CI 中接入,每次 push 自动评审;F1 高、Token 低意味着成本可控、噪音少,不会刷屏阻塞合并。
场景 3:历史代码审计
接手遗留系统或审计开源代码时,用 ocr scan --path internal/ 做全量扫描,无需 git diff,直接给出风险清单。
适合:追求高 Precision、关心 API 成本、有 CI 流水线的中大型团队。不适合:只想要「聊天式代码问答」、不需要行级准确评论的个人轻量用户。
六、竞品对比
| 维度 | OpenCodeReview | 通用 Agent(Claude Code/Codex) | 传统静态分析(SonarQube 等) |
|---|---|---|---|
| 架构 | 确定性流水线 + Agent 混合 | 纯语言驱动 | 规则匹配,无 LLM |
| 位置精度 | 行级,独立定位模块 | 容易漂移 | N/A(按规则报位置) |
| Token 成本 | 约通用 Agent 的 1/9 | 基准 | 极低(无 LLM 调用) |
| 上下文理解 | Agent 子单元隔离上下文 | 全局上下文 | 弱 |
| 自定义规则 | 内置 NPE/线程安全/XSS/SQL 注入 | 靠 prompt | 强 |
| 大变更集稳定性 | 打包 + 并发,稳定 | 易「偷懒」漏文件 | 稳定 |
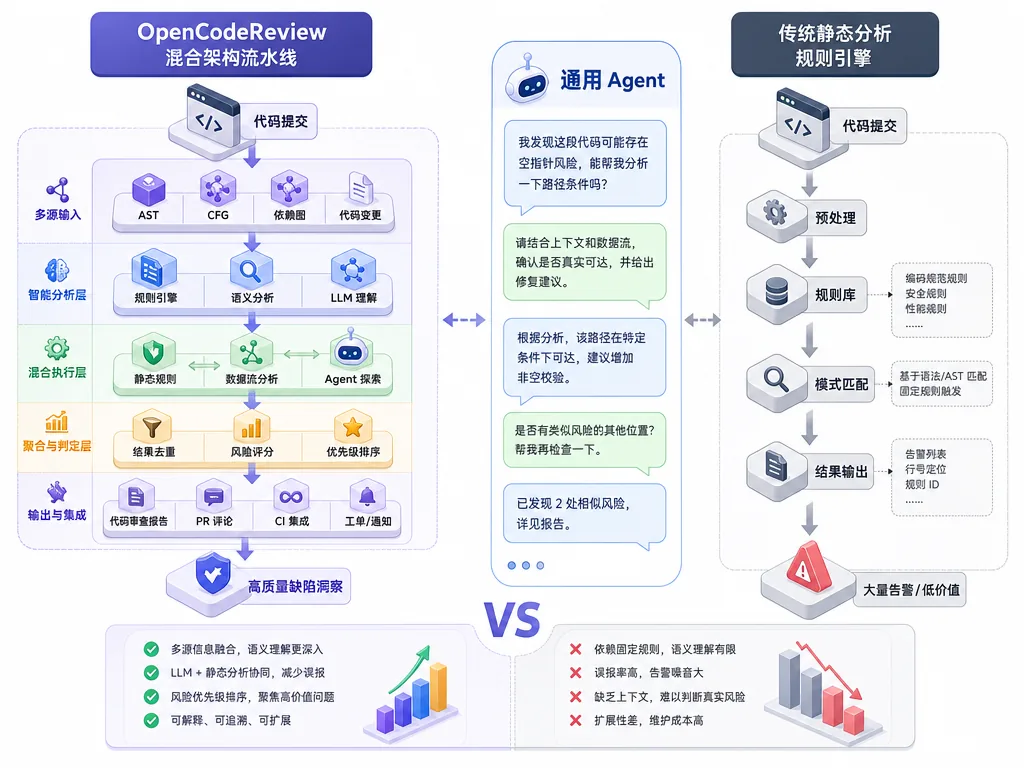
选择 OpenCodeReview 的核心理由:通用 Agent 灵活但不稳定,传统静态分析稳定但缺乏上下文理解,OpenCodeReview 把两者的优势焊在了一起。
七、如何快速上手
安装
npm install -g @alibaba-group/open-code-review
安装完成后全局可使用 ocr 命令。也提供安装脚本、GitHub Release 二进制、从源码编译等方式,详见官方文档。
配置 LLM
ocr config provider   # 选择内置 Provider 或新增自定义
ocr config model      # 为当前 Provider 选择模型
交互式界面会引导你选择 Provider、填入 API Key、选择模型并自动测试连通性。OpenAI 与 Anthropic 兼容协议开箱即用。
最小可用示例
cd your-project

# 工作区模式:评审已暂存、未暂存、未跟踪的所有变更
ocr review

# 分支范围:评审 feature-branch 自从 fork 自 main 起的所有变更
ocr review --from main --to feature-branch

# 单个 commit
ocr review --commit abc123

# 全量扫描(无需 git diff)
ocr scan --path internal/agent

# 委托模式:让 Claude Code / Codex 等宿主 Agent 自己评审,OCR 只负责文件筛选与规则解析
ocr delegate preview
ocr delegate rule src/main.go src/handler.go
进阶建议
- 在 CI 中加
--from main --to HEAD,每次 PR 自动跑评审 - 用
ocr session list查看历史会话,断点续评 - 接入 OpenTelemetry 做观测,按 PR 维度统计 Token 与耗时
八、总结与行动建议
OpenCodeReview 用「确定性工程 + Agent」的混合架构,把代码评审从「靠 prompt 碰运气」拉回到「工程级稳定输出」。F1 高、Token 仅为通用 Agent 1/9、行级精确,加上阿里两年大规模生产验证,是中大型团队在 CI 中卡代码质量的可靠选择。
- GitHub:https://github.com/alibaba/open-code-review
- 官网:https://open-codereview.ai
- 文档:https://open-codereview.ai/docs
- npm:
@alibaba-group/open-code-review
一句话推荐:要行级精确、要低 Token、要 CI 稳定跑,选 OpenCodeReview。