选择标题(3 选 1)
翻完一本 400 页英文书太崩溃?deusyu/translate-book 用 8 个并发子智能体替你搞定
deusyu/translate-book:把整本 PDF 切成 chunk 并行翻译,8 路并发 + 术语表保证翻完不"漂移"
上下文撑爆就被截断?deusyu/translate-book 用"新窗口子智能体"绕过了这个坑
整本 PDF 扔进去,它就自己翻完——deusyu/translate-book 把多智能体流水线装进了你的 AI 编程助手
一、开篇:如果有个工具能替你做完这一步…
一本 400 页的英文技术书想啃完,常规路径只有两条:硬读十几天,或者一章一章丢给 AI 翻译然后手动拼接。后者听起来轻松,真正做过的人都懂那种苦——前面翻到 transformer 是"变压器",后半段又变成了"变换器";某章男主叫 Alex,下一章就变成 Alec;翻到一半 session 截断,剩下两章还得重来。上下文一长,模型就开始"忘记"前文,术语、性别、代词全乱套。
deusyu/translate-book 的作者显然也被这件事折磨过。GitHub 上 2096 颗 Star 的项目,专门干一件事:把整本书(PDF/DOCX/EPUB)扔给它所在的那个 AI Agent,剩下的分章、并发翻译、术语一致性校验、合并导出 EPUB/PDF/DOCX/HTML 一气呵成。
二、项目定位:它解决的是什么问题
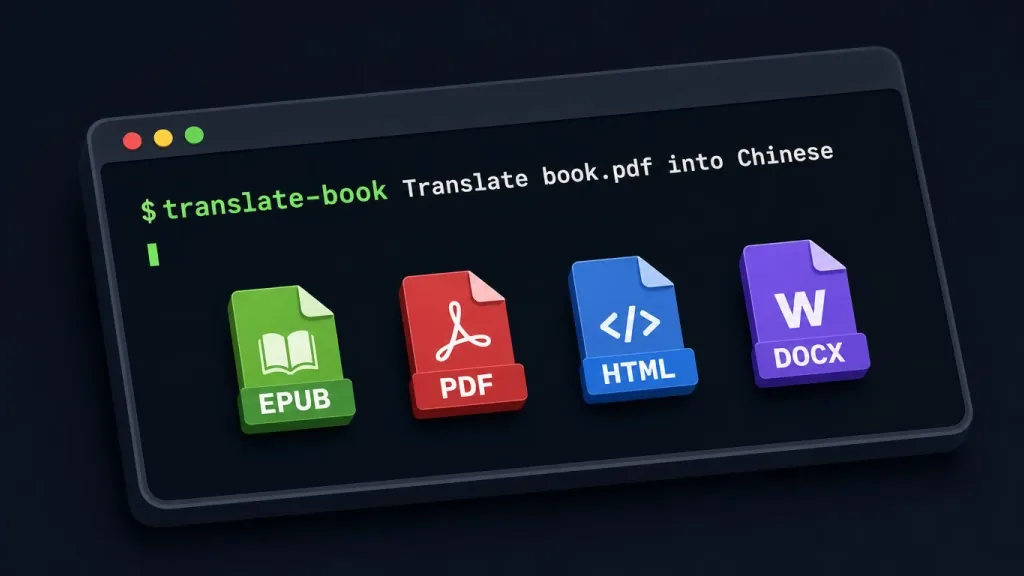
translate-book 是一个面向 Codex、Claude Code、OpenClaw 的 Agent Skill,核心定位是把"长文档翻译"从单次会话的体力活改造成多智能体流水线工程。它把一本书切成 ~6000 字符的 chunk,默认 8 个并发子智能体各自翻译,互相看不到完整上下文却能通过"邻居片段"和全局术语表保持一致;翻译完后用 SHA-256 清单校验、合并,最终通过 Pandoc + Calibre 产出带浮动目录的 HTML、DOCX、EPUB、PDF 四种格式。
核心特性四个关键词:并行子智能体、可断点续跑、术语一致性、可校验管线。2096 Star、Python 实现、MIT 协议,是一个独立项目而非原 claude_translater 的分支,重写了工作流。
三、核心功能深度解析
1. 并发子智能体+独立上下文窗口
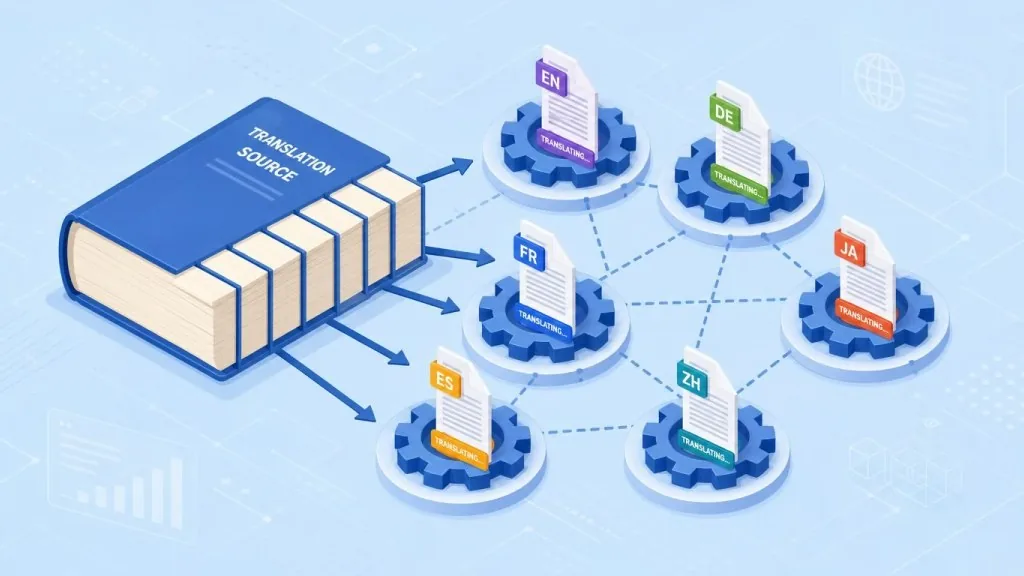
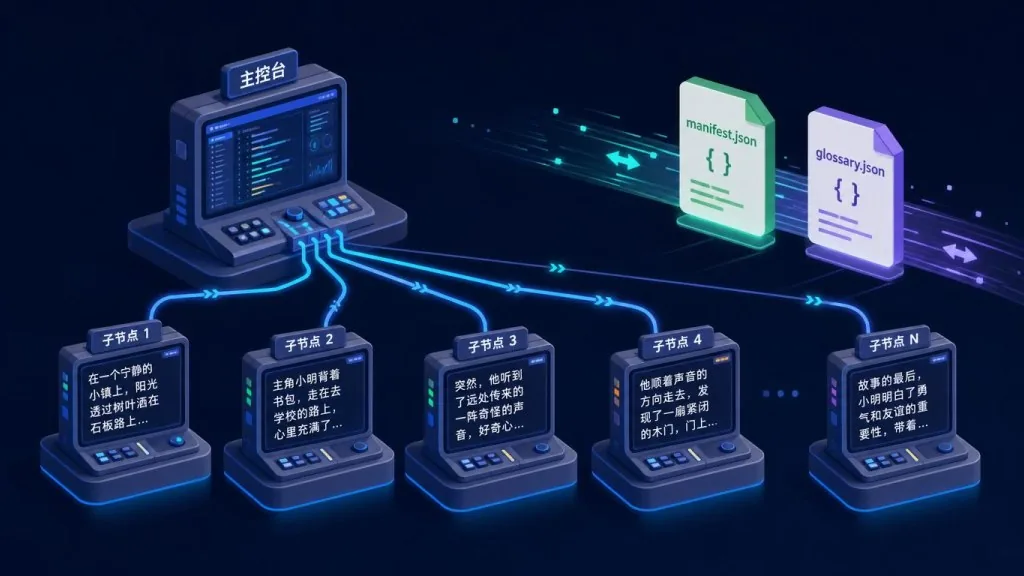
传统方式把整本书塞进一个会话,模型上下文一长就会丢失早期细节。translate-book 把书切成约 6000 字符的 chunk,每个 chunk 交给一个全新上下文窗口的子智能体翻译,默认 8 路并发,batch 化以避开 API 限流。每个子智能体只看自己的源文件和少量邻居片段(每个相邻 chunk 截取约 300 字符作为只读上下文,用于代词和实体消歧),然后写出 output_chunk0042.md 和 output_chunk0042.meta.json。上下文不堆积,输出不被截断,翻译长书不再是赌博。
2. 术语表 v2 解决"翻译漂移"
100 个 chunk 各自翻译,同一个专有名词很可能飘成几种译法。流水线在翻译前先采样 5 个 chunk 自动抽取专有名词和领域术语,生成 glossary.json;orchestrator 用 scripts/glossary.py print-terms-for-chunk 把"原文/别名/译文"三列表注入每个 chunk 的提示词作为硬约束。v2 还引入 id、aliases、gender、confidence、evidence_refs、notes,并强制同一表层形式(source 或 alias)不能指向两个不同术语。改一个术语后,run_state.json 会精确记录哪些 chunk 用过这条术语,只重译受影响的部分——不必重跑全本。
3. SHA-256 清单校验+可恢复
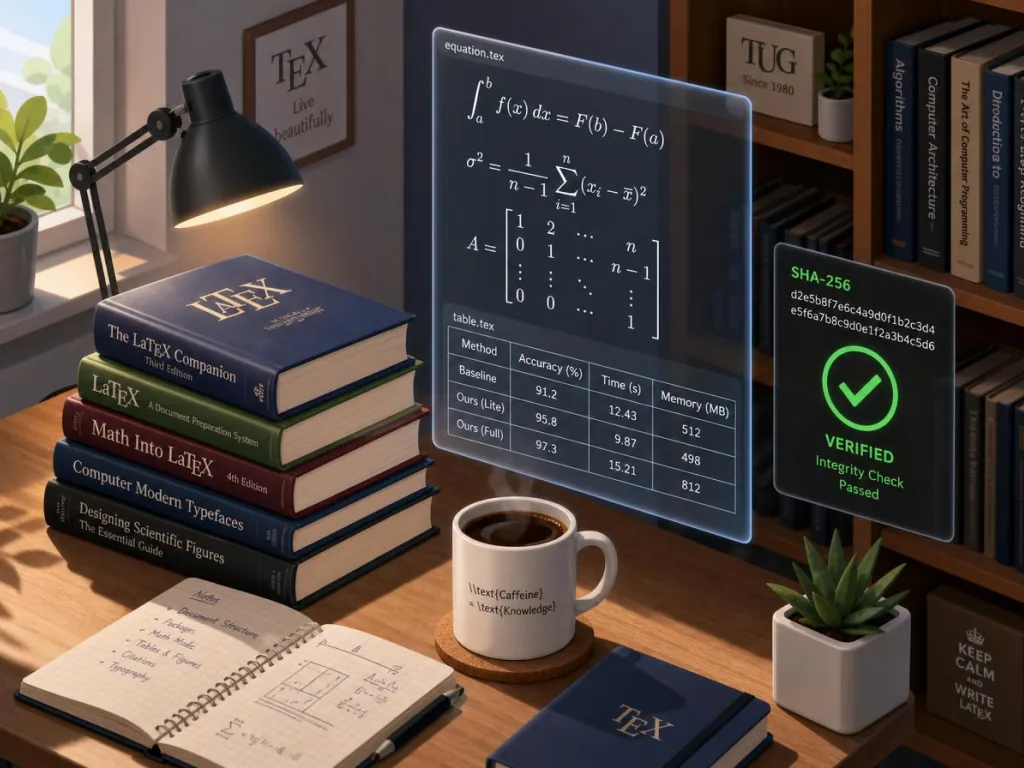
manifest.json 记录每个源 chunk 的 SHA-256 哈希,合并前 1:1 校验源-输出匹配,再加 source_fingerprint.json 把临时目录和源文件字节绑定——替换了源文件重新跑会自动中止而不是悄悄复用陈旧 chunk。运行中断后再跑自动跳过已完成 chunk;空 chunk 单独 abort 而非静默丢弃;--retranslate-untracked 强制把旧产物按当前术语表过一遍。
4. 多格式输出与公式/表格 PDF 友好处理
输出端走 Pandoc HTML(注入浮动 TOC)→ Calibre → DOCX/EPUB/PDF 全家桶。对公式和表格密集的学术 PDF,默认 Calibre 按坐标 reflow 会把它们拆碎,README 推荐先用 MinerU(≥4.0)或 Marker 提取成 Markdown 再喂给 convert.py,公式以 $...$ / $$...$$ LaTeX 完整保留,显示数学块永不被切穿 chunk,Pandoc 在渲染时把它们转成 MathML 写入 HTML/PDF。
四、技术亮点与性能数据
- 并发度可配:默认 8 个子智能体并发,可在 batch 层调整平衡速率与质量。
- 零共享状态冲突:明确的设计原则是"scripts 做账本、LLM 做语义合并",
glossary.json与run_state.json由主 agent 单写,子智能体只写各自的 meta 文件,无锁。 - 三种 Layer、三个文件:
glossary.json(规范、被读)+output_chunkNNNN.meta.json(原始观察)+run_state.json(编排)三层解耦。 - 三阶段渐进治理:Phase 1 已上线 sub-agent 反馈闭环与术语表合并,Phase 2 已上线邻居上下文消解代词,Phase 3 已上线基于
run_state.json的 selective rerun;Phase 4 bootstrap 暖启动仍 gated 在真实数据。 - Calibre + Pandoc 成熟生态:复用行业级文档转换工具而非自造轮子,避免重复解析 PDF/EPUB 的兼容性陷阱。
- 页码自动清理:单调递增的页码序列(1,2,3…)会被自动剔除,年份(1984)、章节号、引用索引作为离群值保留;
--strip-page-numbers提供激进模式。
五、适用场景与人群
具体场景:
- 想系统翻译一本英文技术书/教材到中文,但舍不得读完,也不想一章一章手动拼接;
- 学术论文(公式表多)想用 MinerU/Marker 预先提取再批量翻;
- 多语种电子书团队需要把同一原版快速出中文/日文/韩文/法文/德文/西班牙文版本(已内置 zh/en/ja/ko/fr/de/es 且可扩展)。
适合谁: 已经在用 Codex/Claude Code/OpenClaw 写代码、愿意让 Agent 多走几步的开发者;出版/本地化小团队的工程化负责人;需要定期消化长 PDF 的研究者。
不适合谁: 只想翻一两页的轻量需求(直接用浏览器翻译更省事);完全没有 Calibre/Pandoc 安装权限且不愿折腾的环境。
六、竞品对比
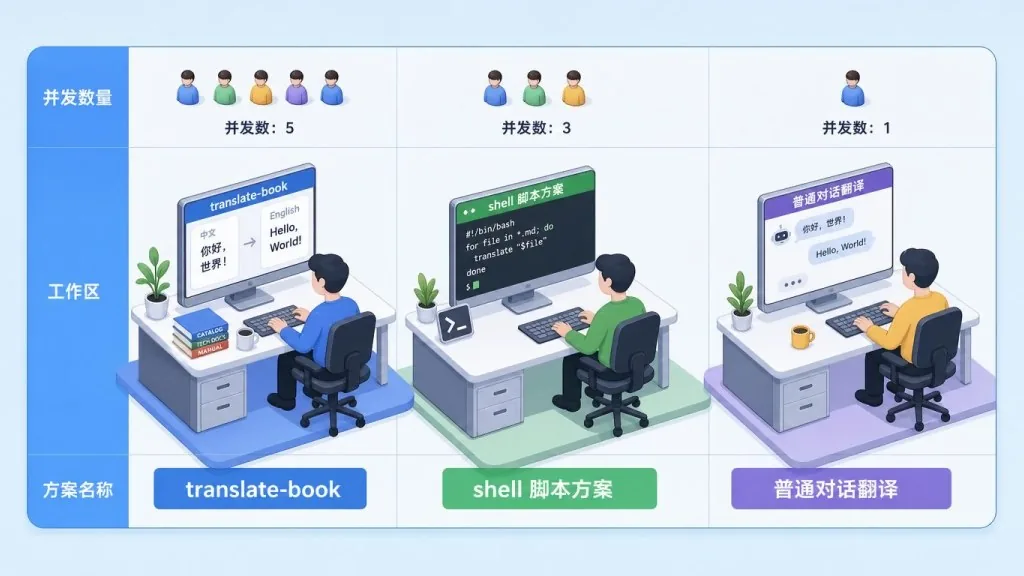
| 维度 | translate-book | 原 claude_translater | 普通聊天式逐段翻译 |
|---|---|---|---|
| 入口形态 | Agent Skill(Codex/Claude Code/OpenClaw) | Shell 脚本 + 多个 step 脚本 | 单次对话窗口 |
| 并发翻译 | 默认 8 路子智能体 | 串行为主 | 串行/手动 |
| 上下文管理 | 每 chunk 全新窗口 + 邻居片段 | 单会话累积 | 单会话累积 |
| 术语一致性 | v2 术语表 + selective rerun | 无 | 无 |
| 校验机制 | SHA-256 清单 + source fingerprint | 无 | 无 |
| 输出格式 | HTML(带浮动 TOC)/DOCX/EPUB/PDF | 单一 | 通常单一 |
| 可恢复性 | run_state.json 精确续跑 | 部分 | 需手动 |
| 公式/表格 PDF | 推荐 MinerU/Marker 预处理,按 LaTeX 保留 | 不支持 | 不支持 |
相比之下,translate-book 把"翻译整书"从艺术活变成了工程活,每一步都有可校验的工件。
七、如何快速上手
1. 准备依赖
- 安装 Agent 运行时(Codex / Claude Code / OpenClaw)并登录;
- 安装 Calibre(提供
ebook-convert命令); - 安装 Pandoc;
pip install pypandoc,建议再装pip install beautifulsoup4改善 TOC。- 公式/表格 PDF 再装 MinerU 或 Marker(首次跑会下载约 0.8GB 模型)。
2. 安装 Skill
- Codex:
npx skills add deusyu/translate-book -a codex -g - Claude Code:
npx skills add deusyu/translate-book -a claude-code -g - OpenClaw:
openclaw skills install @deusyu/translate-book
或手动 git clone 到 ~/.agents/skills/ 等对应目录后重启。
3. 触发翻译
Codex CLI/扩展:$translate-book Translate /path/to/book.pdf into Chinese.
Claude Code/OpenClaw:translate /path/to/book.pdf to Japanese,或 /translate-book translate /path/to/book.pdf to Japanese。
4. 拿到产物
所有产物在 {book_name}_temp/:output.md(合并译稿)、book.html(带浮动 TOC)、book.docx、book.epub、book.pdf。
进阶建议
- 学术 PDF 先用 MinerU 提取成
.md再喂给convert.py --olang zh; - 改标题/封面/语言时删掉旧的
output.md、book*.html、book*.docx、book.epub、book.pdf后再合并; - 自定义封面用
merge_and_build.py --cover cover.jpg,别名导出用--export-name "translated-title"; - 想清理页码脚注,对 Calibre 输入加
--strip-page-numbers。
八、总结与行动建议
translate-book 的核心价值,是把"翻一本书"从被上下文长度支配的一次性工作,升级成可拆分、可并发、可校验、可恢复的多智能体流水线。它把工程里最烦的三件事——术语一致性、长上下文截断、重复劳动——一次性都解决了。
如果你手头正好有一本想读但一直没时间读的长文档,或者团队需要批量本地化电子书,先用一本短的试试完整流程,确认术语表和输出格式符合预期后再上硬菜。仓库地址:https://github.com/deusyu/translate-book ,给作者一个 ⭐ 也是对这条独立项目线的有力支持。
#translate-book #TranslateBook #deusyu #AI智能体 #AI工作流 #自动化 #开源项目 #GitHub