选择标题(3 选 1)
读《史记》还在手动跳转?试试这个让 57 万字活过来的知识库
史记知识库:14,065 个实体、3,198 个事件,把两千年前的文字变成可推理的数据库
没写一行传统程序,AI 用 103 份 SKILL 文档「读懂」了整部《史记》
一、开篇:别再手动折腾它了
读《史记》,你想查一个人物的全部事迹,得翻十几篇本纪世家;想看清一段史实的来龙去脉,得在 130 章间反复跳转;想从 57 万字里找出项羽和刘邦的所有交叉点,只能靠记忆和纸笔。更扎心的是——这套笨办法,专家们已经重复了一千多年。
二、项目简介:它到底是什么?
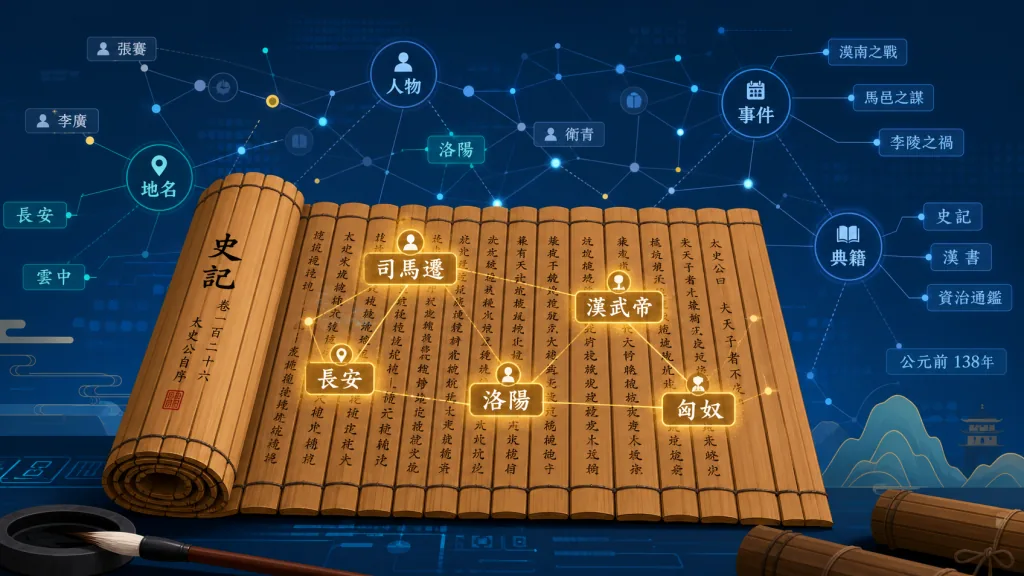
shiji-kb(史记知识库) 是一个把《史记》57.7 万字完整结构化的开源知识工程。它的核心定位是:用 AI 把两千年前的文言文,转化为可交互、可推理、可程序化查询的知识图谱,并公开所有管线方法论。
截至 2026-05-14,项目已沉淀 14,065 个实体、126,441 次标注、3,198 个历史事件、7,637 条事件关系,配套 Wiki 突破 20,830 页,知识量 K ≈ 810,000。这不是又一个把古文搬上网页的电子书,而是把《史记》当作数据源,做成了一套可推理的「历史数据库」。
三、核心功能深度解析
1. 22 类实体语法高亮
阅读器对原文做 NER 标注,把人名、地名、官职、邦国、氏族、典籍等 18 类名词和军事、刑罚、政治、经济 4 类动词全部高亮。点击「项羽」直接跳转人物页,点击「会稽」跳地名页—— 阅读体验类似现代 IDE 的符号跳转,对文言文阅读是质的提升。
右上角齿轮按钮可关闭高亮,专注纯阅读,偏好持久化保存。
2. Purple Numbers 段落编号
致敬 Doug Engelbart:每个段落都有唯一编号,可以精确引用、分享、跳转。这套编号体系让《史记》的任何一句话都能像代码行号一样被定位—— 是后续所有标注、事件抽取、AI 反思能稳定工作的基础设施。
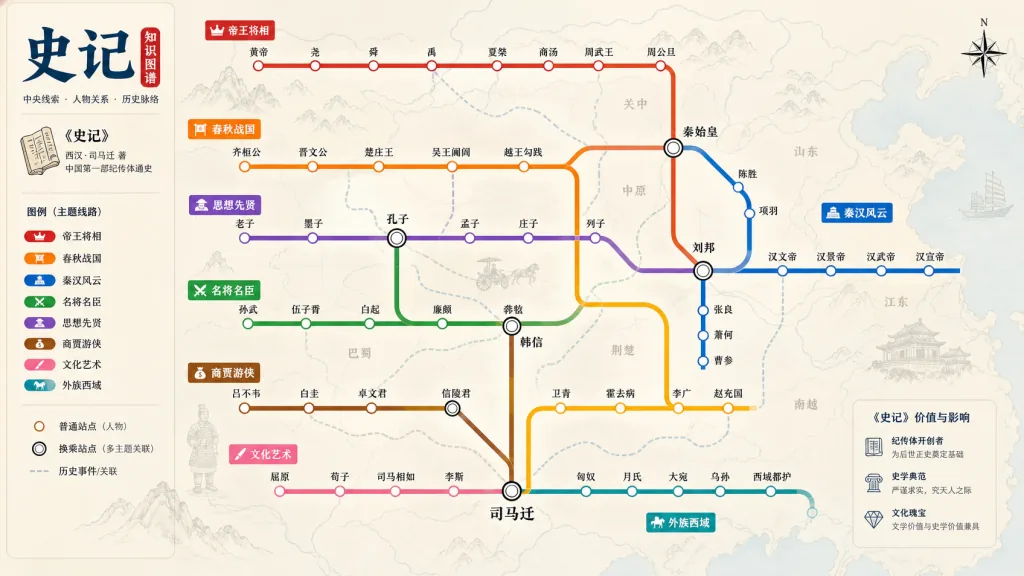
3. 史记地铁图
130 条线路 × 3,197 个站点的可视化图谱,支持缩放、拖拽、搜索、时间线切换。把朝代、人物、事件当成地铁线路—— 楚汉相争就是 2 号线和 3 号线的换乘站。这种图谱化呈现,让跨章的人物关系网一眼可见。
4. Butler Agent 与 Wiki 维护
知识库 Wiki 由自主 AI agent(butler)按轮次维护,每轮执行一个原子操作,每 23 轮批量提交一次。已累计运行 12,000+ 轮(R121→R12,000),覆盖 stub 新建、精品扩写、引文核验、断链修复、premium 升级等全类型操作。配套三层反思机制:W5 流程反思、W9 图式反思、W11 类型审计。
四、技术亮点与性能数据
Agentic Ontology 新范式:传统本体构建从空白开始,自上而下,迭代周期数周;本项目从原始文本自下而上涌现,迭代周期压缩到数小时,规模达数千类、数万实例。这是 AI 时代知识工程的方法论升级。
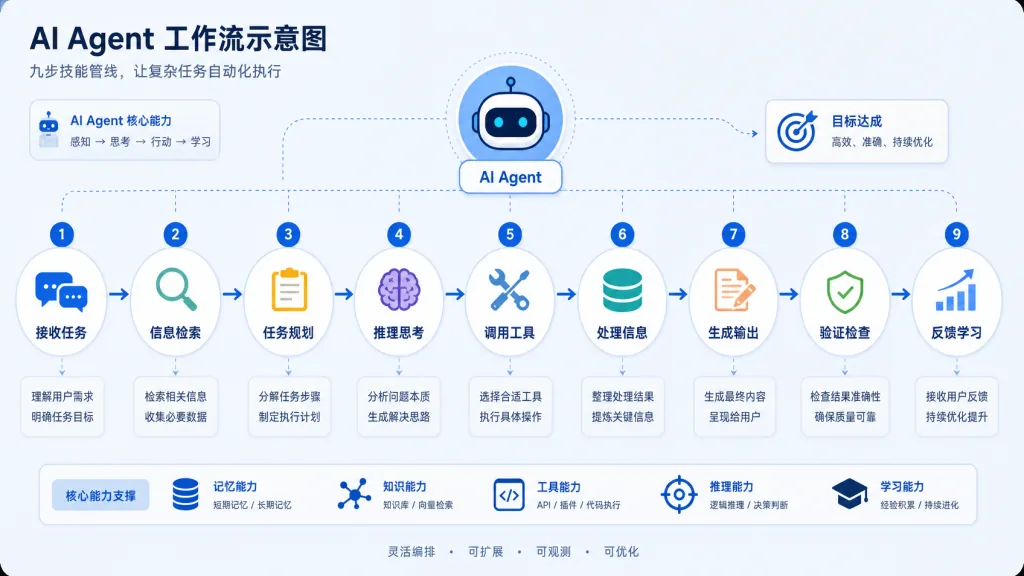
SKILL 驱动而非代码驱动:管线不是 if-else,而是 103 份结构化自然语言 SKILL 文档(14 个元技能 + 89 个管线技能)。这套架构让史学研究者无需懂编程就能挑战和改进规则,让《汉书》《资治通鉴》处理时方法论可直接迁移。
质量保障体系:90% 准确率的 AI 标注 + 5 轮反思,总耗时 5 天,成本约 200 元;人工从零标注 57 万字估计需要 6-12 个月—— 速度提升约 100 倍。累计修正 ~28,000 处标注错误,规律库已达 134 条。
生态兼容:数据以 CC BY-NC-SA 4.0 发布,分析脚本 MIT 许可,原文公有领域。已规划对接 CHGIS(中国历史地理信息系统)和 Neo4j 图数据库。
五、适用场景与人群
历史爱好者:语法高亮阅读 + 一键跳转 + 人物关系图谱,从此告别 Ctrl+F 大海捞针。
学术研究者:矛盾检测、史料溯源、系统化推理—— 北大考古学生已在《中国史学史》课堂上试用并反馈。
内容创作者:历史小说/播客/短视频的素材引擎,案例 EP02《AI 侦探:荆轲死了,秦始皇不说,那谁说的》就是从知识图谱到音频叙事的完整实践。
AI 工程师:古籍知识工程方法论、Agent 工作流参考—— 这套 SKILL 架构可复用到任何编年史料。
不适合:只想看白话文翻译的休闲读者、对 AI 生成内容零容忍的考据派。
六、竞品对比
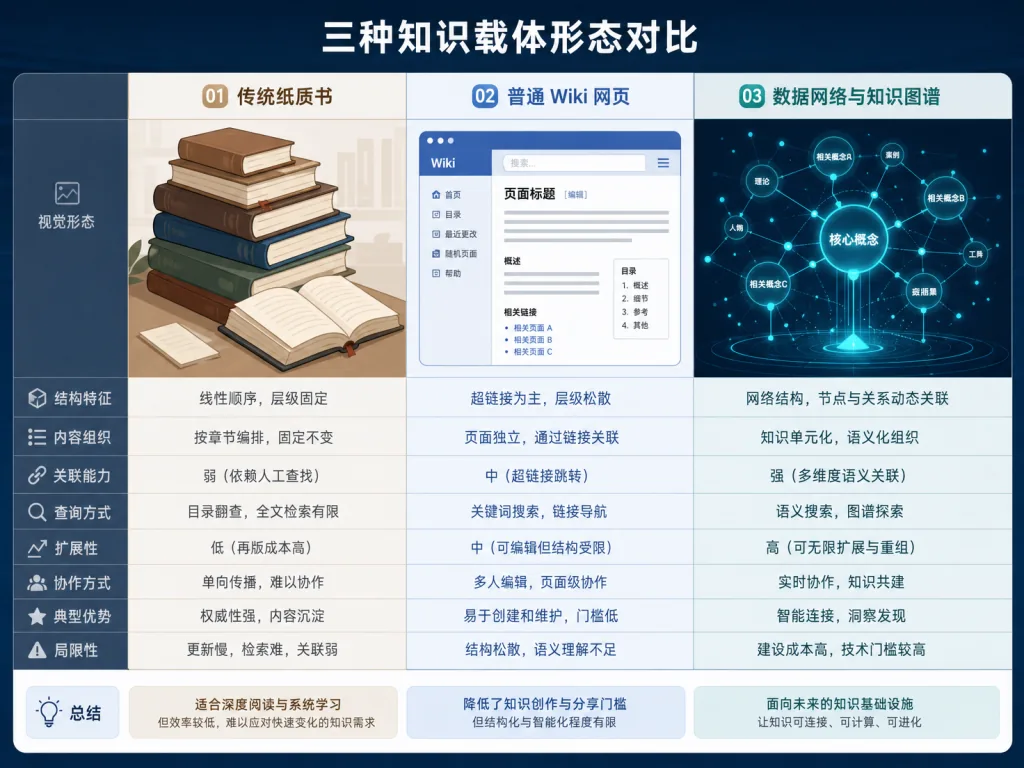
| 维度 | 传统电子书(中华书局点校本等) | Wiki 化古文项目(维基文库等) | shiji-kb |
|---|---|---|---|
| 实体标注 | 无 | 无 | 22 类、12.6 万次 |
| 事件结构化 | 无 | 无 | 3,198 个、98.7% 标注公元纪年 |
| 关系推理 | 无 | 弱链接 | 7,637 条、9 种类型 |
| 矛盾检测 | 无 | 无 | 跨 130 篇自动扫描 |
| 方法论可迁移 | 不涉及 | 不涉及 | 103 份 SKILL、可复用 |
| 开放协议 | 商业版权 | CC BY-SA | CC BY-NC-SA + MIT |
核心差异:shiji-kb 不是「更好的电子版《史记》」,而是「可推理的《史记》数据库」+ 「可复用的古籍处理方法论」。
七、如何快速上手
方式一:在线体验
- 主站:baojie.github.io/shiji-kb
- 备用站(国内更快):shiji.memify.wiki
- 推荐章节:《项羽本纪》《刺客列传》《孔子世家》
方式二:本地运行 Wiki
git clone https://github.com/baojie/shiji-kb.git
cd shiji-kb
python3 wiki/server/serve.py wiki/public 8000
# 浏览器打开 http://localhost:8000
方式三:复现整套管线
按 SKILL 索引(skills/INDEX.md)的顺序,从 SKILL_01_古籍校勘.md 读起,搭配《史记语法高亮创造过程》等文档,逐步理解九步管线。
进阶建议:先读《Agentic Ontology 101》理解方法论,再读 14 元技能合集 PDF(425 页),最后挑感兴趣的管线技能深挖。
八、总结与行动建议
shiji-kb 的核心价值,是把两千年前的文言文变成可推理的数据资产,并用一套可迁移的 SKILL 架构,让每一部新古籍的处理成本递减。
使用建议:
- 历史爱好者直接访问主站,从《项羽本纪》开始体验地铁图;
- 学术研究者先看「矛盾分析」和「史源推理实验室」的 12 个深度案例;
- AI 工程师重点读 Agentic Ontology 文档和 pipeline.svg 大图。
项目链接:
- GitHub:github.com/baojie/shiji-kb
- 在线阅读:baojie.github.io/shiji-kb
- Wiki:baojie.github.io/shiji-kb/wiki/
- 问题反馈:GitHub Issues(推荐截图 + 一句话描述)
一句话安利:这是第一个把《史记》当作数据源而非文本去工程化处理的开放项目—— 它不止让你读懂两千年前的故事,更让你看清机器如何从文言文里「推理」出隐藏的历史规律。
#shiji-kb #ShijiKb #baojie #开源项目 #GitHub