选择标题(3 选 1)
Context window 又爆了?这个开源代理让你用 100K 跑出几十亿 token 会话
5× 砍 token、零窗口违规:billion-context 把 AI 编程会话延长到几个月
不换模型、不换客户端:billion-context 怎么把 Claude Code 的会话拉到 187 亿 token
billion-context:让 100K 小窗口跑出几十亿 token 的会话
一、开篇:为什么你需要这个工具?
写一个稍复杂一点的项目,让 Claude Code 或 Codex 连续干活几个小时,context window 就开始报警。提示收费蹭蹭上涨,会话质量断崖式下滑,再多聊几轮就 out of context。这是一线 AI 编程用户每天都在踩的坑。
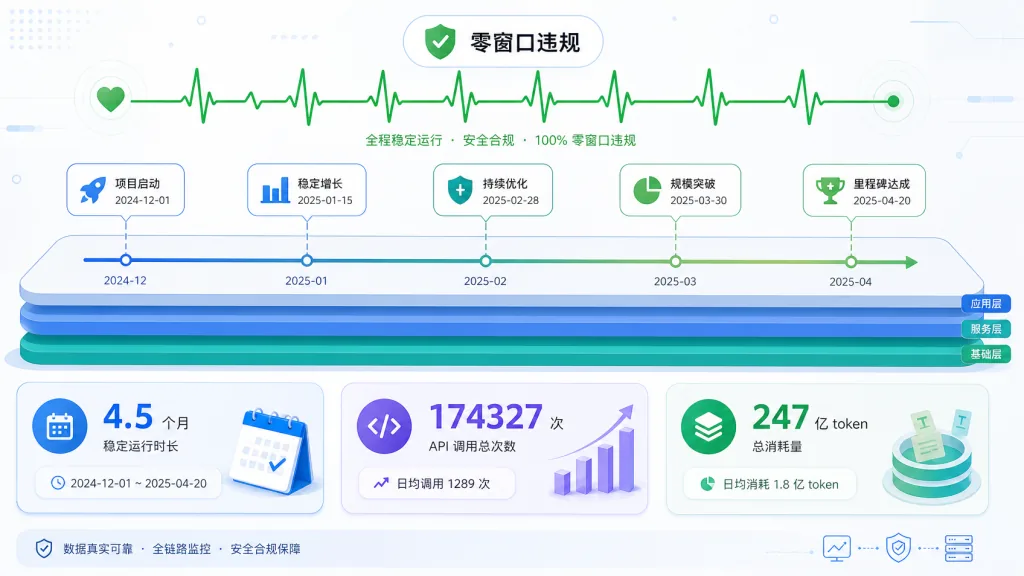
billion-context 直接瞄准这个痛点:用增量分层压缩,把已消费的对话折叠成高质量摘要塞回历史,单会话能跑 174327 次模型调用、累计 187.6 亿输入 token,并且全程不撞 204800 的窗口上限。
二、项目简介:它到底是什么?
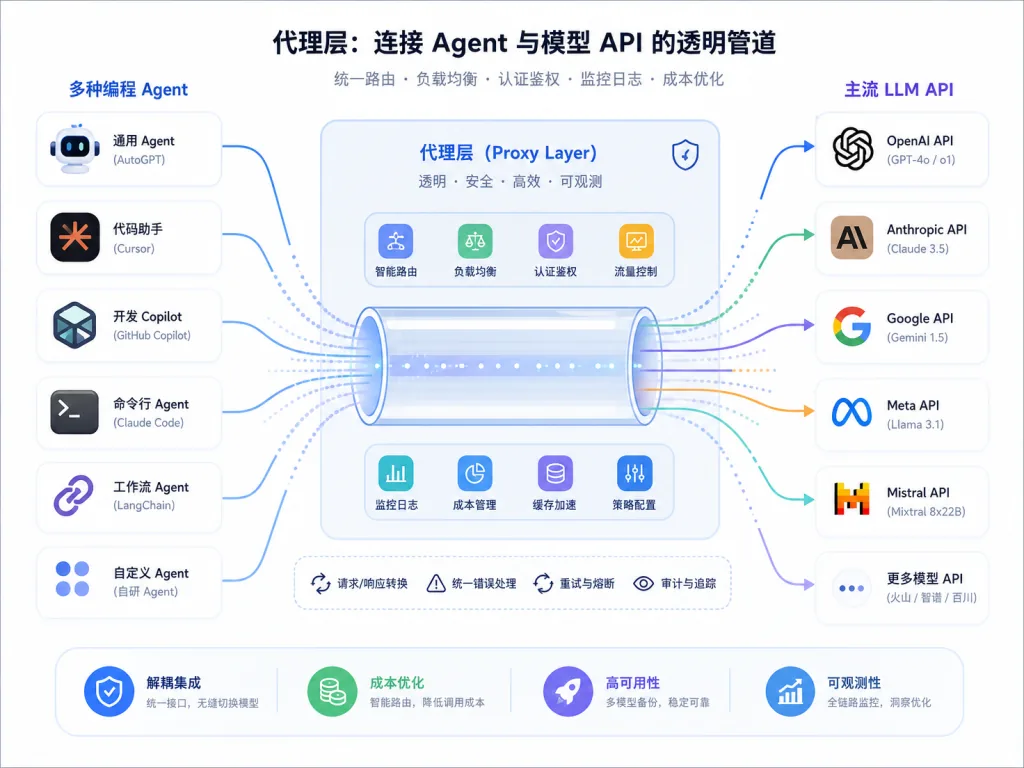
billion-context 是一个位于 Agent 和模型 API 之间的透明代理层,写在 TypeScript 里,核心仓库是 ranxianglei/billion-context,目前 GitHub Stars 1858。它把任何 Agent(Claude Code、Codex、Cursor、Aider、OpenCode、Pi、Kimi 等 20+ 客户端)发出的 Anthropic / OpenAI 流式请求拦截下来,跑一次内核级压缩再转发给真实模型 API,对上层完全无感。
四个关键词足以概括它的核心能力:
- 小窗口够用:100K context 即可承载。
- 省 5 倍 token:官方数据是 5× fewer tokens。
- 超长会话:单会话跨月,横跨数十亿 token。
- 高保真压缩:可逆、可解压、Prefix-cache 友好。
三、核心功能深度解析
1. 增量分层压缩(增量、可逆、Prefix-cache 友好)
这是 billion-context 与各家内置 summarizer 最不一样的地方。它把已消费的对话按小范围折叠成摘要层,而不是一刀切截断。需要细节时,模型可以调用 decompress 把对应范围还原;不需要时再调用 compress 折叠回去。摘要写入始终保持前缀稳定,前缀缓存命中率能维持 95–97%,压缩自身只占 ≤2%。
相比硬截断,这种方式既不丢信息,又不打断缓存,对长时编程 Agent 极其友好。
2. 模型自主决策压缩时机(四大工具随用随调)
代理层会向模型注入四个 context-management 工具,由模型自己判断何时调用:
compress:把一段对话折叠成摘要。decompress:需要精确细节时还原压缩段。search_context:跨摘要与可见消息的关键词检索。acp_status:一览 context 占用与可压缩范围。
把压缩决策权交给模型,比固定阈值触发更贴合实际工作流。
3. 通用代理位置(不绑死任何 Agent)
billion-context 坐在任意 Agent 与模型 API 之间,识别 Anthropic 与 OpenAI 两种请求形状,透明改写流式响应。它兼容 20+ 主流客户端:Claude Code、Codex、OpenCode、Pi、omp、dsh、Kimi、Hermes、Z.ai、Codebuddy、Qoder、Trae、Gemini CLI、Qwen Code、GitHub Copilot CLI、Zed、Aider、Antigravity 都在支持矩阵内。
这意味着换 Agent 不必换压缩方案。
4. 三种启动方式各取所需
它给了三种接入姿势,按改造深度递增:
- 原生插件:
bili plugin install <client>,插件长在客户端里,零启动命令。 - Launcher:
bili <client>一行启动,不改任何配置文件。 - URL 改写:把 baseURL 前缀换成
http://localhost:8787/bili/,最通用的兜底方案。
四、技术亮点与性能数据
billion-context 的论文(paper/ 目录随仓库开源,MIT 协议)报告了一项生产级纵向研究:4.5 个月、3 台主机、174327 次模型调用、累计 187.6 亿输入 token(跨主机合计 247 亿),零次窗口违规,单次马拉松会话 8584–12049 次调用。
架构层面,核心创新点有三:
- 模型驱动压缩:何时压、压什么由模型自己决定,不是硬截断阈值。
- Prefix-cache 友好:摘要保持前缀稳定,缓存命中率长期 95–97%。
- 可逆压缩层:折叠可恢复,不会丢掉细节,回头调
decompress就能取回。
它自带的健康检查端点 curl http://localhost:8787/__bili/health、__bili/stats 也能实时观察上游路由和压缩活动。
五、适用场景与人群
适用场景:
- 长时间跑 Agent 的开发:跨小时甚至跨天的编程会话,必须控制住 context 增长。
- Token 成本敏感的团队:5× fewer tokens 直接砍掉 API 账单。
- 在多 AI 客户端间切换的用户:一份压缩方案覆盖 20+ 工具,不必逐个适配。
适合谁: 每天重度使用 Claude Code / Codex / Cursor 的全栈工程师、需要把 Agent 跑进 CI 的平台团队、追求单会话长记忆的研究者。
不适合谁: 只是偶尔问一句"帮我写个正则"的轻度用户、完全没有 Agent 使用经验的小白、需要非 OpenAI/Anthropic 协议直连的边缘场景。
六、竞品对比
| 项目 | 是否改写请求流 | 自动压缩决策 | Prefix-cache 友好 | 客户端覆盖 |
|---|---|---|---|---|
billion-context | 透明代理 | 模型自主 | 是(95–97%) | 20+ |
| 各家 Agent 内置 summarizer | 否 | 固定阈值 | 通常不友好 | 仅本客户端 |
| 自建压缩脚本 | 需自己实现 | 需自己实现 | 需自己实现 | 单客户端 |
billion-context 的差异点在于:把压缩做成可逆分层、交给模型决策、不绑死单一客户端,并且保持缓存高命中率。
七、如何快速上手
一行命令安装(无需 sudo):
npm install -g billion-context --prefix=~/.local
把 ~/.local/bin 加入 PATH(多数发行版默认就有),然后挑一种姿势:
最省事——原生插件:
bili plugin install pi          # pi
bili plugin install claude      # Claude Code
bili plugin install opencode    # OpenCode
最通用——URL 改写:
bili    # 启动代理
# 把客户端 baseURL 改为 http://localhost:8787/bili/<原 URL>
验证代理在线:
curl -s http://localhost:8787/__bili/health
# → {"ok":true,"upstream":"https://api.anthropic.com"}
进阶建议:先在 bili start 后用 __bili/stats 看一眼压缩活动,确认命中再放开使用。
八、总结与行动建议
billion-context 把"小 context 窗口跑不动长会话"这件事正面解决了:增量、可逆、Prefix-cache 友好的压缩由模型自主决策,4.5 个月的实数据已经证明了它的稳定性。
如果你的日常工作流正在被 context window 和 token 费用双重挤压,不妨给它一次机会——一行安装,三种启动方式任意挑,20+ 客户端任选其一接入。
项目地址:github.com/ranxianglei/billion-context,论文与 FAQ 都在仓库 paper/ 目录里,欢迎拿真实工作流去验证。
#billion-context #BillionContext #ranxianglei #开源项目 #GitHub