一、开篇:新接的服务,又是一周接入工作
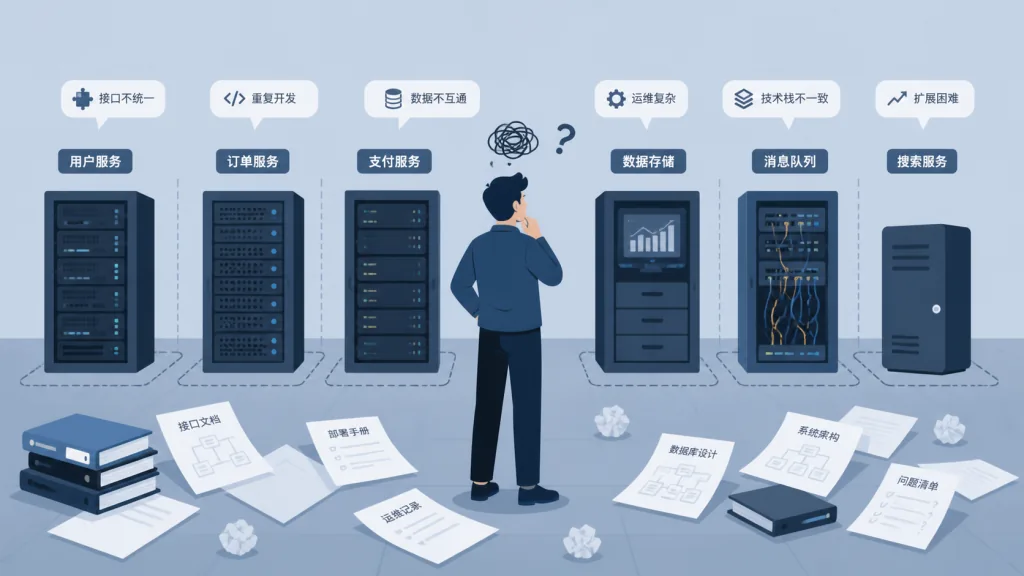
刚接手一个新项目,你打开 Confluence 翻「接入文档」:消息队列要配 Kafka 消费者,HTTP 网关要写路由,定时任务要单独部署一个调度器,状态存储要接 Redis,观测要埋点 OpenTelemetry,AI Agent 又要单独的运行时沙箱……每个能力都像一座孤岛,光是把它们连起来就要好几天。
更让人崩溃的是「可观测性」:A 团队用 Jaeger、B 团队用 Datadog、C 团队连日志都没接全。出了问题要跨四个系统拼调用链,时间都花在排查上而不是写业务。
这种「每个新能力 = 一套新集成」的痛点,在中大型后端团队几乎每天都在上演。iii 这个用 Rust 写的开源项目,正是冲着这件事来的。
二、一句话看懂:这是个什么项目
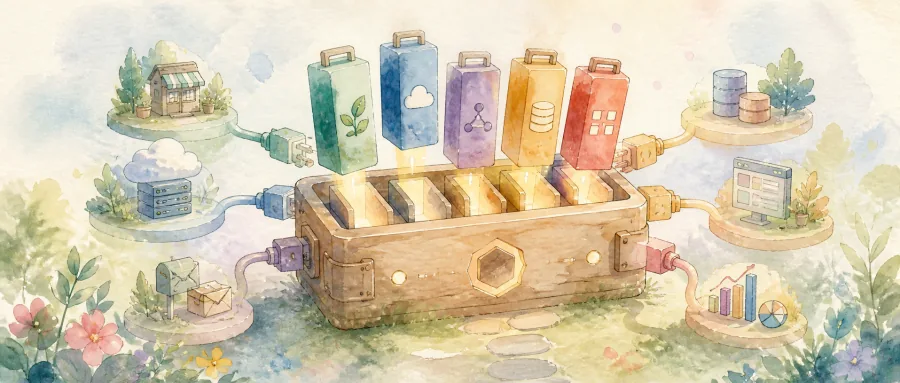
iii 是 GitHub 上斩获 18.5K Stars 的实时服务编排引擎,核心卖点用一句话讲清楚:把消息队列、HTTP、定时、状态、流、Agent、可观测性这些能力,全部装进一个可热插拔的运行时。
- 核心定位:零集成(zero-integration)的实时服务总线
- 三大原语:Worker(进程)· Function(函数)· Trigger(触发器)
- 多语言 SDK:Node.js、Python、Rust、Go 全覆盖
- 里程碑:18,595 Stars,Docke、NPM、PyPI、Crates.io 全平台分发
三、核心功能深度解析
1. 三个原语,覆盖所有后端场景
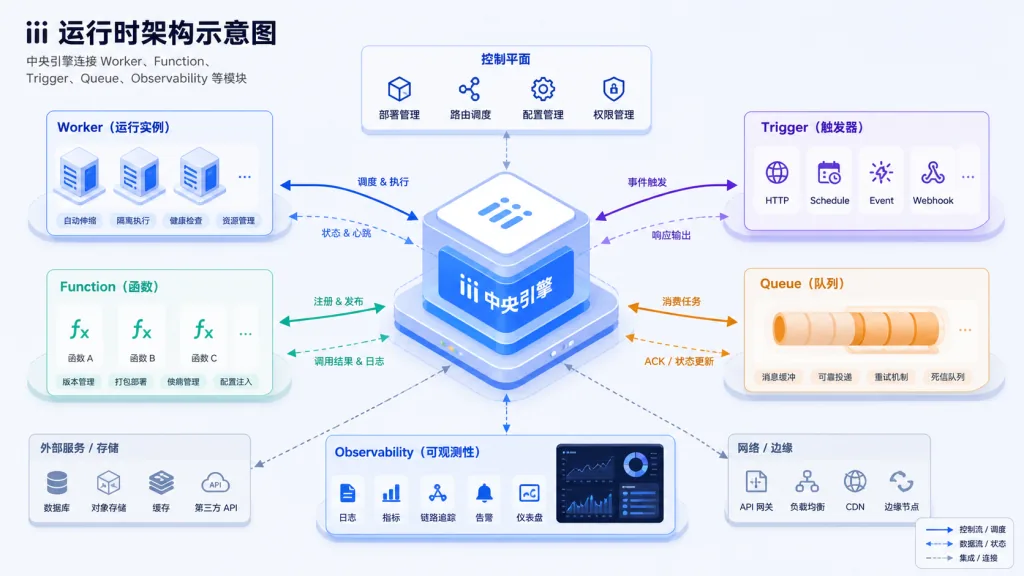
iii 的全部心智模型就是 Worker · Function · Trigger。
- Worker:任何能跑代码的进程都能注册成 Worker。TypeScript API 服务是 Worker,Python 数据管道是 Worker,Rust 微服务也是 Worker。甚至 Worker 可以在运行时创建新 Worker,这是 Agent 自我扩展的基础。
- Trigger:任何能「导致函数运行」的事件。可以是直接函数调用、HTTP 端点、cron 调度、队列订阅、状态变更、流事件。Worker 只需声明式写「这个函数响应这个事件」,路由、序列化、投递全部由 iii 引擎处理。
- Function:带稳定 ID 的工作单元,命名类似
content::classify、orders::validate,输入输出有契约。
映射到代码长这样:
iii worker add queue
iii worker add agent
iii worker add observability
一行命令注册一个能力,注册瞬间全系统可见、可调用、可追踪。
2. iii worker add 一行命令扩展
过去引入一个新观测工具,要写无数胶水代码;现在一句 iii worker add observability,能力就进入系统,且天然带着 Trace。引入新队列也是一样——iii worker add queue 搞定,不用走供应商评估、采购、几周接入的老路。
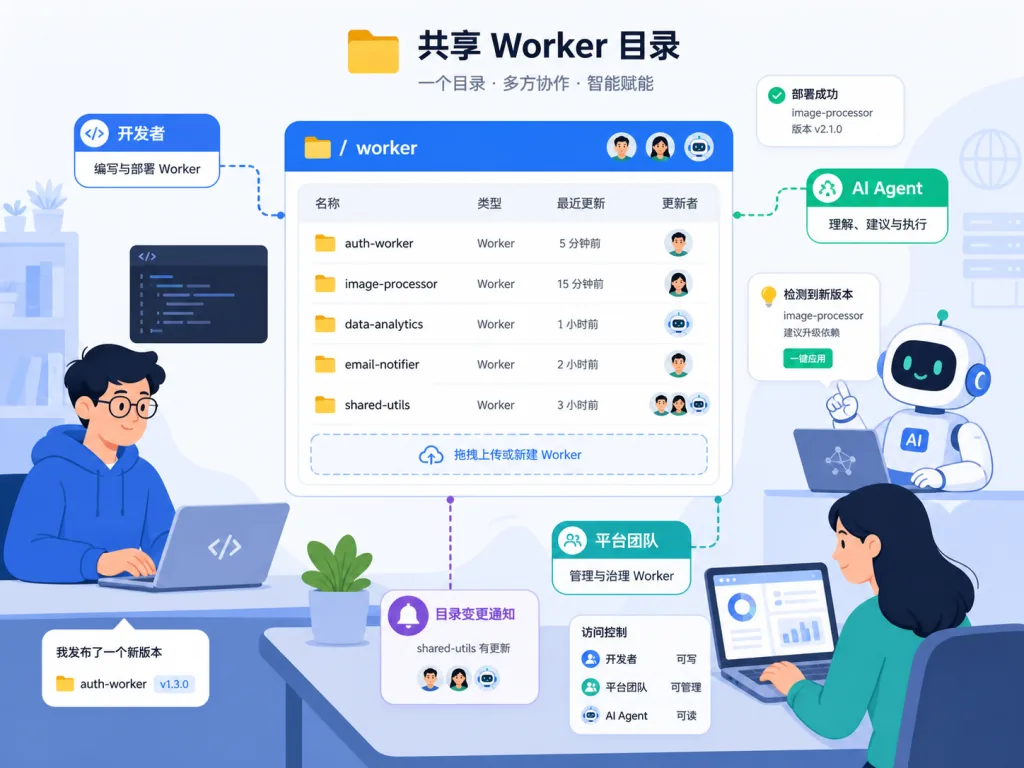
平台团队发布 Worker,应用团队注册 Function 并声明 Trigger,Agent 用同一个目录、同一种函数调用方式——三种角色共享同一套接口。
3. Agent 原生可调用
当一个 Agent 任务需要系统暂时没有的能力时,它能自己加一个 Worker、发现其函数、调用它、追踪调用结果——和开发者用的是同一个接口。这意味着 Agent 不再被锁死在「预先集成好的能力清单」里,可以运行时自我扩展。
4. 实时观测开箱即用
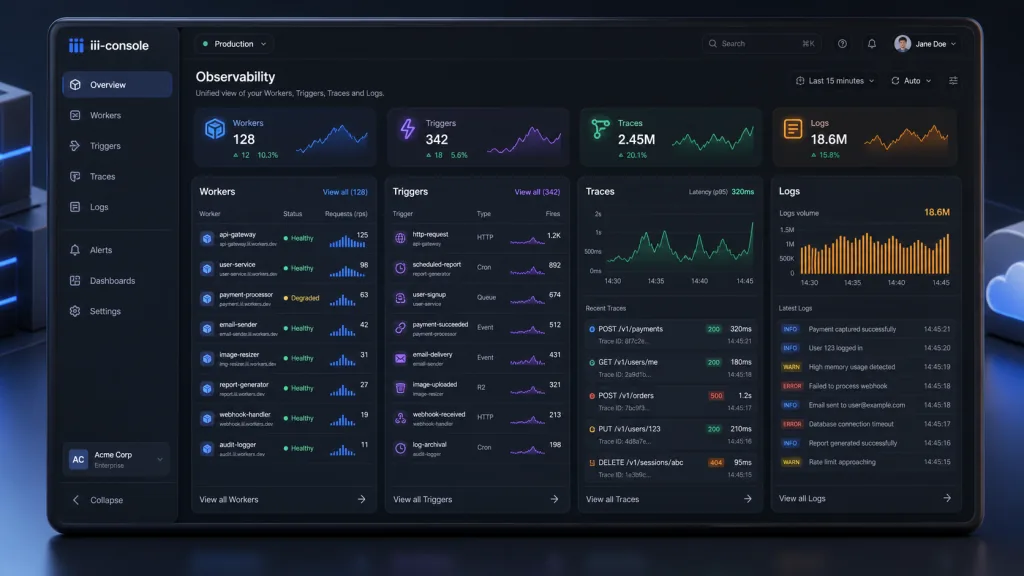
iii-console 是一个 React + Rust 写的开发运维控制台,能直接查看 Workers、Functions、Triggers、Queues、Traces、Logs 和实时状态。「打开 Trace 就能观测」不是口号,是字面意思。
四、技术亮点与性能数据
- Rust 引擎核心:engine 目录是整个运行时,性能与内存安全由 Rust 保证,长期跑服务不用担心 GC 抖动。
- 声明式 Trigger:Worker 只声明「这件事发生时跑这个函数」,路由、序列化、重试、投递全部由引擎层处理,业务代码完全不知道底层是 HTTP 还是队列还是 cron。
- Agent Skills 协议:通过
npx skills add iii-hq/iii/skills给 Agent 安装可读的参考材料,覆盖 HTTP、queues、cron、state、streams、自定义 trigger 等所有原语。每个 Worker 还附带自己的 Skill,相当于给 Agent 配了「说明书」。 - 全语言 SDK:Node.js(
pnpm add iii-sdk)、Python(pip install iii-sdk)、Rust(crates.io)、Go(go get),任意语言写出的服务都能注册为 Worker。 - 生态兼容性:提供 Docker 镜像、CLI、Console、官方文档站 iii.dev,部署从单机开发到容器编排都能跑。
五、适用场景与人群
- 场景一:多服务、多能力的中后台系统。一个项目里既有 Web API、又有定时任务、又有 AI Agent、又有消息队列,iii 可以把它们装进同一个运行时统一观测。
- 场景二:Agent 平台开发。想让 Agent 运行时按需加载能力,iii 的「Worker 自创建」+「Agent Skills」天然契合。
- 场景三:平台团队 / 基础设施团队。要发布一组可复用能力给业务团队使用,iii 的 Worker 目录模型就是为此设计。
适合谁:中大型后端团队、Agent 平台搭建者、希望统一可观测性的架构师、喜欢 Rust 生态的工程师。不太适合:单一语言单体应用的小项目,或者对 Elastic License 2.0 有顾虑的闭源商业产品(注意:engine 部分是 ELv2 协议,SDK 和 Console 是 Apache 2.0)。
六、竞品对比
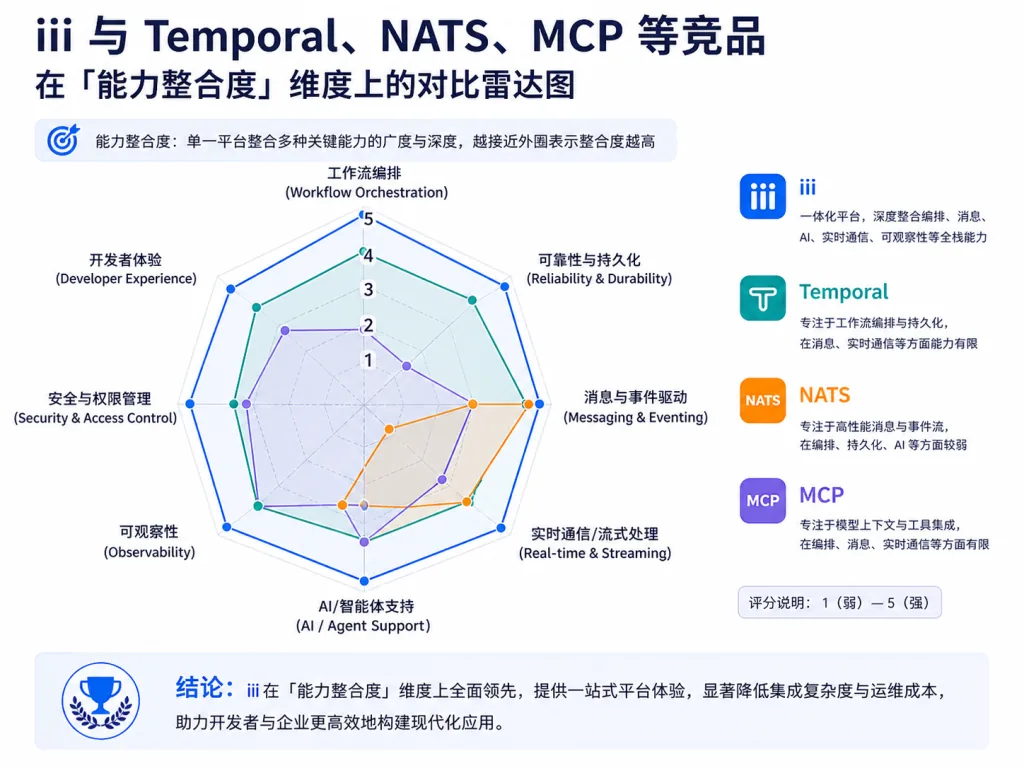
| 项目 | 定位 | 与 iii 的区别 |
|---|---|---|
| Temporal | 工作流编排引擎 | 强在工作流事务,但每个能力(队列、HTTP、cron)仍要单独集成 |
| NATS / RabbitMQ | 消息中间件 | 解决通信,但 Worker 注册、Trigger 声明、可观测性都要自己拼 |
| MCP (Model Context Protocol) | Agent 工具协议 | 偏 Agent 工具调用语义,没有提供 Worker/Trigger 运行时 |
| iii | 实时服务总线 + 原语化 | 把队列、HTTP、cron、state、Agent、observability 全装进一个可热插拔运行时 |
一句话:iii 不是替代某一个中间件,而是替代「多个中间件 + 一堆胶水代码」的组合。
七、如何快速上手
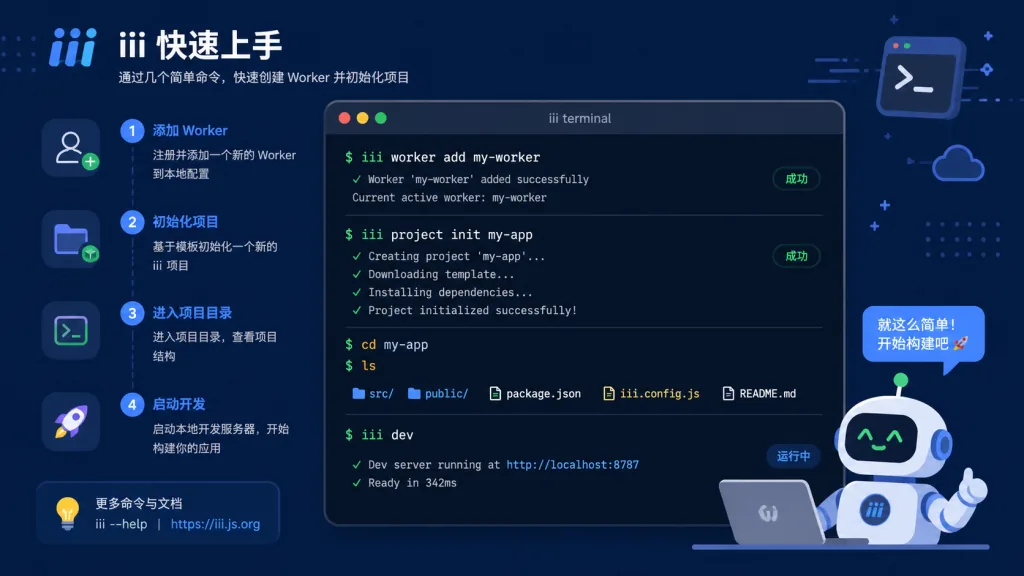
1. 一行命令安装 CLI
curl -fsSL https://install.iii.dev/iii/main/install.sh | sh
2. 脚手架建项目并启动引擎
iii project init myapp
cd myapp
iii
引擎启动后,进入 iii worker add 添加能力即可。
3. 接入第一个 Worker(Node.js 示例)
pnpm add iii-sdk
写一个 worker.ts,用 SDK 注册 Worker、声明 Trigger 和 Function,启动后它就会出现在 iii-console 里,可以被其他 Worker 或 Agent 直接调用。
4. 给 Agent 装上 Skills
npx skills add iii-hq/iii/skills
npx skills add iii-hq/workers --all
这样 Claude、Cursor 等 Agent 就能「读懂」iii 的所有原语,并主动调用或扩展。
5. 进阶建议
- 先把
iii-queue、iii-state、iii-http、iii-observability这几个内置 Worker 跑起来感受一下。 - 用 iii-console 看 Trace,验证「可观测性开箱即用」是否真如宣传。
- 后续可参考 iii-examples 仓库搭建复杂业务。
八、总结与行动建议
iii 的核心价值可以浓缩成三句话:用三个原语统一后端能力,用一行命令扩展运行时,用一份 Trace 看到全链路。对那些还在为「接入一个队列就要写三天胶水代码」头疼的团队,iii 提供了一种范式级别的解法。
使用建议:
- 先用 Quickstart 在本地跑起来,加两个内置 Worker 看效果。
- 在团队内选一个中等复杂度的服务做试点,把它的 HTTP、cron、队列迁移到 iii。
- 验证可观测性收益后再决定是否全栈推广。
项目地址:
- GitHub:https://github.com/iii-hq/iii
- 官网与文档:https://iii.dev
- Worker 市场:https://workers.iii.dev
一句话安利:如果你受够了每个新能力都要重新集成一遍,iii 这种「把后端能力装进可热插拔运行时」的思路,值得花一个下午亲手试一下。