选择标题(3 选 1)
MiniCPM5-2B 凭什么让 2B 模型反杀 4B?
平均分 53.9,MiniCPM5-2B 把端侧 LLM 推到 2B 级新 SOTA
没堆参数却超过 4B,MiniCPM5-2B 把端侧推理重新洗了一遍牌
端侧大模型天花板再被掀:MiniCPM5-2B 用 2B 参数干翻了一众 4B 对手
一、开篇:你的笔记本还跑不动大模型吗
开发者在本地跑 7B 模型,常常卡在显存这道关:单张 4090 装不下,量化后又损失精度。更大的模型基本告别消费级硬件,只能租云端 API,可响应延迟、网络依赖、数据隐私又让生产环境用得心里发慌。OpenBMB 给出的答案是——把 2B 模型的极限再往上推一档。MiniCPM5-2B 在与 LFM2.5-2.6B、Qwen3.5-2B、Gemma-4-E2B-it 同台对垒的同时,平均分 53.9 超过了自家对比列表里所有 4B 级对手(最高的也只有 51.1)。换句话说,在 2B 体量上,它做到了开源 SOTA。
二、项目简介:OpenBMB 的端侧 LLM 矩阵
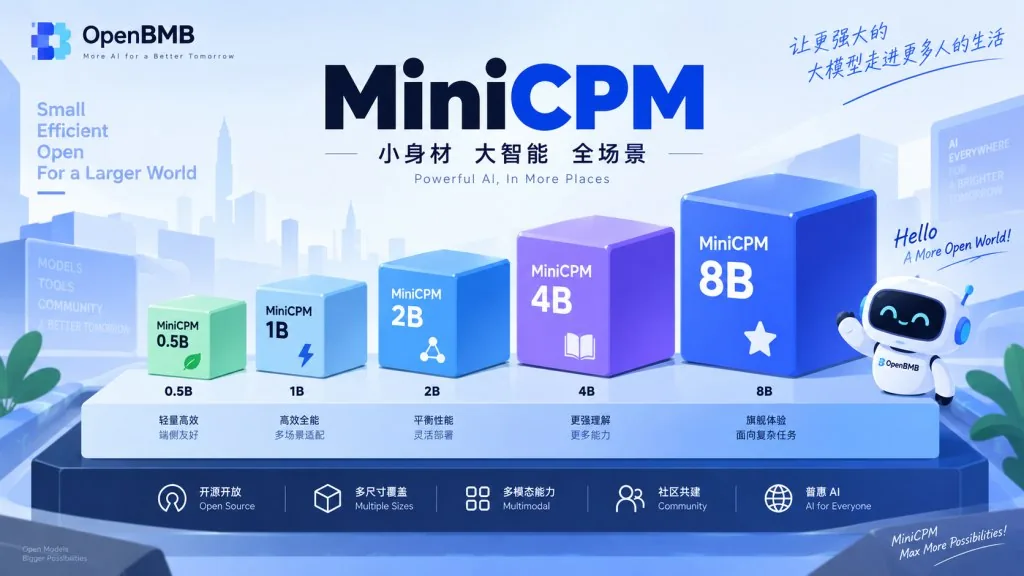
OpenBMB/MiniCPM 是一个专注「小而强」的端侧大模型系列,仓库已经收获 11.4K Stars。当前主推的 MiniCPM5 系列包含 1B 和 2B 两个规格,主打关键词是 2B 级开源 SOTA、UltraData 全栈训练数据、On-Policy Distillation(OPD)后训练,以及覆盖 vLLM / SGLang / llama.cpp / Ollama / MLX / LiteRT-LM 等十余种部署框架的生态兼容性。最新的 MiniCPM5-2B 在 2026.09.07 发布,同期上架 HuggingFace 与 ModelScope,配套还放出了 DSpark 投机解码版本。
三、核心功能深度解析
1. 2B 级 SOTA 性能:跨级碾压
MiniCPM5-2B 采用标准 LlamaForCausalLM 架构,总参数量 2,516,756,480(非嵌入参数约 19.8 亿),42 层,GQA 配置 16 Q / 2 KV,原生支持 131,072 上下文。在官方对比集里,它平均得分 53.9,代码推理、数学推理、长上下文理解、工具调用和多类 Agent 任务上均领先同尺寸模型,对上 4B 级的 Qwen3.5-4B、granite-4.2-3B、Nemotron-3-Nano-4B、Gemma-4-E4B-it、LFM2.5-8B-A1B 也照样领先。这意味着部署者可以用 2B 的显存预算拿到原本需要 4B 才能跑出的效果。
2. UltraData 全栈训练数据
模型不是单点产物,而是一套数据方法论的产物。MiniCPM5-2B 同时开源了四个配套数据集:网页侧的 UltraX 高质量预训练数据、按 L0–L3 分层管理的 UltraData-Code、含 50 万样本的 UltraData-SFT-Agent-2609,以及覆盖数学、代码、通用知识、长上下文推理的 UltraData-RL-2609(80K+ RL 样本)。从预训练到 SFT、RL 的全流程数据全部开放,复现与二次微调门槛被大幅降低。
3. RL + OPD 后训练:把专家模型蒸馏成一个
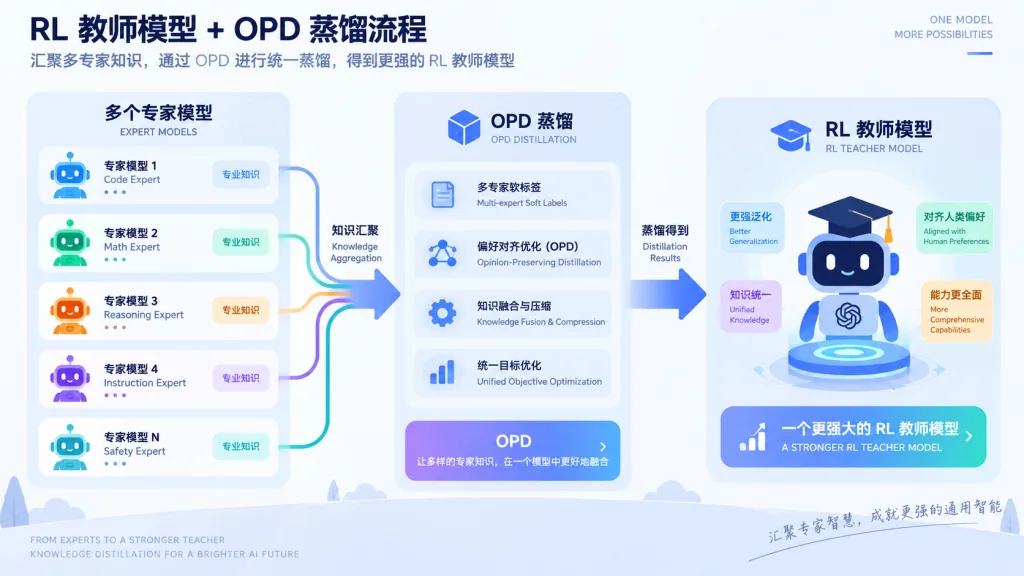
后训练是 MiniCPM5-2B 的关键差异化点。RL 阶段采用 JustRL II 描述的 critic-based 算法,先训出 16 个专家模型(含 5 个 Agent 专家)。OPD 阶段在每个响应位置计算学生与教师 logits 之间的全词表 reverse KL 散度作为 advantage 估计,复用 RL 教师训练时的 prompt 作为蒸馏数据,不再额外造语料。最终在官方基准上,推理与通用能力平均提升 ↑10.96 分,Agent 能力提升 ↑6.96 分。
4. 标准架构 + 全框架兼容
因为采用标准 Llama 架构,没有自定义 kernel、没有 model-code fork,主流推理引擎可以直接加载。官方支持 vLLM、SGLang、Transformers、llama.cpp、Ollama、LM Studio、MLX、ArcLight、LiteRT-LM(含 Android/iOS/IoT)、vLLM Ascend,并通过 FlagOS 社区适配了 Nvidia、海光、MetaX、Iluvatar、Zhenwu、Moore Threads、昆仑芯、昇腾、Armv9 共九种芯片。同一份权重基本可以「一鱼多吃」。
四、技术亮点与性能数据
- 131K 原生长上下文:42 层 GQA 设计在端侧兼顾长度与推理成本。
- DSpark 投机解码:配合
MiniCPM5-2B-DSparkdraft 模型,在 SGLang 启用--speculative-algorithm DSPARK即可加速,输出与原模型完全一致。 - 采样参数推荐:
temperature=1.0, top_p=0.95, min_p=0.0。在 llama.cpp 上要显式把默认min_p=0.05调到 0,否则会过滤掉恰好用来跳出循环的低概率 token。 - 工具调用:SGLang 是官方推荐后端,配合
--tool-call-parser minicpm5(或auto)即可把 XML 风格工具调用转成 OpenAI 兼容的tool_calls,无需额外解析层。
五、适用场景与人群
- 本地 Coding Agent:在 Mac Studio、单卡 4090 或 Apple Silicon 上跑代码助手,对接 Cursor / Claude Code 类工作流。
- 端侧 AI 助理 / IoT 设备:LiteRT-LM 支持 Android、iOS、桌面、IoT 的
.litertlm运行时,CPU+GPU 都能跑。 - 国产芯片部署:需要快速迁移到非 Nvidia 硬件的团队,可走 FlagOS 多芯片版本,覆盖海光、昇腾、昆仑芯等九款。
- 数据 / 隐私敏感场景:金融、政务、企业内部,希望模型权重与推理都在本地完成。
- 不适合:需要超大模型才能稳定解决的复杂多轮规划任务、依赖超长 CoT 的前沿数学研究,以及对单 token 推理质量要求极致的高端场景。
六、竞品对比
| 维度 | MiniCPM5-2B | LFM2.5-2.6B | Qwen3.5-2B | Gemma-4-E2B-it |
|---|---|---|---|---|
| 官方平均分 | 53.9 | 略低 | 略低 | 略低 |
| 对 4B 模型 | 平均超过 | 部分超过 | 部分超过 | 部分超过 |
| 上下文 | 131K 原生 | 视版本而定 | 视版本而定 | 视版本而定 |
| 端侧框架 | 10+ 官方支持 | 框架覆盖较窄 | 框架覆盖较窄 | 框架覆盖较窄 |
| 多芯片 | FlagOS 9 芯片 | 单一生态 | 单一生态 | 单一生态 |
选择 MiniCPM5-2B 的核心理由:在 2B 尺寸上它是当前开源最强,并且把「模型 + 数据 + 部署 + 国产芯片适配」打包交付,单点功能其它家也能做,整套组合只有它全齐。
七、如何快速上手
最省事的方式是 vLLM 起服务:
pip install "vllm>=0.21"
vllm serve openbmb/MiniCPM5-2B --port 8000
请求侧直接走 OpenAI 兼容接口:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"openbmb/MiniCPM5-2B","messages":[{"role":"user","content":"Who are you?"}],"max_tokens":128,"temperature":1.0,"top_p":0.95}'
要做工具调用,切换到 SGLang 并加上 --tool-call-parser minicpm5;要 CPU / Apple Silicon 推理,用 llama.cpp 或 Ollama 加载 GGUF 即可;要在 Android / iOS 端跑,参考 LiteRT-LM cookbook。微调侧有 TRL+PEFT、LLaMA-Factory、ms-swift、unsloth 四套官方 cookbook 可选。
八、总结与行动建议
MiniCPM5-2B 的核心价值可以一句话概括:把 2B 模型的 SOTA 抬到了超过 4B 模型的高度,并把训练数据、训练方法、部署框架、多芯片适配一次性开源。对端侧 AI 应用开发者,这是当下本地化部署性价比最高的选择之一;对国产芯片生态,它又是一份标准的迁移参考实现。建议先按 vLLM 或 SGLang cookbook 跑通基线,工具调用需求一定要试 SGLang;端侧落地走 LiteRT-LM;非 Nvidia 硬件直接用 FlagOS 多芯片版本,省掉迁移适配成本。
项目地址:https://github.com/OpenBMB/MiniCPM,模型下载走 HuggingFace openbmb/MiniCPM5-2B 或 ModelScope 同名仓库,文档详见仓库内 docs/ 目录。
#minicpm #Minicpm #openbmb #大模型 #LLM #RAG #开源项目 #GitHub