一、开篇:这个痛点,几乎每个 Python 后端都踩过
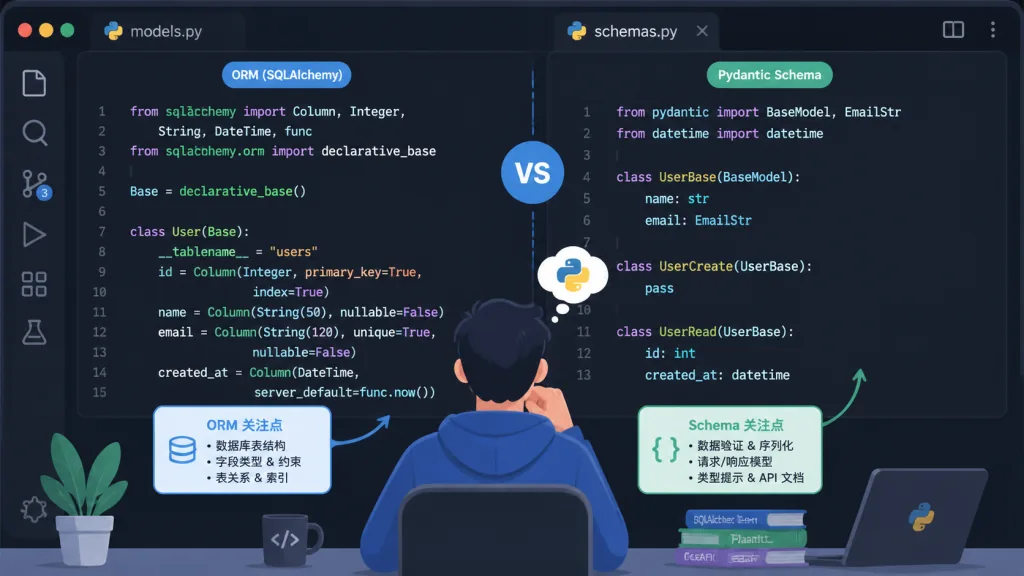
做 Python Web 开发时,你大概率经历过这样的场景:用 SQLAlchemy 定义了一套 ORM 模型,给 FastAPI 写接口时又用 Pydantic 定义了一套 Schema。两套模型字段高度重复,需求变更一次就要同步改两处,还经常漏改一边导致接口报错。
更糟的是新人接手项目,看到 UserInDB、UserORM、UserResponse 三个类字段几乎一样却不能合并,调试半天才发现是类型不一致。这种「一个表三套定义」的割裂感,是 Python 后端开发者共同的痛点。
有没有一种方式,能让 ORM 模型和接口数据模型合二为一?FastAPI 官方团队给出的答案是 SQLModel——GitHub 已收获 18.2K Stars 的明星库。
二、项目简介:用一句话概括
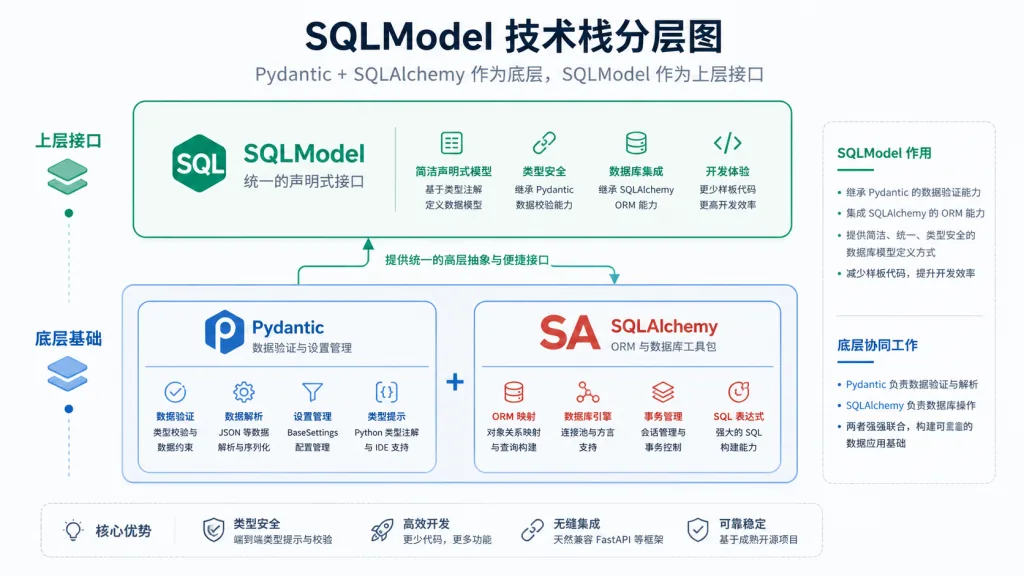
SQLModel 是由 FastAPI 作者 tiangolo 开源的 Python ORM 库,基于 Pydantic + SQLAlchemy 构建,核心理念是「一个类同时充当 ORM 模型、Schema 模型和数据校验模型」。一句话:用更少的代码,做更完整的数据库开发。
- 核心定位:合并 SQLAlchemy 与 Pydantic,消除模型重复
- 关键特性:类型注解驱动、与 FastAPI 原生兼容、完整编辑器支持
- 项目里程碑:18.2K Stars、Pypi 长期维护、FastAPI 生态官方推荐
三、核心功能深度解析
1. 一个类 = 三种模型
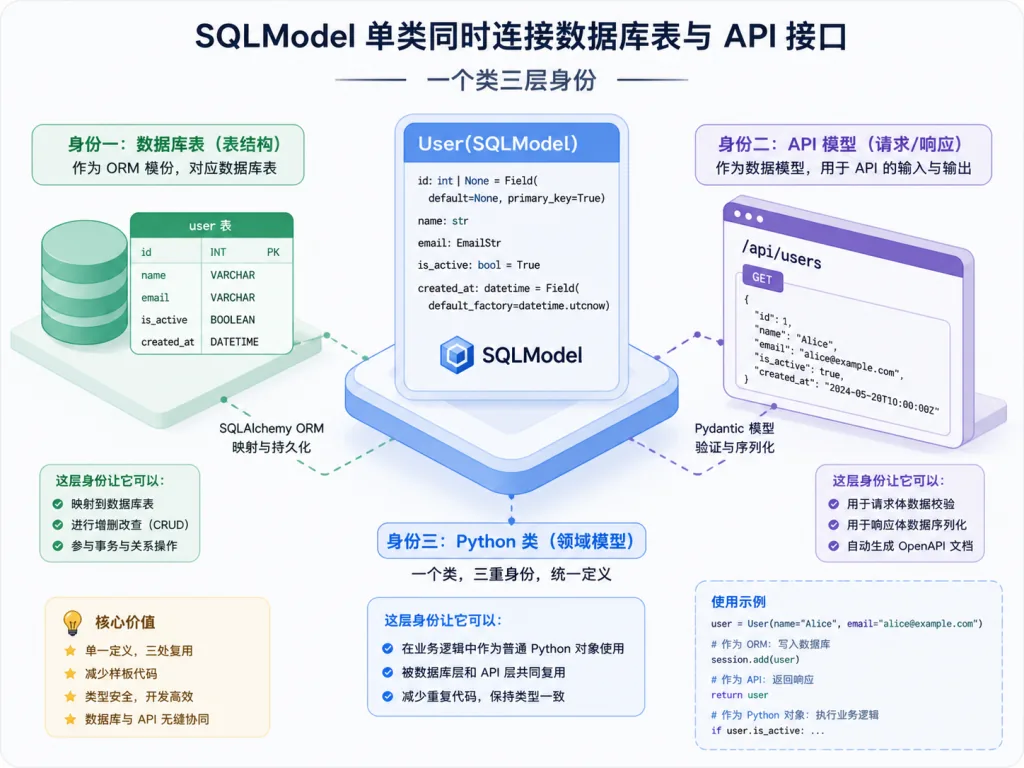
传统开发中你需要定义 ORM 类(SQLAlchemy)、输入校验类(Pydantic)、输出序列化类(Pydantic)。SQLModel 通过让一个类同时继承 SQLModel 并设置 table=True,让同一个类同时承担这三件事。
from sqlmodel import Field, SQLModel

class Hero(SQLModel, table=True):
    id: int | None = Field(default=None, primary_key=True)
    name: str
    secret_name: str
    age: int | None = None
这个 Hero 类既是 SQLAlchemy 的 ORM 模型(生成数据库表),也是 Pydantic 的数据模型(用于 FastAPI 的请求体和响应体校验)。代码量直接砍掉一半,字段一致性靠类型注解保证。
2. 原生兼容 FastAPI
因为底层就是 Pydantic,SQLModel 模型可以直接作为 FastAPI 的 response_model 或请求体类型使用,零额外转换。在 FastAPI 项目里,你甚至可以把数据库返回的对象直接 return 给接口,序列化自动完成。
3. 完整 SQLAlchemy 能力
别担心被「阉割」——SQLModel 是 SQLAlchemy 之上的薄封装,所有原生能力(复杂 JOIN、事务、Session 管理、自定义查询)都保留。你仍然可以用 select()、Session、create_engine() 这些熟悉的 API。
4. 编辑器级开发体验
得益于 Pydantic 的类型注解,VS Code、PyCharm 在写 Hero.age 时能自动补全、写错类型直接红线报错、查询结果 .name 也能补全。这种「写代码像写 Markdown」的丝滑感,是 SQLModel 团队投入最多精力的部分。
四、技术亮点与性能数据
- 底层双引擎:Pydantic v2 负责数据校验与序列化,性能比 v1 提升 5-50 倍;SQLAlchemy 2.0 负责 SQL 生成与连接池管理。
- 零额外运行时开销:薄封装不引入中间层,调用链路与原生 SQLAlchemy 一致。
- 类型驱动:用 Python
int | None这种 PEP 604 语法声明可空字段,IDE 与运行时的校验逻辑同源。 - 生态兼容性:无缝对接 FastAPI、Pydantic、SQLAlchemy 现有项目,可渐进式迁移,无需重写存量代码。
- 广泛数据库支持:通过 SQLAlchemy 支持 SQLite、PostgreSQL、MySQL、Oracle、SQL Server 等主流关系型数据库。
五、适用场景与人群
适合谁:
- 用 FastAPI 写后端、需要对接关系型数据库的全栈/后端开发者
- 受够了「ORM + Schema 双重维护」的中型项目团队
- 想要类型安全、IDE 补全,但不想放弃 SQLAlchemy 灵活性的工程师
典型场景:
- 中小型 Web 应用后端(FastAPI + PostgreSQL/MySQL)
- 内部管理后台快速开发
- 数据接口服务,需要给前端返回强类型数据
不太适合:
- 纯数据分析场景(用 Pandas/SQLAlchemy Core 更合适)
- 已深度依赖 Tortoise ORM / Django ORM 的项目
- 需要极致定制 SQL 的复杂报表系统
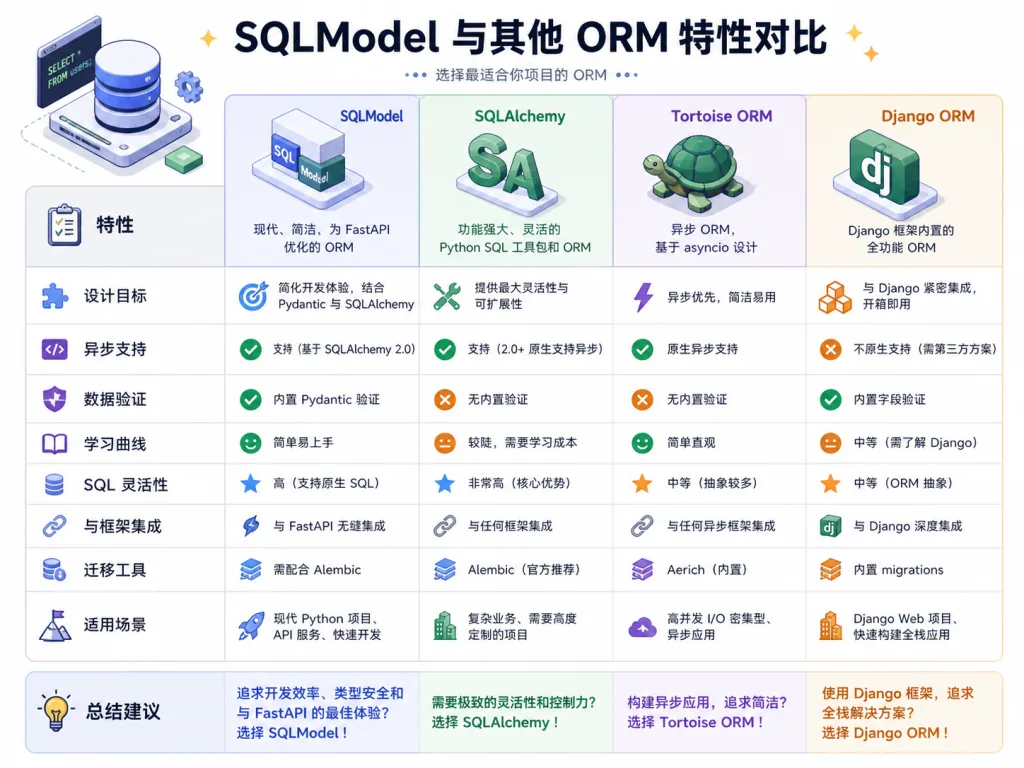
六、竞品对比
| 项目 | 模型层数 | 类型提示 | FastAPI 友好度 | 学习成本 |
|---|---|---|---|---|
| SQLModel | 1 层统一 | 完整 | 原生支持 | 低 |
| SQLAlchemy + Pydantic | 2 层并行 | 需手动同步 | 需额外转换 | 中 |
| Tortoise ORM | 1 层 | 部分 | 需 async 适配 | 中 |
| Django ORM | 1 层 | 弱 | 不兼容 | 高(需学 Django 全家桶) |
相比传统方案,SQLModel 的优势是把「ORM 定义」和「接口数据模型」二合一,省去 40%-60% 的重复代码,并保留 SQLAlchemy 的全部能力。
七、如何快速上手
1. 安装(推荐使用 uv):
uv add sqlmodel
或使用 pip:
pip install sqlmodel
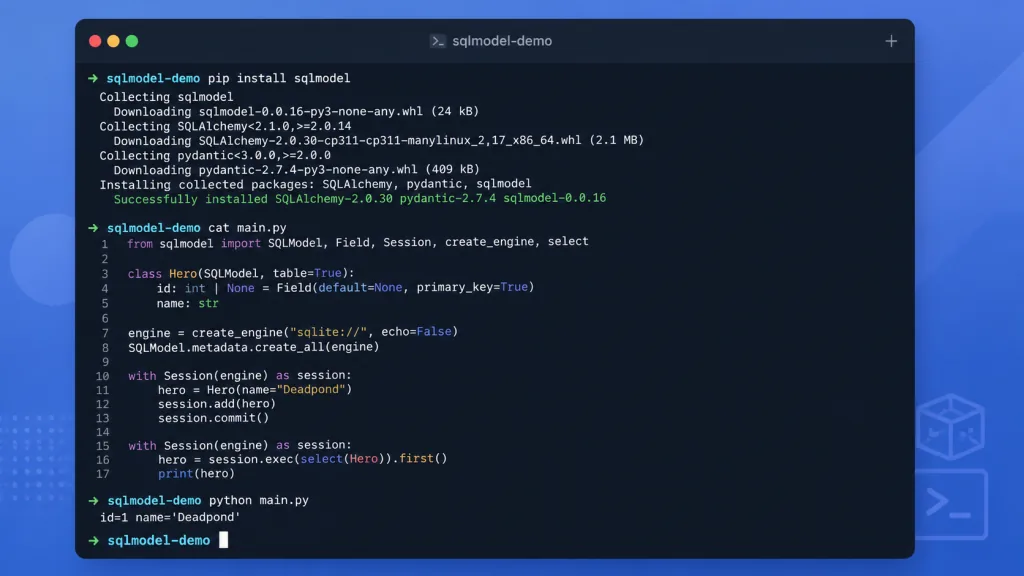
2. 最小可用示例:
from sqlmodel import Field, Session, SQLModel, create_engine, select

class Hero(SQLModel, table=True):
    id: int | None = Field(default=None, primary_key=True)
    name: str
    secret_name: str
    age: int | None = None

engine = create_engine("sqlite:///database.db")
SQLModel.metadata.create_all(engine)

with Session(engine) as session:
    session.add(Hero(name="Spider-Boy", secret_name="Pedro Parqueador"))
    session.commit()

    hero = session.exec(select(Hero).where(Hero.name == "Spider-Boy")).first()
    print(hero)
3. 进阶建议:
- 迁移 PostgreSQL 时,把
create_engine的连接串换成postgresql://user:pwd@host/db即可 - 复杂查询继续用 SQLAlchemy 的
select()链式语法,无需切换思路 - 在 FastAPI 里直接把
Hero类作为response_model,自动完成 JSON 序列化与字段过滤
八、总结与行动建议
SQLModel 的核心价值是「用一个 Python 类,同时承载数据库表、ORM 映射、接口数据校验三层职责」。对于已经在用 FastAPI 的团队,这套方案能把后端数据层代码量压缩近一半,且完全保留 SQLAlchemy 的灵活性。
为什么值得一试:
- 18.2K Stars、FastAPI 官方团队维护,生态活跃度高
- 零迁移成本——存量 SQLAlchemy 代码可以渐进式接入
- 类型注解驱动的开发体验,调试时间显著减少
项目地址:
如果你的项目正在被「重复定义模型」折磨,新建的 FastAPI 服务又需要快速搭起数据库层,SQLModel 是当下最值得尝试的选择。