一、开篇:别再手动折腾它了
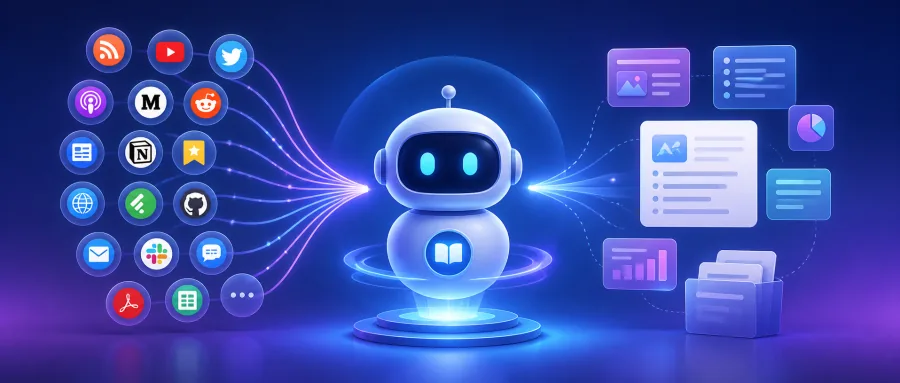
做内容的人,几乎都有过被「格式」卡住的下午:那篇想引用的网页要先复制、再去广告、再丢进 Markdown 工具;那段想二创的 YouTube 视频要靠字幕网站一次次导出;那本微信读书里的划线想整理成清单,却只能一段段粘到备忘录;想看最近 3 天 AI 圈在聊什么,得在 RSS、X、Product Hunt、Hacker News 之间来回切换 8 个标签页。
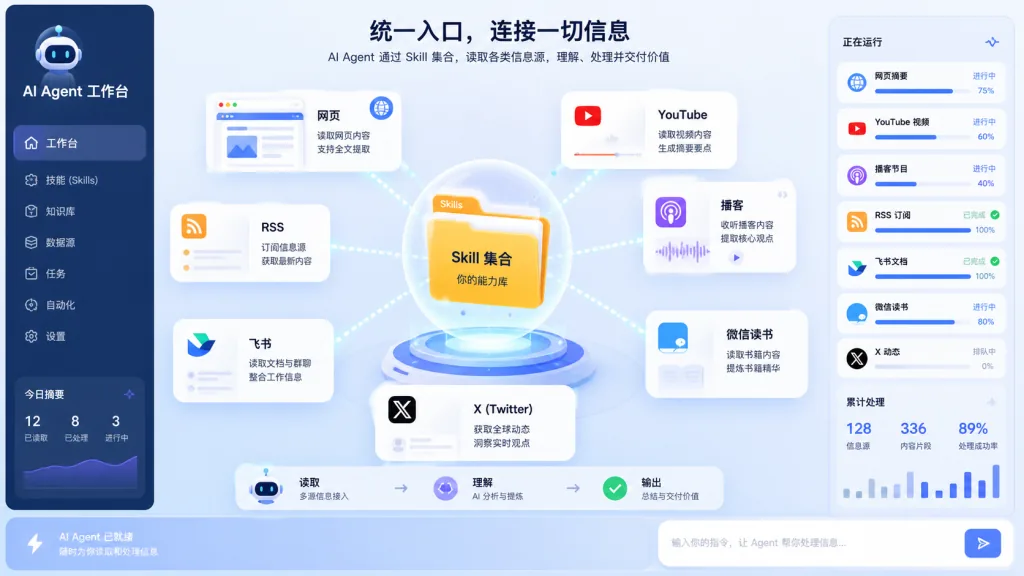
Read Buddy 这个 GitHub 项目(SpaceZephyr/read-buddy,目前 58 Stars)就是冲着这一摊子事来的——它把自己定位成"给 Agent 用的阅读技能包",先帮你把来源内容拿回来,再让 Agent 帮你做下一步。目前仓库已经聚集了 20 个独立 Skill,覆盖网页、RSS、YouTube、播客、X、飞书、OCR、微信读书和个人知识源。
二、项目简介:一句话说明它是什么
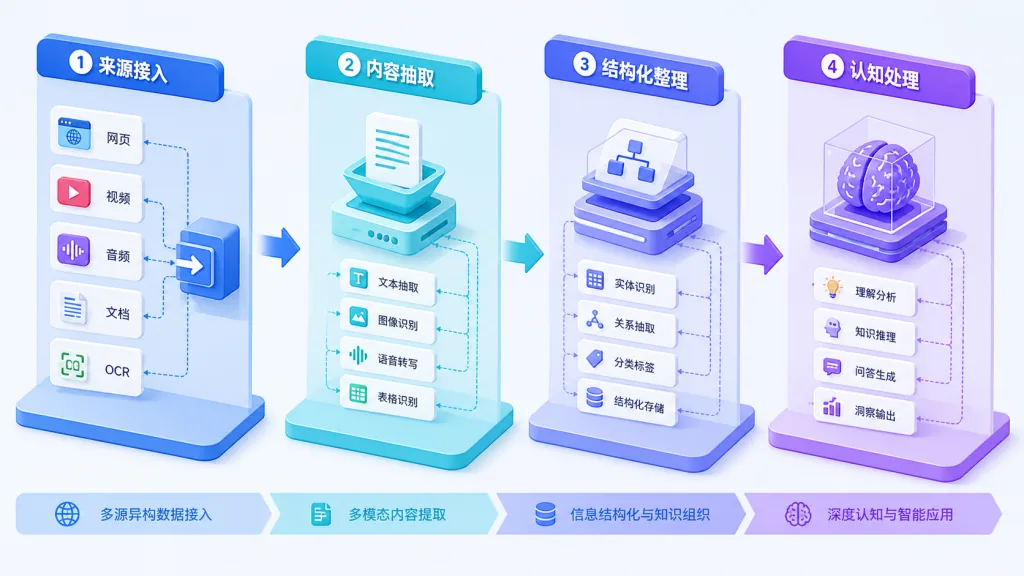
Read Buddy 是一套基于 Agent Skills 协议的「信息读取」Skill 集合,运行在 Claude Code、Codex、Cursor、OpenClaw、Hermes、Gemini CLI、OpenCode 等兼容 Runtime 上。它的核心使命是:把零碎来源(网页、视频字幕、播客音频、X 推文、飞书文档、图片 OCR、微信读书划线)统一转成结构化、可继续加工的 Markdown / JSON / SQLite,再交给 Agent 做摘要、翻译、选题、口播脚本和阅读分析。
三、核心功能深度解析
1. read-url-markdown + read-web-scraper:网页到 Markdown 的两条路
read-web-scraper 是轻量抓取,把 HTML 正文清洗后转 Markdown,适合普通文章页。read-url-markdown 在它之上引入 Chrome CDP,能处理需要登录态等待、JS 渲染、滚动加载的复杂页面。最终输出包含标题、作者、发布时间、正文 Markdown、原文链接和图片引用,并过滤导航、广告、页脚等噪声。
2. read-youtube-transcript + read-youtube-feed:字幕与频道更新
read-youtube-transcript 优先拉取中英文字幕,转成结构化文字稿,保留时间戳和来源;read-youtube-feed 负责抓取指定频道或播客的近期更新。两个 Skill 配合,再把字幕丢给 read-content-digest,就能直接产出观点提炼、短帖、长文和金句。
3. read-rss-aggregator + read-topic-collector:信息流与热点
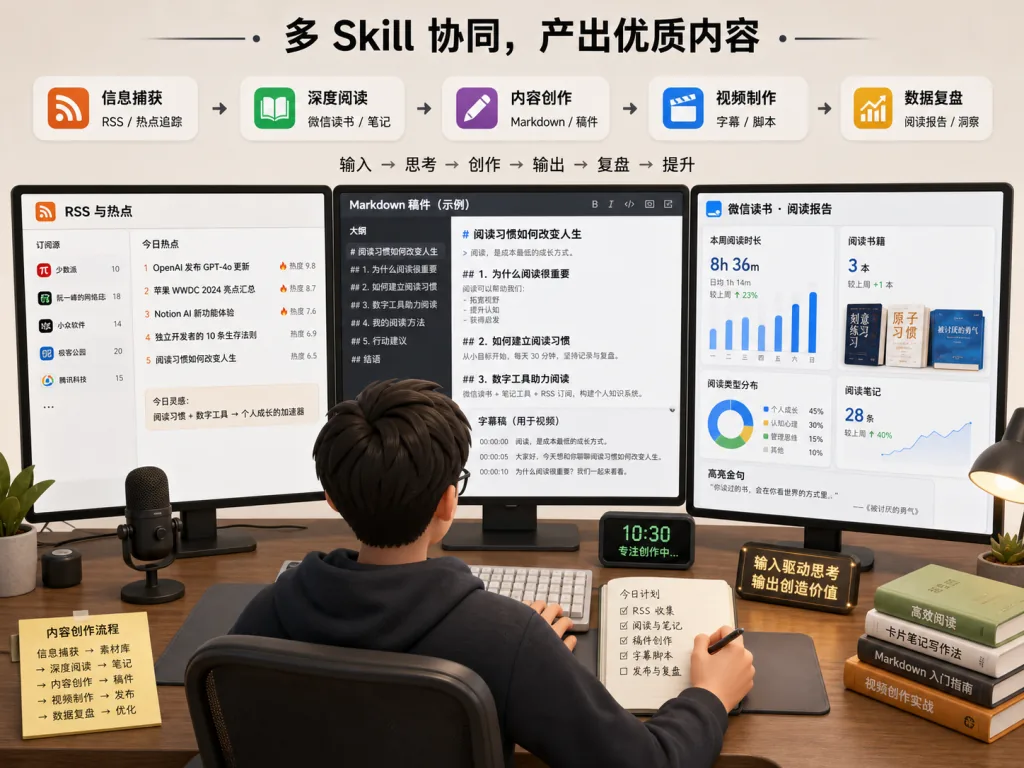
read-rss-aggregator 读取 OPML 中的 RSS 源,输出更新摘要列表;read-topic-collector 聚合 Product Hunt、Hacker News、官方博客和 X 公开信息,生成结构化热点清单,并按「快讯 / 教程 / 方法论 / 选题池」分类,对自媒体作者相当友好。
4. read-weread-export + read-weread-analyzer + read-weread-coach:微信读书三件套
read-weread-export 导出个人划线和想法,支持 Markdown 与 PDF;read-weread-analyzer 基于书架、阅读时长、划线和想法生成 10 维度的 9:16 阅读报告;read-weread-coach 用已读数据做阶梯书单、写作引用抽取和每日划线回顾。整套链路只处理用户授权后的个人数据,依赖官方的 WEREAD_API_KEY。
5. read-feishu-doc + read-ocr + read-personal-data-harvester:文档、图像与个人数据
read-feishu-doc 通过飞书开放 API 读取文档和 blocks;read-ocr 对图片、PDF、扫描件做 OCR,返回结构化 JSON 与置信度;read-personal-data-harvester 在本机建立 SQLite 采集管道,把阅读、观看、收藏历史沉淀下来。整个个人数据流默认只在本机运行,不上传第三方。
四、技术亮点与性能数据
Read Buddy 的架构亮点在「协议化拆分」:每个 Skill 是一个独立目录,含 SKILL.md(YAML frontmatter)和 scripts/,可以单独加载、单独运行。命名遵循 read-<来源>-<动作> 规范,例如 read-url-markdown、read-youtube-transcript、read-content-digest。这种设计带来三个直接收益:可组合(多个 Skill 串联成工作流,如播客 → 字幕 → 摘要 → 口播脚本)、可移植(同一份 Skill 可以装到 9 款 Runtime)、可降级(网页读取优先走轻量抓取,失败再切 Chrome CDP)。它对生态的兼容宽度也值得注意:Claude Code、Codex、Cursor、OpenClaw、Hermes、CodeBuddy、Workbuddy、Gemini CLI、OpenCode 全部覆盖,安装时通过 npx skills add SpaceZephyr/read-buddy 一条命令即可完成 Runtime 自动识别。
五、适用场景与人群
三个典型场景:① 自媒体作者用 read-rss-aggregator + read-topic-collector + read-content-digest 跑每日选题;② 播客听众用 read-xiaoyuzhou-article(依赖 ffmpeg + Groq Whisper)把小宇宙单集转成文字稿,再交给 read-podcast-script-generator 改写成视频口播;③ 知识管理用户把微信读书划线、飞书文档、个人收藏经 read-personal-data-harvester 汇入本地 SQLite,搭出可持续的个人知识库。适合:内容创作者、研究者、产品经理、播客重度听众、知识管理爱好者。不适合:需要实时全网监控的场景、对反爬绕过有强需求的用户,以及不愿配置 GROQ_API_KEY / WEREAD_API_KEY 的人。
六、竞品对比
| 维度 | Read Buddy | 单一 RSS 阅读器 | 自建爬虫脚本 |
|---|---|---|---|
| 来源覆盖 | 网页 / YouTube / 播客 / X / 飞书 / OCR / 微信读书 / RSS | 仅 RSS / 邮件 | 按需开发 |
| 输出形态 | Markdown / JSON / SQLite / 报告 HTML | 仅摘要 | 任意 |
| 工作流串联 | Skill 之间可组合(消化 → 口播 → 写作) | 通常不支持 | 需手动编排 |
| Runtime 兼容性 | 9 款 Agent Runtime | 通常为本地 App | 无关 |
| 个人数据本地化 | 默认本地 SQLite | 部分云端 | 自控 |
核心差距在于:单一 RSS 阅读器只能聚合信息流,自建脚本需要逐个来源写胶水代码。Read Buddy 把「读取」和「消化」拆成了可插拔的 Skill,又把它们放进同一套协议里,对内容工作流的覆盖更完整。
七、如何快速上手
最省事的方式是告诉 Agent:帮我安装这个 skill:https://github.com/SpaceZephyr/read-buddy。也可以一行命令搞定:
npx skills add SpaceZephyr/read-buddy
需要指定运行时,加 -a codex / -a claude-code / -a cursor。手动安装就是 git clone 后把目标 Skill 目录复制到 Runtime 的 skills 目录。装好后,最小可用示例:在 Agent 中输入「把这个网页保存成 Markdown」「提取这个 YouTube 视频的中文字幕」「导出我的微信读书划线」,即可触发对应 Skill。进阶建议:先跑通一个链路(例如「YouTube 字幕 → 摘要 → 短帖」),再按需组合 read-podcast-script-generator、read-content-digest 等做复合工作流。
八、总结与行动建议
Read Buddy 的核心价值可以用一句话概括:把「从各种格式里把信息捞出来」这件事,变成一套可被 Agent 直接调用的 Skill 协议,从而让你从复制粘贴中解放出来,把精力留给选题和创作。项目链接:GitHub 仓库 SpaceZephyr/read-buddy,以及它整合的播客链路 SpaceZephyr/onepod-Skill 与微信读书链路 SpaceZephyr/space-weread,均采用 MIT 许可证。安装前请先读完 README 中的「风控与安全性说明」与「诚实边界」——尤其是 X 自动抓取、OCR 低清图识别和摘要改写后的事实复核这三类坑,建议提前心里有数。如果你每天都要在多个平台间搬运信息,不妨让它接管第一步。