一、开篇:别再手动折腾它了
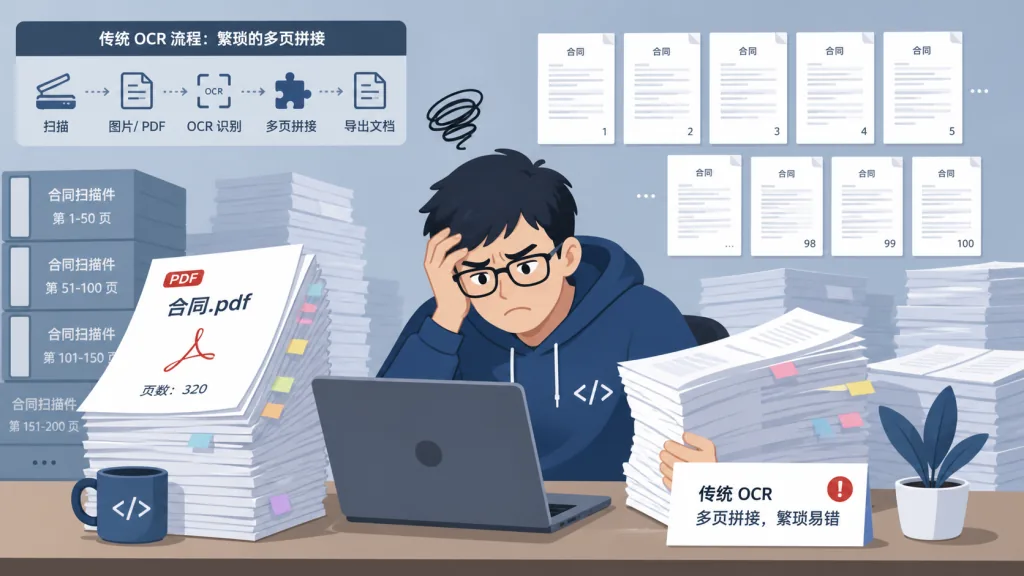
做文档解析的同行大概率踩过这种坑:一本合同扫描件,传统 OCR 跑完后还得人工核对段落顺序,跨页表格断成两半,图片和公式被错误归类,整套流程下来比手动录入还累。GitHub 上 23632 颗 Star 的 Unlimited-OCR 直接瞄准了这个长期痛点,用「一次推理完成长跨度文档解析」的思路,把整篇文档当作一个整体来处理,而不是逐页拼凑。
二、项目定位:它解决的是什么问题
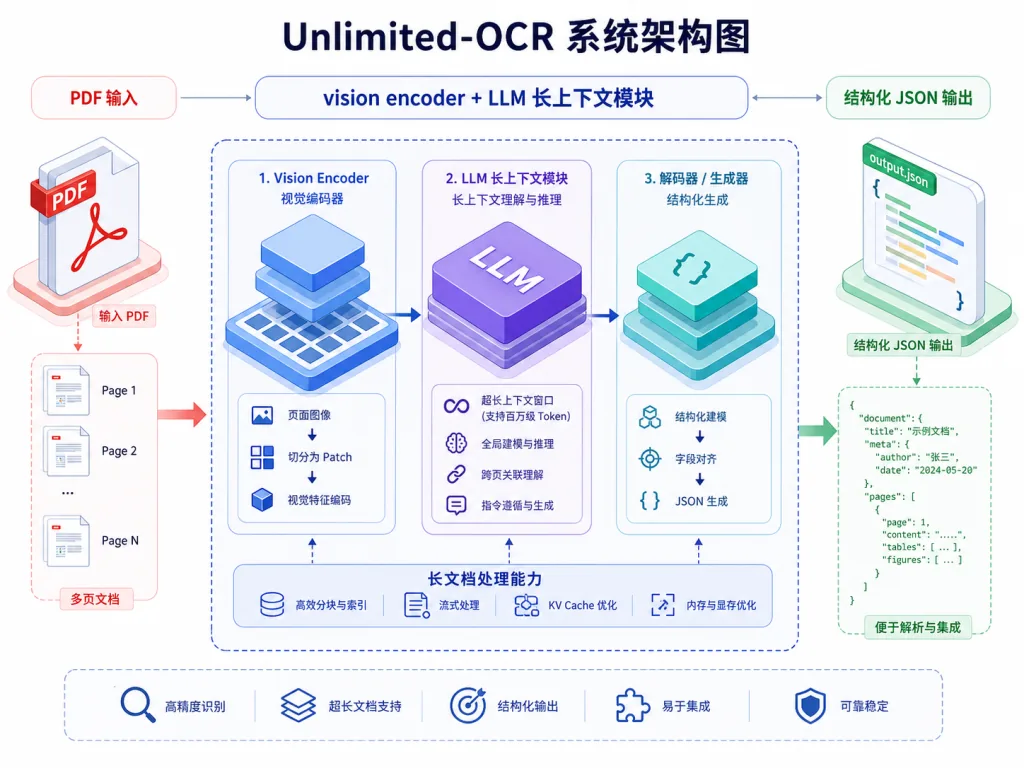
Unlimited-OCR 由百度于 2026 年 6 月开源,定位是「One-shot Long-horizon Parsing(一次性长跨度解析)」时代的代表作,核心关键词是:整篇文档上下文统一建模、多页连贯解析、vLLM/SGLang 高吞吐部署。项目主线是在 DeepSeek-OCR 基础上进一步解决多页文档的全局一致性问题,配套 Hugging Face 模型、Baidu Cloud、vLLM、SGLang、ms-swift 训练、Hugging Face Spaces Demo 等完整生态,半个月内完成了从论文到生产级推理栈的全链路铺设。
三、核心功能深度解析
1. 单图双配置:gundam 与 base 自适应
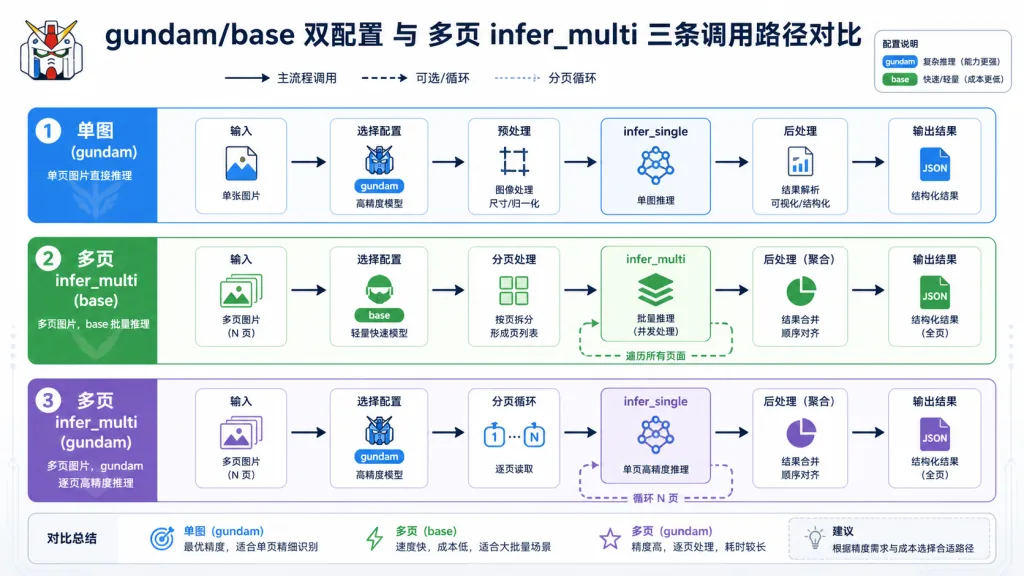
单图推理提供两套配置:gundam 模式(base_size=1024、image_size=640、crop_mode=True)适合复杂版面,通过切片+全局上下文组合提升小字与公式识别;base 模式(base_size=1024、image_size=1024、crop_mode=False)走全图直推,速度更快。开发者只需在 model.infer() 里切换三个参数,就能根据文档质量选择精度优先还是吞吐优先。
2. 多页/PDF 一次性解析
项目主打能力是 model.infer_multi(),把多页图像或整本 PDF 一次性喂给模型,统一输出结构化结果。ngram_window=1024 的设置在跨页重复模式抑制和上下文保持之间取得平衡,配合 PDF 转图(PyMuPDF 300 DPI),整本技术手册、论文集都能一次跑完。
3. 三套推理后端,部署无门槛
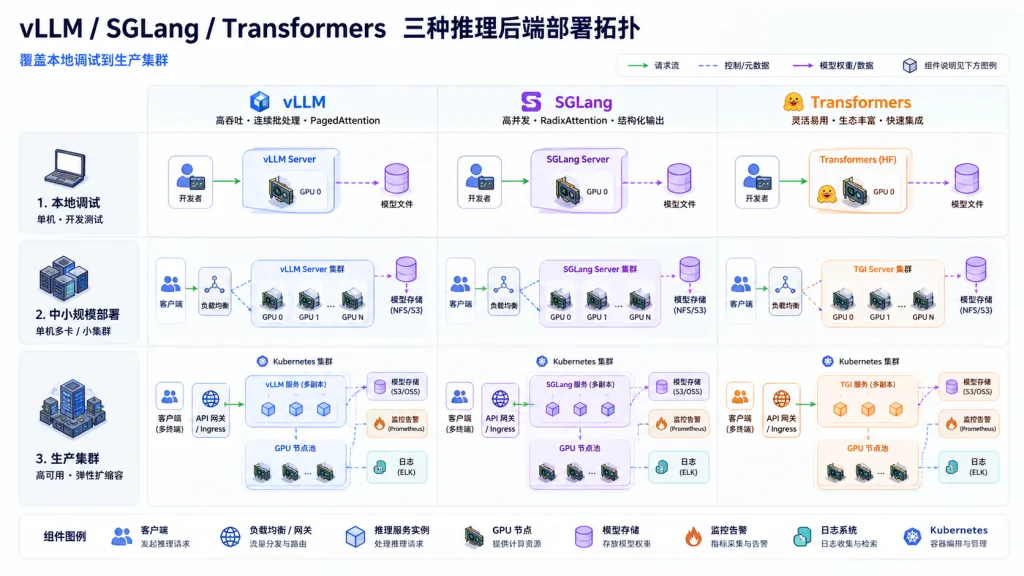
Transformers 适合本地调试;vLLM 提供官方 Recipe 与 vllm/vllm-openai:unlimited-ocr 镜像(CUDA 13.0 与 Hopper 专用 cu129 双版本),走生产级高吞吐;SGLang 则面向极致流式吞吐,--enable-custom-logit-processor 配合 DeepseekOCRNoRepeatNGramLogitProcessor 抑制重复 token,对长文档尤为关键。三套后端覆盖了从原型到生产的完整路径。
4. 训练侧打通 ms-swift
对二次开发团队而言,模型已被纳入 ModelScope ms-swift 训练框架,可直接做 LoRA、全量微调,省去自行搭建 Trainer 的成本。
四、技术亮点与性能数据
项目支持 max_length=32768 的上下文窗口,配合 no_repeat_ngram_size=35 的去重约束,能稳定处理数十页级别的长文档。架构上延续 DeepSeek-OCR 的视觉编码 + 大语言模型路径,并引入长跨度注意力机制,让模型在生成过程中始终「看得见」前文版面信息。vLLM 与 SGLang 的官方适配意味着在 A100/H100 集群上可以跑出与通用 LLM 服务相当的吞吐量,文档解析不再是 GPU 利用率的瓶颈。生态层面兼容 PyTorch 2.10、Transformers 4.57、PyMuPDF 1.27.2.2 等主流版本,并已发布到 Hugging Face、ModelScope、Baidu Cloud 三大模型仓库。
五、适用场景与人群
- 金融/法务文档数字化:合同、招股书、判决书需要保留段落、表格、图注的对应关系;
- 学术论文与技术手册归档:跨页公式、参考文献、图表编号必须在同一上下文中识别;
- 企业内部知识库构建:批量 PDF 入库前一次性解析,减少后处理 ETL 工作量。
不适合纯单页简单票据识别(这类任务传统 PaddleOCR 更轻量),也不适合对实时性要求极高但预算有限的场景(长上下文模型对显存仍有要求)。
六、竞品对比
| 项目 | 多页长跨度 | 主流推理后端 | 训练微调支持 | Star 数 |
|---|---|---|---|---|
| Unlimited-OCR | ✅ 原生支持 | vLLM/SGLang/Transformers | ms-swift | 23.6K |
| DeepSeek-OCR | 部分支持 | Transformers | 社区方案 | 高 |
| PaddleOCR | ❌ 单页为主 | 自有引擎 | PaddlePaddle 全套 | 高 |
| GOT-OCR2.0 | 部分支持 | Transformers | 社区方案 | 中 |
差距在于:Unlimited-OCR 把「长跨度」做成了一等公民,从模型结构到推理后端再到训练框架全部打通,工程完成度领先一档。
七、如何快速上手
最简流程四步走:
- 准备 Python 3.12.3 + CUDA 12.9 环境,安装
torch==2.10.0、transformers==4.57.1、pymupdf==1.27.2.2等依赖; - 用
AutoModel.from_pretrained('baidu/Unlimited-OCR', trust_remote_code=True, torch_dtype=torch.bfloat16)加载模型; - 单图调
model.infer(),多页/PDF 调model.infer_multi(),prompt 用<image>document parsing.或<image>Multi page parsing.; - 生产部署直接拉
vllm/vllm-openai:unlimited-ocr镜像,或按官方 Recipe 走 vLLM / SGLang 启动脚本。
跑通 Demo 后可尝试:把 image_size 在 640/1024 之间切换对比效果;用 SGLang 的 infer.py 对 examples/ 目录批量推理,验证并发吞吐。
八、总结与行动建议
Unlimited-OCR 的核心价值是把「多页文档解析」从「逐页 OCR + 后处理拼接」升级为「一次性端到端推理」,配合三套生产级推理后端和训练框架,工程链路相当完整。建议有文档智能化需求的团队直接接入 Hugging Face Spaces 试用,或拉取 vLLM 镜像在自有集群上做压测,把省下来的人工核对工时变成可量化的 ROI。
- GitHub:https://github.com/baidu/Unlimited-OCR
- 模型:https://huggingface.co/baidu/Unlimited-OCR
- 论文:https://arxiv.org/abs/2606.23050
- Demo:https://huggingface.co/spaces/baidu/Unlimited-OCR
值得一试的理由只有一句话:当你下一次面对一本几百页的 PDF 时,Unlimited-OCR 让你不用再熬夜拼页码。