选择标题(3 选 1)
数据人崩溃日常:100GB 文件秒卡死?Dataset Viewer 让我告别下载解压
Dataset Viewer:100GB 文件秒开、毫秒搜索,AI 全自动开发的数据查看器
没写一行 ETL,却搞定 PB 级数据预览:Dataset Viewer 凭什么这么猛
Dataset Viewer:100GB 文件秒开,这款 AI 全自动开发的数据查看器有点东西
一、开篇:数据人每天都在重复的糟心事
搞数据的朋友,应该都有过这种崩溃时刻:领导甩过来一个 80GB 的 Parquet 文件,要你十分钟内翻出某字段异常值;或者产品丢给你一个藏在 S3 桶里的 ZIP 包,里面 30 万张图,等着排查命名规范。你打开本地编辑器——卡死;下载到一半——磁盘红了;解压到一半——又卡死了。这一套流程下来,少则半小时,多则半天。这就是传统数据查看工具的真实写照:要么不支持大文件,要么不支持远程协议,要么必须先完整下载。Dataset Viewer 这个 1.1k Stars 的项目,直接把这条链路重做了一遍,号称 100GB+ 文件「秒级」响应。
二、一句话看懂:这是个什么项目
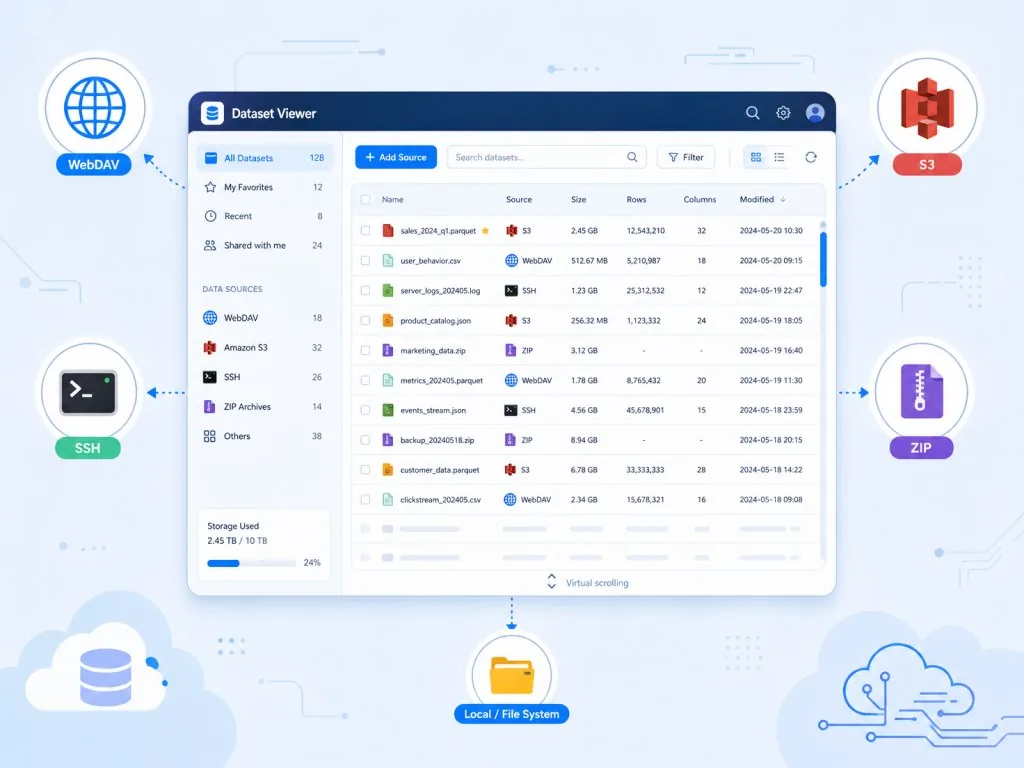
Dataset Viewer 是基于 Tauri + React + TypeScript 打造的现代化数据集查看器,三大关键词:大文件流式加载、多协议直连、AI 全自动开发。它支持 WebDAV、SSH/SFTP、SMB、S3、本地文件、HuggingFace Hub 等多种数据源,原生打开 Parquet、Excel、CSV、JSON、ZIP/TAR 等格式,无需下载、无需解压,直接预览。跨平台覆盖 Windows / macOS / Linux,MIT 协议开源。
三、核心功能深度解析
1. 100GB+ 大文件的流式渲染
传统编辑器打开大文件,需要一次性把内容读进内存,几 GB 就崩。Dataset Viewer 采用虚拟滚动 + 分块加载机制,文件只按需加载可视区域的内容。一个 100GB 的 JSON 文件,滚动到第 800 万行才加载第 800 万行附近的数据,内存占用始终保持在 MB 级别。这意味着你能像刷网页一样翻动巨型日志或导出文件。
2. 毫秒级实时搜索
针对大文件搜索,项目实现了带高亮的实时检索,官方描述为「millisecond search」。它不会因为文件变大而线性变慢,因为底层采用了流式索引和增量匹配策略。配合高亮显示,你能在几十万行 JSON 中瞬间找到目标字段,对调试 API 响应或排查日志尤其有用。
3. 压缩包直读
ZIP/TAR 文件不用解压就能浏览内部结构,点击任意条目即可预览内容。这一能力对数据集分发场景特别友好:很多公开数据集以 zip 形式托管在 HuggingFace 或 OSS 上,传统做法是先下载再解压,磁盘和时间都吃不消;Dataset Viewer 直接省掉这两步。
4. 多协议多格式覆盖
协议层面支持 WebDAV、SSH/SFTP、SMB/CIFS、S3、Local、HuggingFace Hub;格式层面覆盖 Parquet(已优化)、Excel、CSV、ODS、JSON、YAML、XML,以及 JS/Python/Java/C++/Rust/Go 等代码文件的语法高亮,还支持 Markdown、Word、PPT、PDF、图片、视频、音频,甚至 3D 点云。
四、技术亮点与性能数据
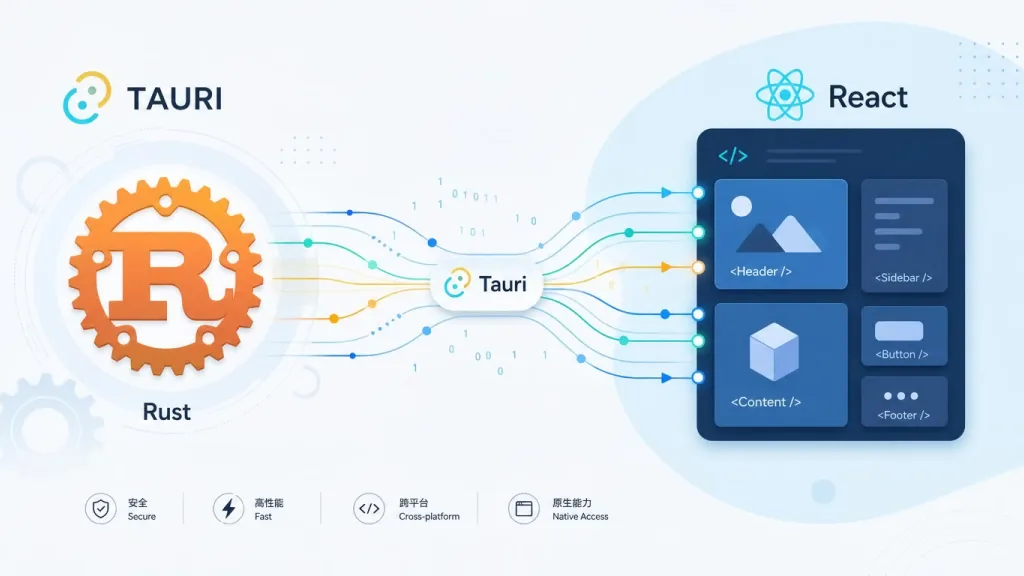
项目最显眼的标签是「100% AI-Generated」——整个代码库由 AI Agent 协同完成,这本身就是一个有意思的工程实验。技术栈上,Tauri(Rust 后端)负责原生性能与跨平台打包,React 负责前端交互,TypeScript 提供类型安全。架构上,核心是流式分块传输与虚拟滚动的组合:网络层只下载必要的数据块,UI 层只渲染可见行,从而把百万级行数的表格、GB 级的日志文件都跑得动。此外,官方还提供了 @dataset-viewer/sdk 包用于插件开发,社区已有 CAD Viewer、Sketch Viewer 等扩展案例,生态可扩展性已经初步铺开。
五、适用场景与人群
数据科学家:日常探索 Parquet/CSV 大数据集,配合 HuggingFace Hub 直连,能免去脚本下载步骤。运维与 SRE:远程 SSH/SFTP 登录服务器,直接搜日志定位问题,不用拉回本地。AI 训练工程师:浏览 S3 或 OSS 上的训练样本压缩包,快速验证数据完整性。算法工程师:查看点云、视频等多媒体数据集。
相对不那么适合的场景:纯手机端查看(项目定位是桌面应用)、超轻量的小文件(VS Code 装个插件即可)、需要复杂数据写入编辑(项目主打只读浏览)。
六、竞品对比
| 维度 | Dataset Viewer | VS Code + 插件 | Jupyter Notebook |
|---|---|---|---|
| 大文件支持 | 100GB+ 流式 | 通常 <1GB | 受内存限制 |
| 远程协议 | WebDAV/SSH/S3/SMB/HF | 需配置扩展 | 需代码连接 |
| 压缩包预览 | 直读 ZIP/TAR | 不支持 | 需解压 |
| 启动方式 | 桌面应用 | 编辑器 | 浏览器/服务 |
| 学习成本 | 零,GUI 操作 | 中 | 高 |
相比传统方案,Dataset Viewer 的核心优势是「一站式」:不需要写脚本连 S3,不需要装一堆插件,下载即用。
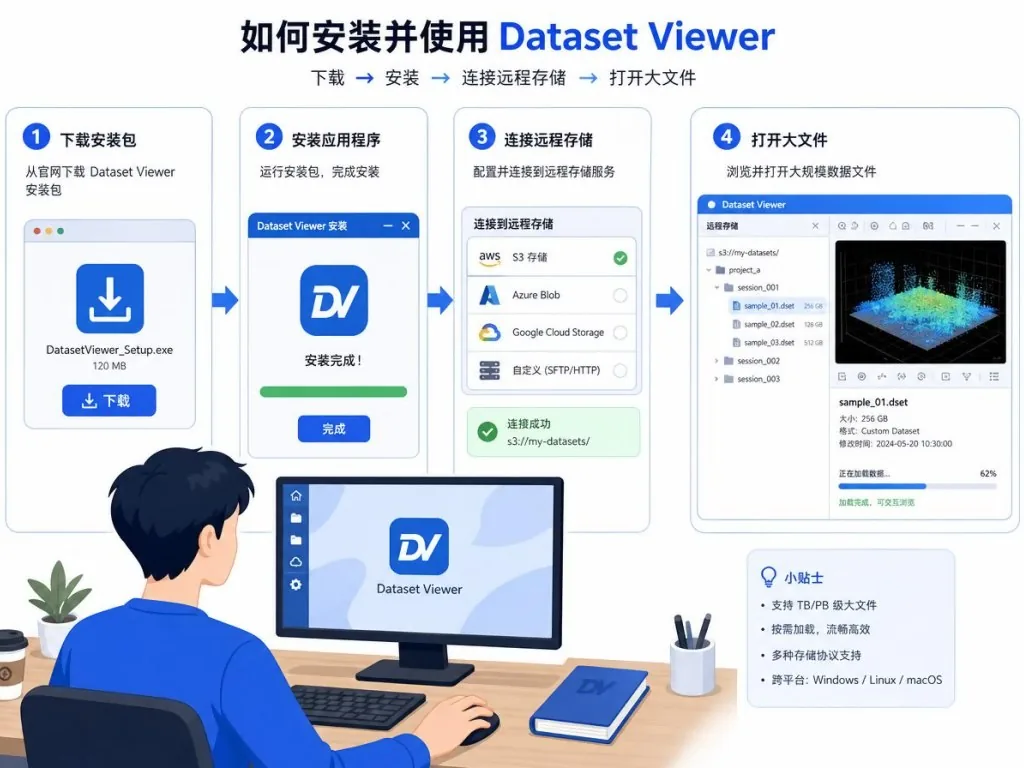
七、如何快速上手
- 前往 Releases 页 下载对应平台的安装包(Windows / macOS / Linux 均有)。
- 安装启动后,点击左上角「新建连接」,按需选择协议(本地文件直接选 Local,S3 填 AK/SK,HuggingFace 填 token)。
- 浏览到目标文件,双击即可打开——大文件会自动进入流式模式,搜索框可直接敲关键字。
- 想扩展功能?在
packages/目录下参考示例插件,结合@dataset-viewer/sdk开发自定义格式查看器。
建议先用一个 10GB 以上的日志文件试一遍流式滚动,再连一个 HuggingFace 上的公开数据集体验远程直连。
八、总结与行动建议
Dataset Viewer 用 AI 写出了一个真实可用、性能硬核的工具,覆盖了大数据日常查看的高频痛点:远程协议多、大文件秒开、压缩包直读、毫秒搜索。对于每天和数据打交道的人,这是一款能直接替换掉脚本+编辑器的桌面应用。如果你正被「下文件-解压-打开」三连折磨,不妨装一个试试。
- 项目地址:https://github.com/stardustai/dataset-viewer
- 文档主页:https://stardustai.github.io/dataset-viewer
- 插件 SDK:https://www.npmjs.com/package/@dataset-viewer/sdk
数据查看这件事,本不该这么累。
#dataset-viewer #DatasetViewer #stardustai #AI智能体 #AI工作流 #自动化 #开源项目 #GitHub