一、开篇:为什么你需要这个工具?
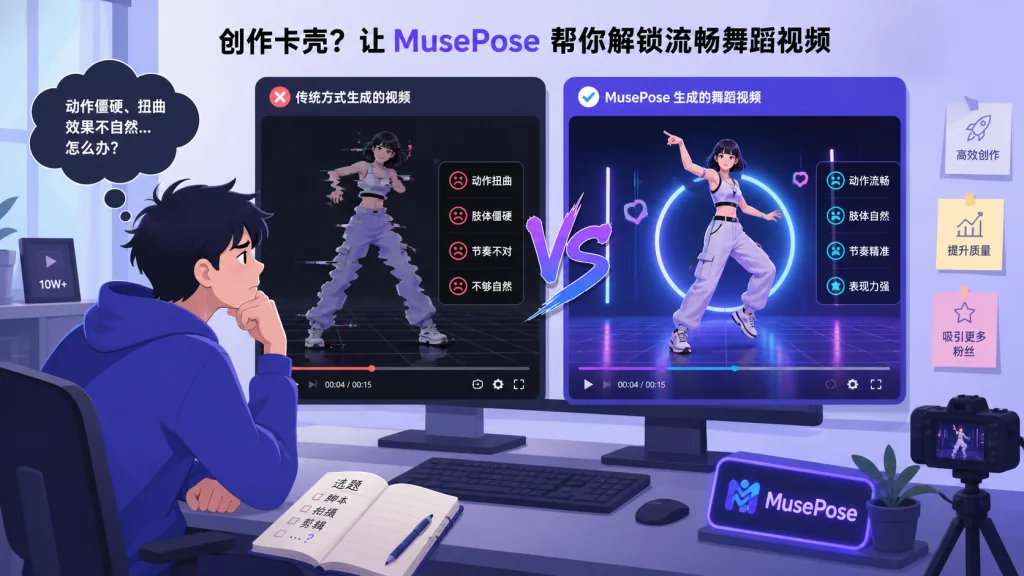
短视频创作者常陷入两难:想用一张角色照片配合指定动作生成连贯视频,却卡在角色形变严重、面部模糊、背景抖动的老问题里。开源社区涌现的 AnimateAnyone 类方案普遍存在「形变扭曲 + 面部一致性崩塌 + 显存门槛高」三大痛点,而 MusePose 把这些痛点逐一击穿——它仅凭一张参考图和一段姿态序列,就能生成舞蹈视频,并保持角色身份高度稳定。这个项目来自腾讯音乐娱乐 Lyra Lab,上线不久即在 GitHub 收获 2.7K Stars,成为虚拟人视频生成赛道的现象级开源方案。
二、项目简介:一句话说明它是什么
MusePose 是一个基于扩散模型、以姿态为引导信号的图生视频框架。它专注于「虚拟人视频生成」,核心关键词是:扩散架构、姿态驱动、参考图一致性、Pose Align 算法。它是对 Moore-AnimateAnyone 的优化实现,也是腾讯 Muse 开源系列(MuseV + MuseTalk + MusePose)的最后一块拼图,目标指向端到端虚拟人视频生成。
三、核心功能深度解析
1. 姿态驱动的图生视频生成
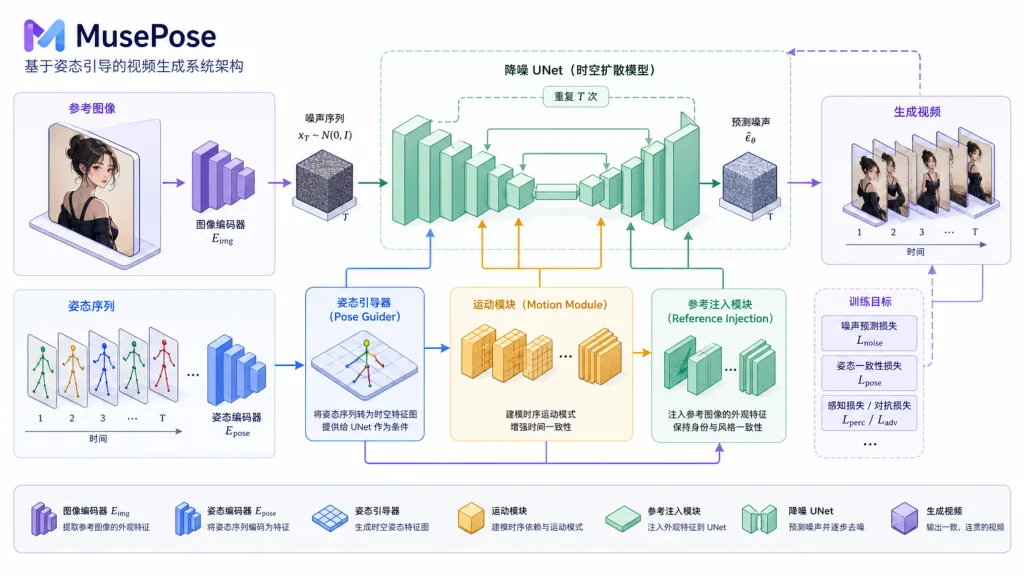
MusePose 基于扩散模型,将参考图、姿态序列和噪声潜在空间联合建模。用户只需提供一张角色图和一段目标姿态视频,模型即可输出角色在该姿态下的连贯视频帧。它在生成质量上超越了当前绝大多数同主题开源方案,人物动作自然度、身份保持度都达到了可用水平。
2. Pose Align 姿态对齐算法
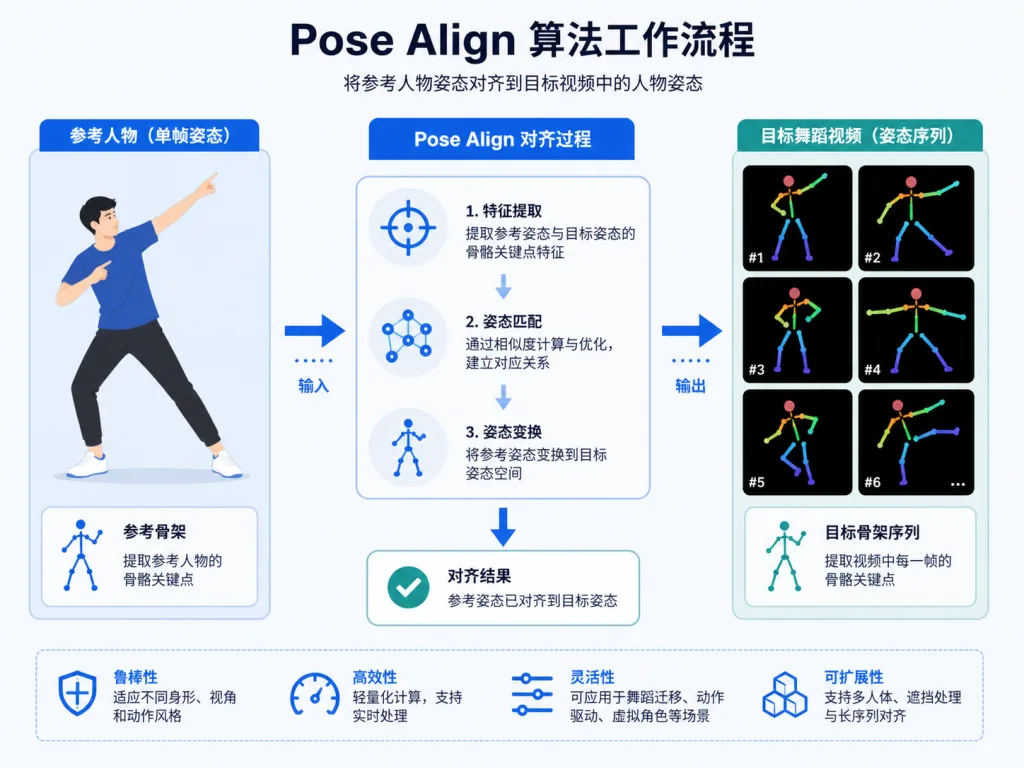
这是 MusePose 的「杀手锏」。任意参考图和任意舞蹈视频之间的姿态对齐一直是个老大难问题:人物比例差异、初始姿态不一致会导致推理失败。MusePose 内置的 Pose Align 算法能自动将舞蹈视频的姿态序列适配到参考图角色,极大提升了推理成功率,并降低了用户使用门槛。开发者只需运行一条命令即可完成对齐。
3. 全流程训练代码开源
2025 年 3 月,MusePose 正式开源训练代码,配套 stage 1 和 stage 2 两阶段训练脚本,支持 accelerate + DeepSpeed ZeRO-2 分布式训练。这意味着开发者可以在自有数据上微调模型,实现自定义角色或特定风格的虚拟人视频生成,而不仅限于调用预训练权重。
4. 显存优化与多分辨率支持
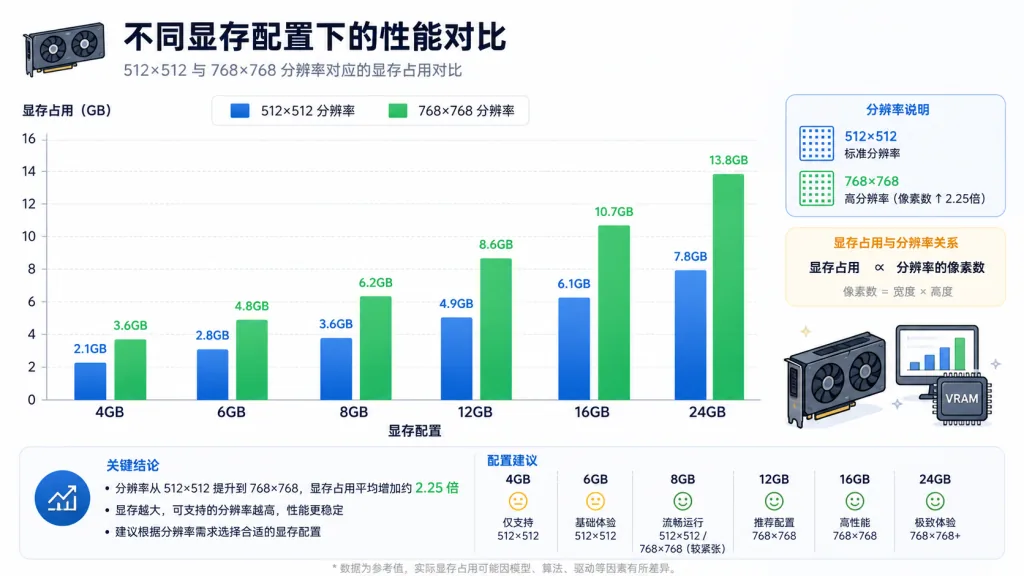
MusePose 默认输出高分辨率视频,但通过 -W 512 -H 512 参数即可切换至低分辨率生成再 upscale 回去,把显存占用从 28GB(768×768×48 帧)降至 16GB(512×512×48 帧),让消费级显卡也能跑得动。
四、技术亮点与性能数据
技术架构上,MusePose 由参考 UNet、降噪 UNet、运动模块、姿态引导器四大组件构成,融合了 Stable Diffusion、AnimateDiff、DWPose 等多个开源组件。性能数据层面:512×512 分辨率下 48 帧生成需 16GB 显存,768×768 分辨率下需 28GB 显存。生态兼容性方面,它已支持 ComfyUI 插件(Comfyui-MusePose),可在可视化工作流中直接调用;并且模型采用 MIT 协议商用友好,训练代码完整开放,配套文档详尽。
五、适用场景与人群
场景一:短视频内容创作——舞蹈类、剧情类短视频作者可一键生成虚拟人舞蹈视频,免去动捕或 3D 建模成本。场景二:AIGC 虚拟偶像运营——经纪公司、MCN 可定制专属虚拟形象,让偶像「动起来」。场景三:学术研究与模型微调——AI 研究者可基于完整训练代码在私有数据上微调,复现并改进论文结果。适合:AI 视频生成开发者、虚拟人项目团队、短视频创作者;不适合:需要毫秒级实时生成的场景(当前仍偏离线渲染)、对角色细节极致还原的商业级电影特效。
六、竞品对比
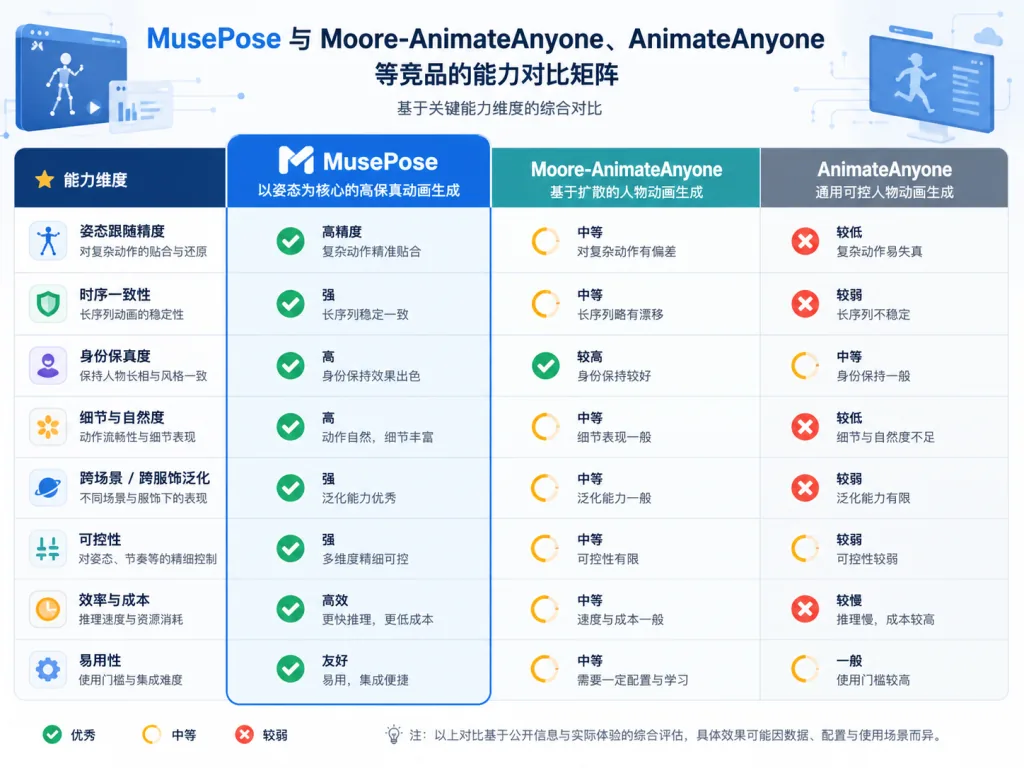
| 项目 | 姿态驱动 | Pose Align | 训练代码 | 显存门槛 | Stars |
|---|---|---|---|---|---|
| MusePose | ✅ | ✅ 内置 | ✅ 完整开源 | 16GB | 2.7K |
| Moore-AnimateAnyone | ✅ | ❌ | 部分 | 24GB+ | - |
| AnimateAnyone (官方) | ✅ | ❌ | ❌ 未开源 | 高 | - |
相比同类项目,MusePose 的优势在于:内置对齐算法解决「参考图与姿态视频不适配」痛点,显存门槛大幅降低,训练代码完整开源且文档清晰,生成质量在同主题开源方案中处于第一梯队。
七、如何快速上手
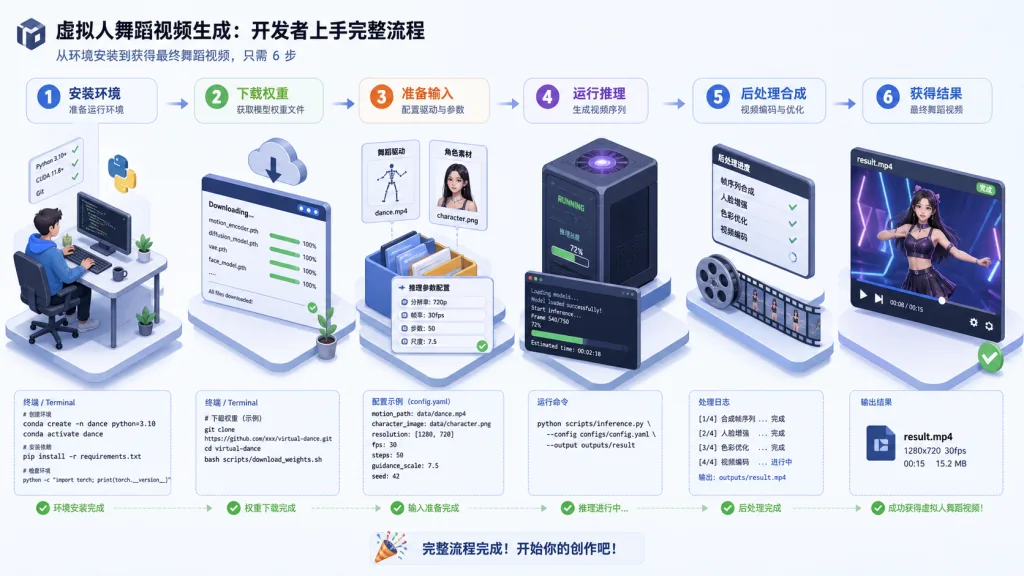
环境准备:Python ≥ 3.10、CUDA 11.7,安装 requirements.txt 并通过 mim 安装 mmcv、mmdet、mmpose 等依赖。
下载权重:从 HuggingFace 下载 MusePose 权重及配套组件(sd-image-variations-diffusers、dwpose、sd-vae-ft-mse、image_encoder、yolox 等),按文档结构组织到 pretrained_weights 目录。
最小推理示例:把参考图放入 ./assets/images/ref.png,舞蹈视频放入 ./assets/videos/dance.mp4,运行 python pose_align.py 完成姿态对齐,再执行 python test_stage_2.py --config ./configs/test_stage_2.yaml 即可在 ./output/ 得到生成结果。低显存用户加上 -W 512 -H 512 即可。
进阶建议:追求面部一致性可配合 FaceFusion 做 face-swap;想自定义角色可用训练代码在自有舞蹈视频上微调 stage 2 模型。
八、总结与行动建议
MusePose 用一张图、一段姿态、一条命令,就把虚拟人视频生成门槛拉到了消费级显卡可触及的范围。它值得你立刻尝试:内容创作者可立刻跑通 demo 体验效果,开发者可基于开源训练代码二次定制,企业可借助 ComfyUI 插件快速集成进生产管线。项目链接:GitHub(https://github.com/TMElyralab/MusePose)、HuggingFace(https://huggingface.co/TMElyralab/MusePose)。一句话推荐:想用最少成本让虚拟人「动」起来,MusePose 是当下最值得 Star 的开源方案。