一、开篇:为什么你需要这个工具?
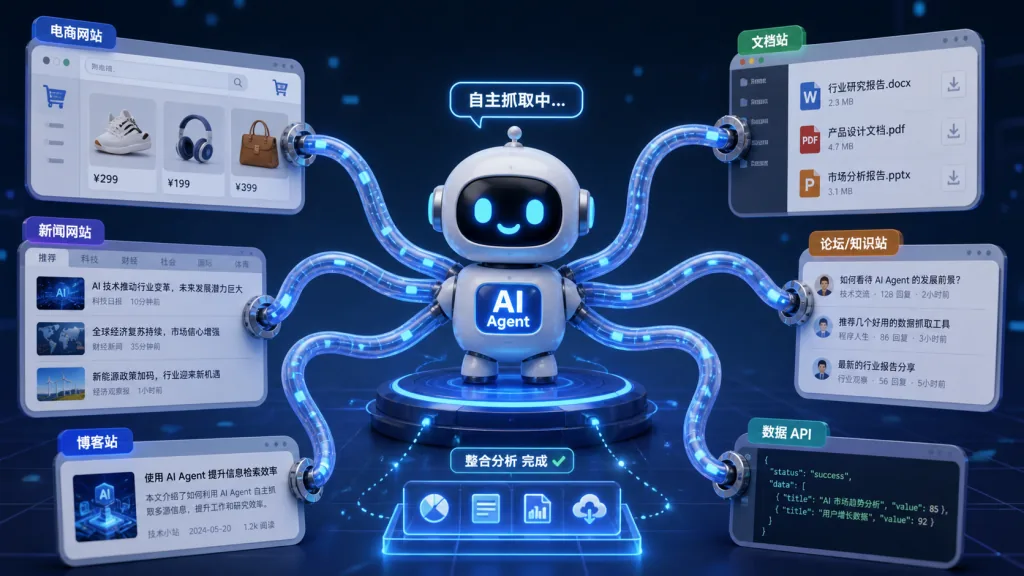
做 AI Agent 的同学,几乎都踩过同一个坑:把网页丢给大模型之前,得先把它「洗干净」。
传统爬虫方案对 JavaScript 渲染页束手无策,IP 被封、内容缺失、结构混乱是家常便饭。一份来自行业的统计显示,超过 60% 的现代网站依赖 JS 动态渲染,而传统爬虫对这类页面的成功率不足 30%。更要命的是,LLM 吃的是 Token,HTML 里的广告、导航、注释全是无效噪音,每清理 1MB 噪音就多花几百 Token。
更让人头疼的是,当你需要把爬虫接入 Claude Code、Cursor、Cline 这类 AI 编程助手时,配置代理、调度、反爬绕过的代码动辄上千行——Agent 的核心业务逻辑还没写,时间全耗在基础设施上。
如果有一款工具,能把「搜索 + 抓取 + 交互 + 解析」四件事打包成一行 API 调用,并原生支持 MCP 协议直连任意 AI Agent,你会不会心动?Firecrawl 就是为解决这些问题而生的。
二、项目简介:一句话说明它是什么
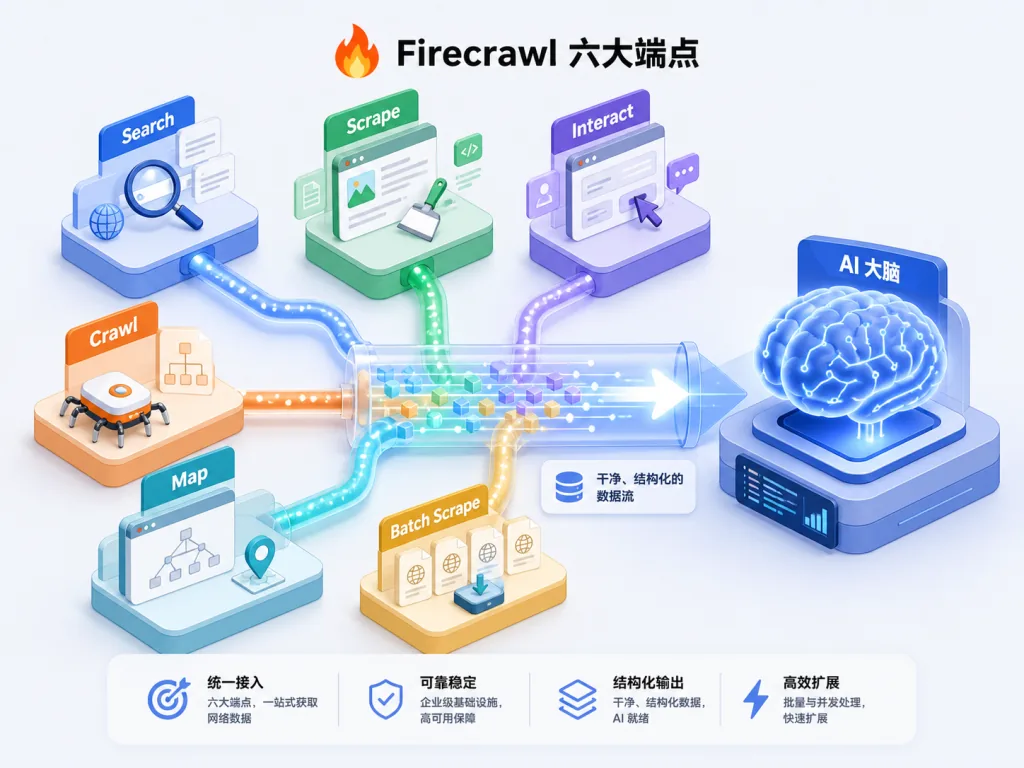
Firecrawl 是 GitHub 上 Star 数突破 16.6 万的开源 Web 数据 API,由 TypeScript 编写,提供 Search、Scrape、Interact、Crawl、Map、Batch Scrape 六大核心端点,覆盖 96% 的网络页面(包括 JS 重度渲染页)。
它的核心定位是 「The context API to search, scrape, and interact with the web at scale」——为 AI Agent 提供干净、即用、结构化的 Web 上下文。同时它支持 Python、Node.js、Go、Java、Rust、Ruby、.NET、PHP、Elixir 九种语言 SDK,并提供云端 SaaS(firecrawl.dev)和自托管两种部署方式。
三、核心功能深度解析
1. Scrape:把任意 URL 转成 LLM 就绪数据
Scrape 是 Firecrawl 的基石端点。调用 app.scrape('firecrawl.dev') 后,引擎会自动处理代理轮换、JS 渲染、反爬绕过,最终返回 Markdown、HTML、截图或结构化 JSON 中的任意一种格式。
相比传统爬虫,它内置了「内容清洗」管线:自动剔除导航、广告、页脚等噪音,输出可直接喂给 GPT-4、Claude 的 Markdown。P95 延迟 3.4 秒,覆盖数百万次实测请求,稳定性远超自建方案。
2. Search + 全页内容:搜索结果不再只有链接
传统搜索 API 只返回 URL 和摘要,开发者还得二次爬取。Firecrawl 的 Search 端点一次性返回标题、链接和完整正文 Markdown,省去串联两套服务的麻烦。调用 app.search('firecrawl', limit=5) 即可获得一个可直接用于 RAG 的结构化数组。
3. Interact:让 Agent 像人一样点击、滚动、输入
这是 Firecrawl 区别于同类产品的杀手锏。Scrape 之后,系统返回一个 scrape_id,Agent 可以基于这个 ID 调用 interact(scrape_id, prompt='搜索机械键盘'),Firecrawl 会在浏览器实例中执行点击、滚动、输入、等待等动作,再把执行后的页面内容返回。
这意味着 AI 可以直接操作需要登录、表单提交、翻页的复杂站点,比如电商价格抓取、后台数据导出等场景,过去需要 Selenium/Puppeteer 写几百行代码,现在一句话 Prompt 搞定。
4. Agent:自然语言驱动的自主数据采集
如果你连 URL 都不想提供,Agent 端点就是终极形态。只需传入 prompt='查找 Notion 的定价方案',Firecrawl 的 Spark 模型会自动搜索、导航、抓取、汇总,返回结构化答案和来源链接。
它支持两种模型:spark-1-mini(便宜 60%,覆盖大多数任务)和 spark-1-pro(复杂研究、多站点比对专用)。开发者还可以传入 Pydantic Schema,让返回结果直接是强类型对象,下游代码无需再做字段映射。
5. Crawl / Map / Batch Scrape:批量场景三件套
- Crawl:一次请求爬取整个站点,返回带 Job ID 的异步任务,SDK 自动轮询直到完成。
- Map:毫秒级列出站点所有 URL,相当于给网站拍 X 光片,可叠加
search参数按关键词过滤。 - Batch Scrape:并发抓取数千个 URL,适合离线构建知识库。
四、技术亮点与性能数据
| 指标 | 数据 |
|---|---|
| Web 覆盖率 | 96%(含 JS 重度渲染页) |
| P95 延迟 | 3.4 秒(数百万次实测) |
| Star 数 | 166,200+ |
| 许可证 | AGPL-3.0(核心)/ MIT(SDK) |
| 支持语言 SDK | 9 种(Python/Node.js/Go/Java/Rust/Ruby/.NET/PHP/Elixir) |
架构层面,Firecrawl 内置轮换代理池、JS 渲染引擎、速率限制管理和媒体解析器(支持 PDF、DOCX 等 Web 文档)。开发者无需关心反爬细节,零配置上线。生态上,它原生支持 Claude Code、Antigravity、OpenCode、Cline 等主流 AI 编程助手,通过 MCP 协议一键接入;也支持 Lovable、Zapier、n8n 等无代码平台。
五、适用场景与人群
适合谁:
- AI Agent 开发者:需要为 RAG、Tool Use、Autonomous Agent 提供实时 Web 数据源。
- AI 编程助手用户:在 Cursor、Claude Code 中希望直接调用真实网络数据,而不仅靠模型记忆。
- 数据团队:构建竞品监控、价格情报、行业研究等自动化数据管线。
- 独立开发者 / 创业团队:没有精力自建爬虫基础设施,需要一个开箱即用的 API。
具体场景:
- RAG 知识库构建:批量抓取企业官网、文档站、博客,自动清洗入库。
- 竞品价格监控:用 Interact 端点模拟真人操作电商后台,实时跟踪 SKU 价格。
- 行业研究 Agent:用 Agent 端点让模型自主调研「对比 Firecrawl、Apify、ScrapingBee 的企业版功能」,输出带来源的研报。
- SEO 内容审计:用 Map + Crawl 全站扫描,自动检测死链、缺失 Meta、重复内容。
不适合谁:需要严格合规审计、要求 100% 自托管数据出境、或站点明确禁止爬取的企业级爬虫项目(这类项目建议走定制方案)。
六、竞品对比
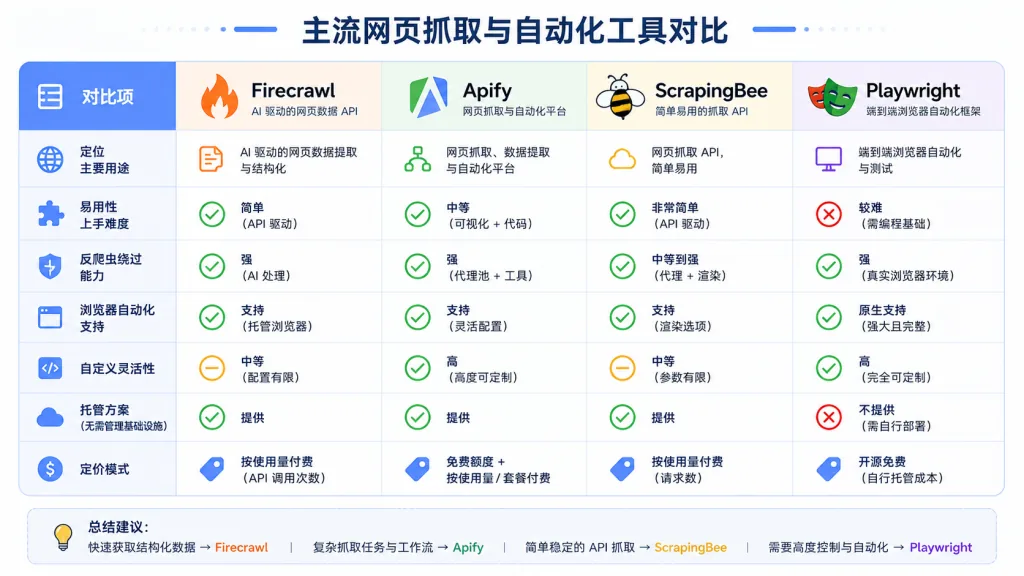
| 项目 | 类型 | JS 渲染 | 交互能力 | AI 原生 | MCP 支持 | 开源 |
|---|---|---|---|---|---|---|
| Firecrawl | SaaS + 自托管 API | ✅ 自动 | ✅ Interact 端点 | ✅ Agent / Spark | ✅ 一行命令 | ✅ AGPL-3.0 |
| Apify | 平台型(Actor 市场) | ✅ | ⚠️ 需自写 Actor | �️ 弱 | ❌ | 部分 |
| ScrapingBee | SaaS API | ✅ | ❌ | ❌ | ❌ | ❌ |
| Playwright/Puppeteer | 浏览器自动化库 | ✅ | ✅ | ❌ 需自行集成 | ❌ | ✅ |
Firecrawl 的差异化在于:把「抓取 + 交互 + AI 自主决策」三层能力封装在同一 API 中,并通过 MCP 协议深度集成进 AI Agent 工作流。对比 Apify 的「积木式 Actor」,Firecrawl 的上手成本更低;对比 ScrapingBee,它多了交互能力;对比 Playwright,它免维护、高可用。
七、如何快速上手
第一步:获取 API Key
前往 firecrawl.dev 注册账号,免费套餐足够个人项目试用。也可在 playground 直接在线测试。
第二步:安装 SDK(以 Python 为例)
pip install firecrawl-py
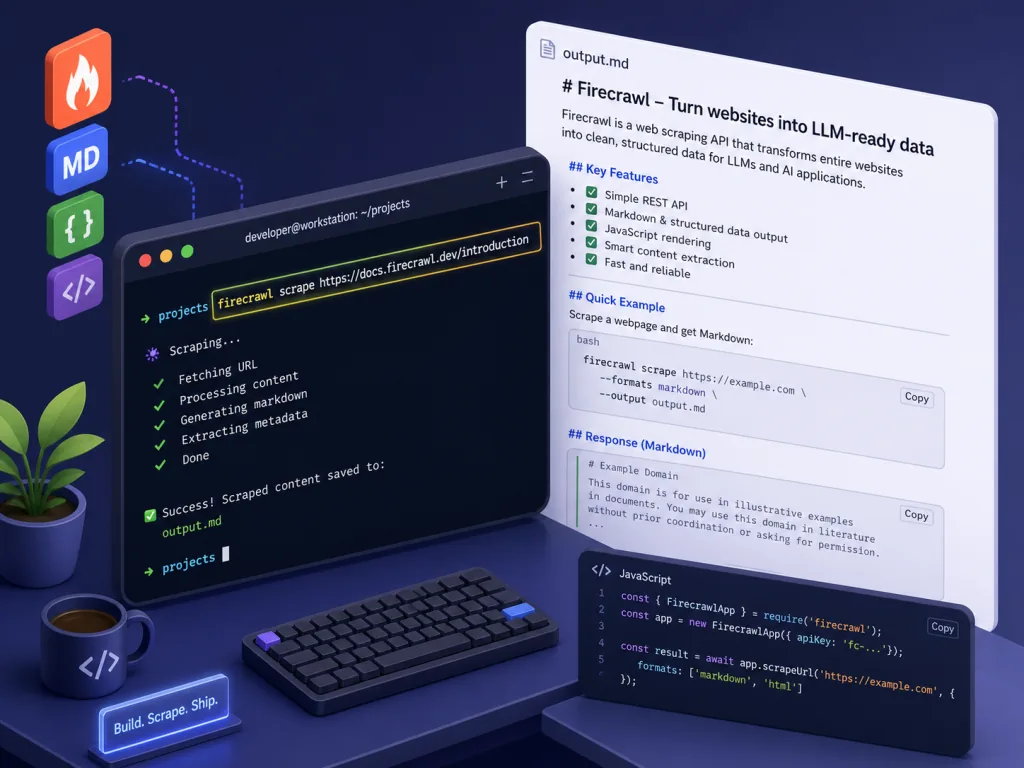
第三步:三行代码完成首次抓取
from firecrawl import Firecrawl

app = Firecrawl(api_key="fc-YOUR_API_KEY")
result = app.scrape('https://firecrawl.dev', formats=['markdown'])
print(result.markdown)
第四步:接入 AI Agent(MCP 模式)
只需在 MCP 配置中加入:
{
  "mcpServers": {
    "firecrawl-mcp": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": { "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY" }
    }
  }
}
进阶建议:生产环境务必传入 only_main_content=True 以节省 Token;批量任务用 batch_scrape 异步执行;自托管可参考官方 Self-Hosting Guide。
八、总结与行动建议
Firecrawl 的核心价值在于:把 Web 数据采集从「基础设施苦力活」升级为「一行 API 调用」,并原生适配 AI Agent 时代的工作流。16.6 万 Star、P95 3.4 秒、覆盖 96% Web 页面——这些数字背后,是一个真正可投产的开源工具。
如果你是 Agent 开发者,现在就去 firecrawl.dev 领个 Key,十分钟内就能让 Agent 拥有真实网络能力;如果你是数据团队,可以从 Crawl + Map 入手,半天搭出一条企业级数据管线。
项目链接:
- GitHub:https://github.com/firecrawl/firecrawl
- 官网:https://firecrawl.dev
- 文档:https://docs.firecrawl.dev
- MCP 服务端:https://github.com/firecrawl/firecrawl-mcp-server
一句话推荐:当你的 AI Agent 需要「看见」真实世界时,Firecrawl 是当前最省心的数据层。