一、开篇:为什么你需要这个工具?
做 RAG 的时候,你大概率踩过这种坑:客户甩过来一个 200 页的 PDF、一份带图表的 PPT、一个扫描版的合同,模型怎么读都读不准。文本提不出来、标题丢了、表格变乱码,喂进去的全是「营养不良」的语料。更扎心的是,光把 PDF 转成干净文本这一步,就能耗掉你半天时间。MarkItDown 干的就是这件事:把杂七杂八的文件,统一压成 LLM 最爱吃的 Markdown 格式。
二、项目简介:一句话说明它是什么
MarkItDown 是微软 AutoGen 团队开源的 Python 工具,专门把 PDF、Word、PPT、Excel、图片、音频、网页等文件转成结构化 Markdown。它在 GitHub 已经拿下 17 万+ Stars,主打「为 LLM 而生」,输出对 GPT-4o 这类模型天然友好,token 消耗也比 HTML 低得多。
三、核心功能深度解析
1. 全格式通吃,20+ 格式一键转
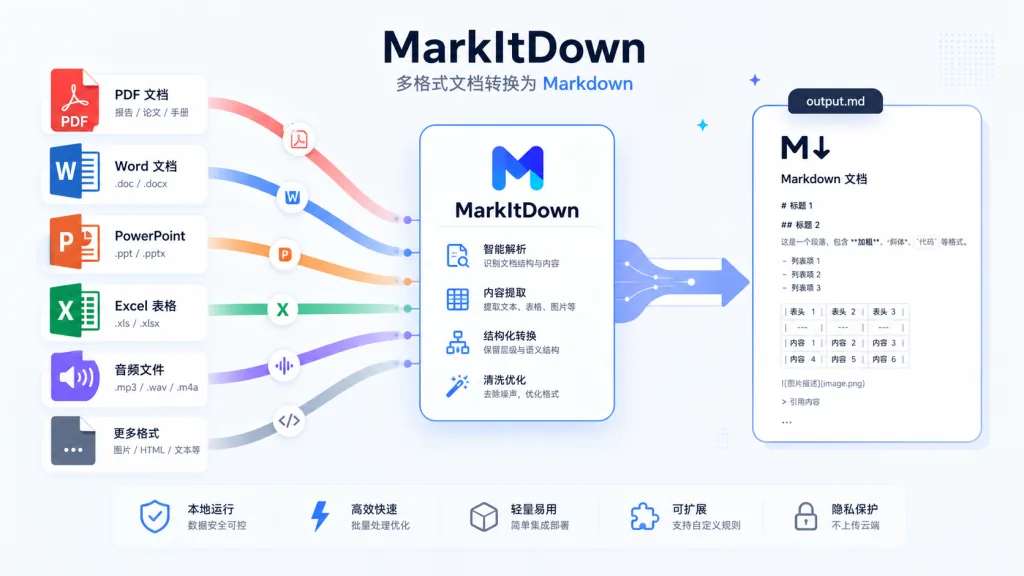
MarkItDown 支持 PDF、PowerPoint、Word、Excel、图片(EXIF + OCR)、音频(转录)、HTML、CSV/JSON/XML、ZIP、YouTube 链接、EPUB 等格式。一条命令搞定:
markitdown report.pdf -o report.md
相比 textract,MarkItDown 不是简单抽文本,而是尽量保留标题、列表、表格、链接这些关键结构,让下游模型能「看懂」语义。
2. 多模态能力:图片描述、OCR、音视频转录
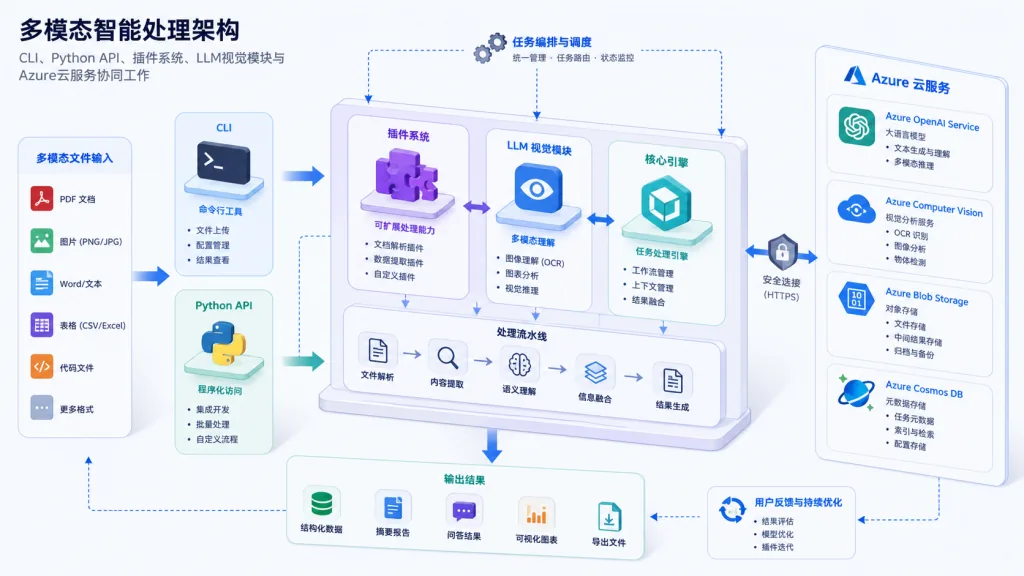
通过传入 llm_client 和 llm_model,MarkItDown 能让 GPT-4o 给图片写 Alt 文本、给 PPT 里的图自动生成说明。配合 markitdown-ocr 插件,PDF/Word/PPT 里的扫描图片也能 OCR 出来,不用额外装一堆 ML 依赖。音频文件走 EXIF + 语音转录,YouTube 链接直接拉字幕。
3. Azure 云端增强:Document Intelligence & Content Understanding
- Document Intelligence:云端版面分析,扫描 PDF、复杂表格识别效果更稳。
- Content Understanding:统一处理文档、图片、音频、视频,还能用自定义 analyzer 抽结构化字段,自动输出成 Markdown 的 YAML front matter。比如发票里的「VendorName」「InvoiceDate」直接打成元数据。
4. 可插拔架构
MarkItDown 原生支持第三方插件,用 markitdown --list-plugins 查可用插件,--use-plugins 启用。社区已有 OCR、EPUB 等扩展,GitHub 上搜 #markitdown-plugin 就能发现更多。
四、技术亮点与性能数据
MarkItDown 要求 Python ≥ 3.10,安装一条命令搞定:pip install 'markitdown[all]'。如果只想要 PDF/Word/PPT 三个能力,缩到 pip install 'markitdown[pdf, docx, pptx]' 也能跑,依赖体积减半。底层针对每种格式走专用 converter:PDF 用 pdfminer 系,PPT 用 python-pptx,Excel 用 openpyxl,保证结构不丢。
生态兼容性同样到位:CLI、Python API、Docker 三种用法都齐全;支持 OpenAI 兼容的 LLM 客户端,也兼容 Azure 的两类云服务。安全方面官方反复提醒:不要直接拿不可信输入跑 convert(),要用 convert_local()、convert_stream() 这类窄接口限制访问路径。
五、适用场景与人群
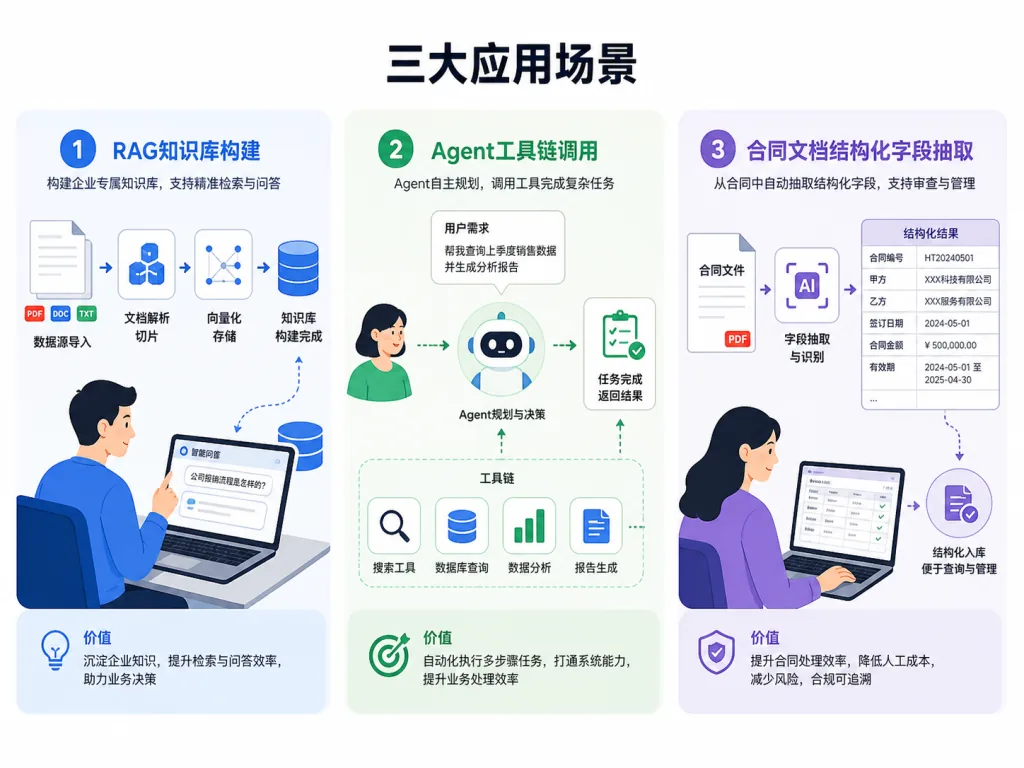
场景 1:RAG 知识库预处理
把企业内部的 PDF 手册、PPT 培训资料、Excel 名单统一转 Markdown,塞进向量库。
场景 2:LLM Agent 工具链
让 Agent 自己调用 MarkItDown 处理附件,比如拿到一份合同 PDF 自动抽取条款。
场景 3:内容理解与摘要
用 Content Understanding 把发票、简历、合同转成带结构化字段的 Markdown,再喂给模型做问答。
适合谁:RAG 工程师、AI 应用开发者、需要处理大量文档的数据团队。不适合只想做高保真文档展示的设计师——MarkItDown 的目标是「机器友好」,不是「人眼美观」。
六、竞品对比
| 工具 | 核心定位 | Markdown 保留 | 多模态 | 云端增强 |
|---|---|---|---|---|
| MarkItDown | LLM 语料预处理 | 强(标题/列表/表格/链接) | 图片 OCR、音视频转录、LLM 描述 | Azure Doc Intel + Content Understanding |
| textract | 纯文本抽取 | 弱,几乎丢结构 | 仅基础文本 | 无 |
| Pandoc | 文档格式互转 | 中等 | 弱 | 无 |
| Unstructured | ETL 数据处理 | 中等 | 有 | 有 |
选 MarkItDown 的核心理由:它是为 LLM 而生的「最后一公里」工具,比 textract 更懂 Markdown,比 Pandoc 更懂 AI 需求,比 Unstructured 更轻量。
七、如何快速上手
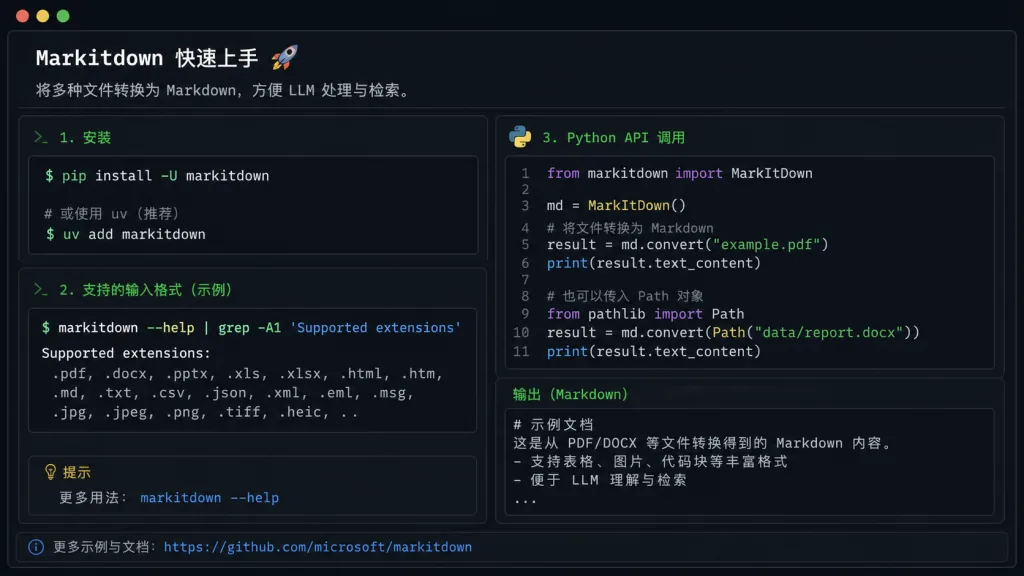
1. 安装
新建虚拟环境后:
pip install 'markitdown[all]'
2. CLI 试用
markitdown test.pdf -o test.md
3. Python API
from markitdown import MarkItDown
md = MarkItDown()
result = md.convert("test.xlsx")
print(result.text_content)
4. 进阶:接入 LLM 写图片描述
from openai import OpenAI
md = MarkItDown(llm_client=OpenAI(), llm_model="gpt-4o")
result = md.convert("slides.pptx")
进阶建议:生产环境务必用 convert_local() 限制路径,配合插件按需启用,别一上来就 pip install [all] 把依赖拉满。
八、总结与行动建议
MarkItDown 把「把世界喂给 LLM」这件事标准化了:20+ 格式、保留结构、对接云端 OCR、还能让 GPT-4o 给图片写说明。17 万+ Stars 的背后,是 RAG、Agent、文档问答场景的集体投票。
- GitHub:https://github.com/microsoft/markitdown
- PyPI:https://pypi.org/project/markitdown/
- 文档:仓库内
README.md与packages/markitdown-ocr/README.md
一句话推荐:做 LLM 应用,先把语料过一遍 MarkItDown,再谈下游。