一、开篇:为什么你需要这个工具?
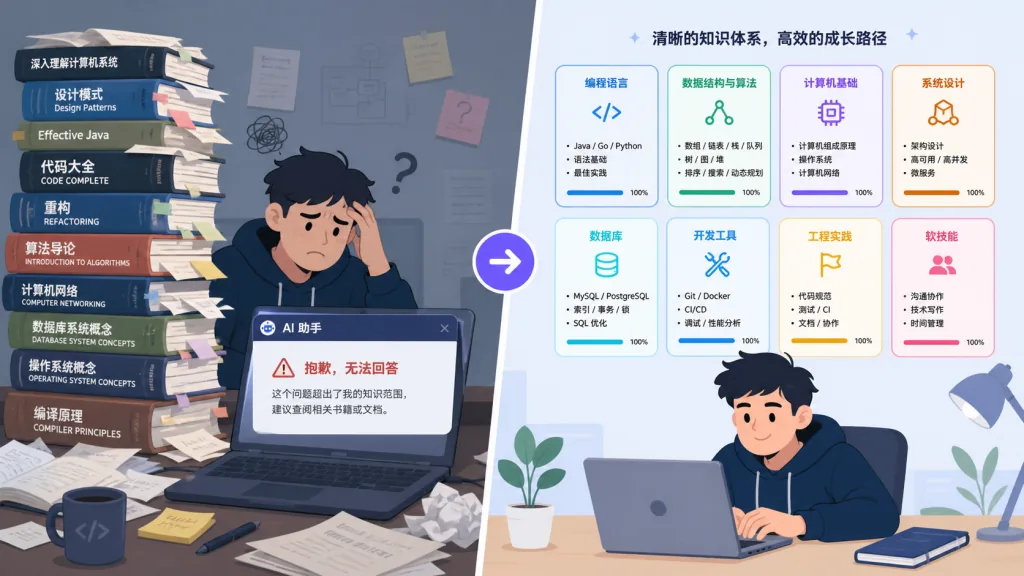
你花 80 美元买了一本经典技术书,啃了两周做了笔记,以为能用一辈子。三个月后项目上线遇到问题,你想问"这本书第 7 章讲过的主从复制方案"——翻 PDF 找不到页码,问 AI 它说"未提供相关文档",打开笔记 200 行密密麻麻不愿看。
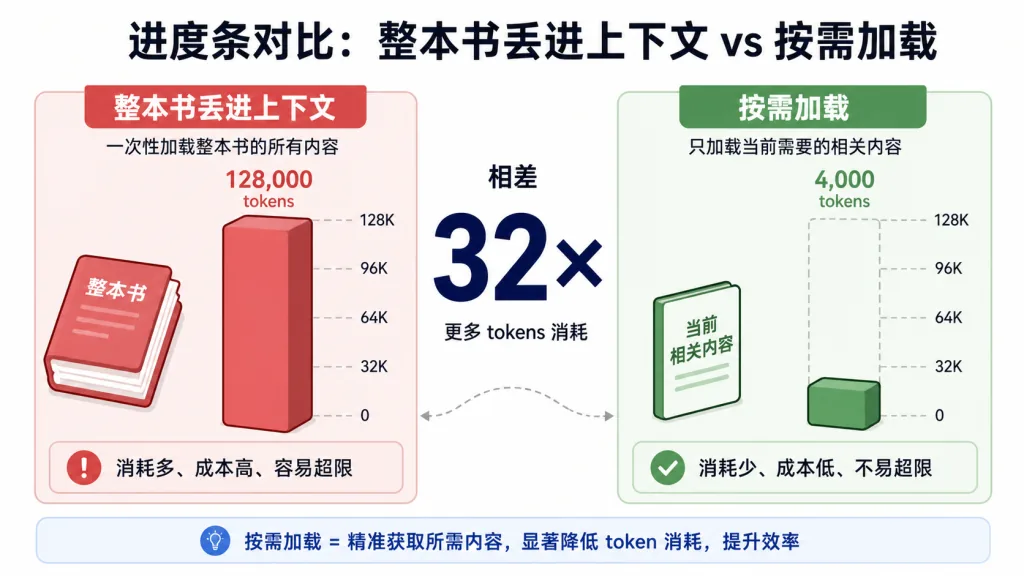
这不是个例。Stack Overflow 调研显示,开发者平均每人收藏 23 本技术书,真正反复查阅的不到 1 本。问题出在:PDF 是为人类阅读设计的,不是为 AI 调用设计的。把整本书丢进上下文,AI 每次都要重新翻目录、回溯、扫整文,token 消耗是回答真实问题的 24–51 倍,而它依然会一本正经地编造答案。
我们需要的不是"书的内容进了 AI 上下文",而是"AI 真正按需读懂书"。book-to-skill 就是为此而生。
二、项目简介:一句话说明它是什么
book-to-skill 是一个 Python 工具,专门把任意技术书 PDF(或 EPUB、DOCX、Markdown 等 7 种格式)转成 Claude Code、GitHub Copilot CLI、Amp 等 AI Agent 可加载的标准化技能文件。
- GitHub Stars:20,738(2 周内增长)
- 核心特性:本地转换 · 按需加载 · 24×–51× token 节省 · 兼容开放 Agent Skills 标准
- 许可证:MIT
它在 GitHub 趋势平台 Trendshift 持续占据 Python 类日榜前三,开发者用"一句话 PR"就能把使用案例贡献到独立仓库。
三、核心功能深度解析
1. 三步把书变成可调用的技能
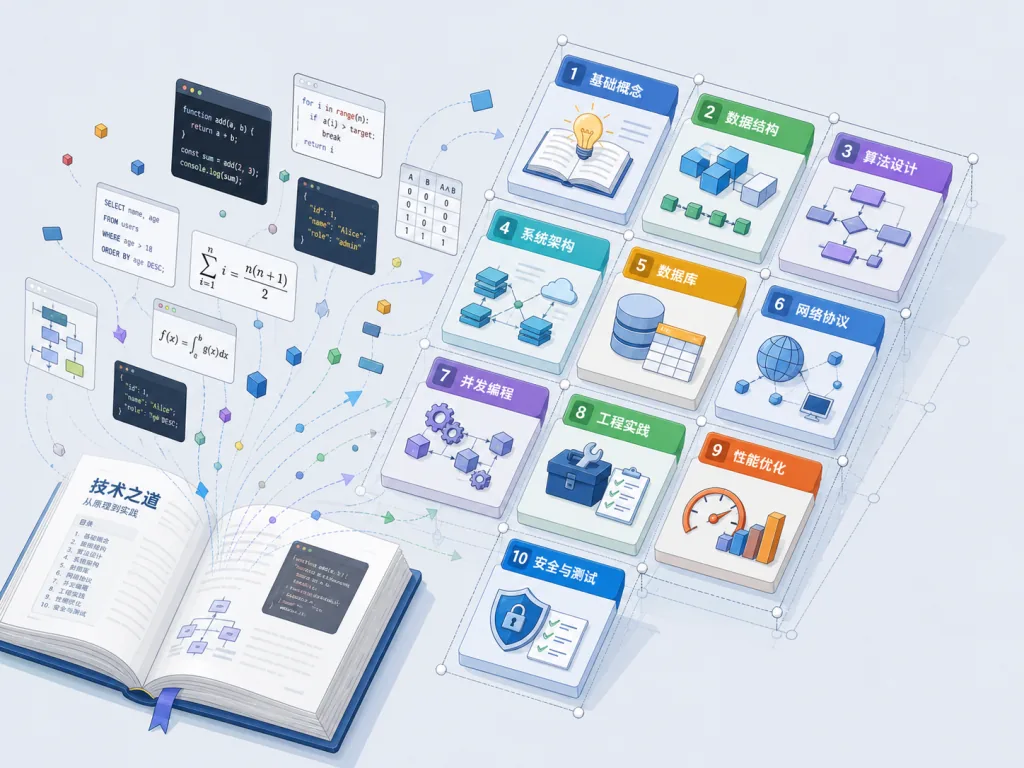
工具用法极简:点路径 /book-to-skill ./my-book.pdf → 自动识别章节并蒸馏出框架、决策规则、反模式 → 生成到对应 Agent 的 skills 目录(如 Claude Code 写到 ~/.claude/skills/<书名简写>/)。输出不是摘要,而是结构化知识。
2. 多格式输入支持
支持 PDF、EPUB、DOCX、Markdown、HTML、RTF、MOBI 共 7 种格式。技术书自动走 docling(保留代码块、表格、公式),纯文字书走 pdftotext(速度更快)。扫描版 PDF 会先检测空白页并提示需先 OCR,避免跑完全书却拼出空技能。
3. 按需加载的 SKILL.md 五件套
生成结果包含:核心心智模型 + 章节索引(~4,000 token)、按章节拆分的文件(每章 ~1,000 token)、字母排序的术语表(~1,500 token)、所有模式与算法(~2,000 token)、速查决策表(~1,000 token)。章节文件不主动加载,只有你问到对应主题时才进入上下文。
4. 不止于书,文档站也能转
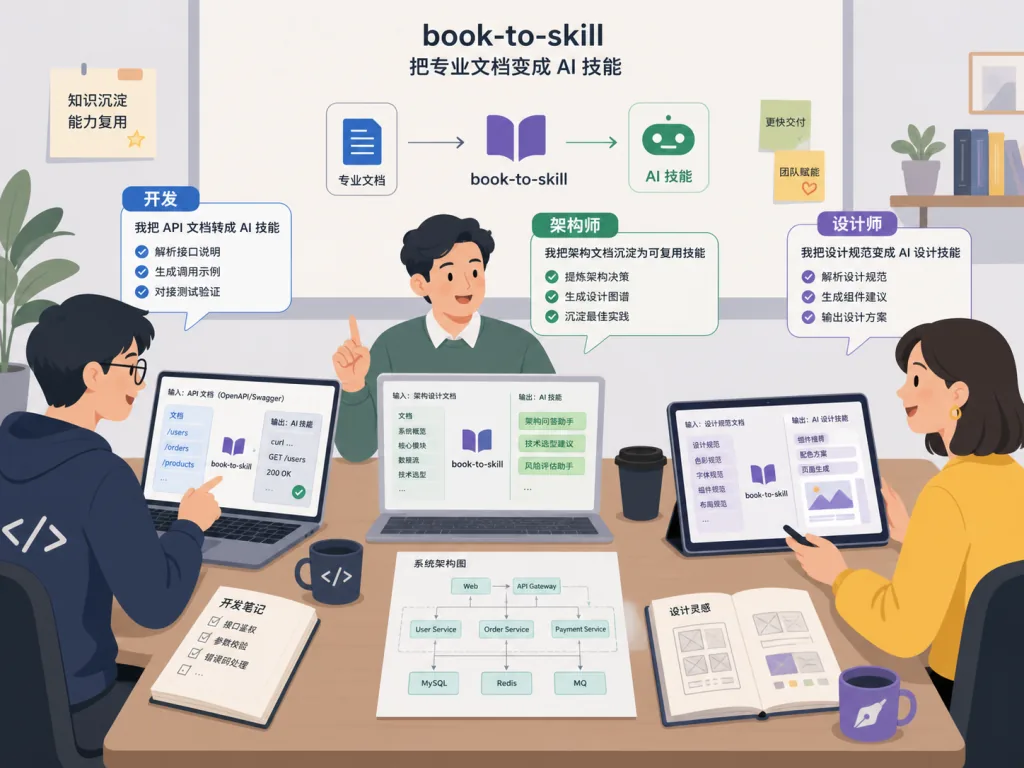
输入是结构化散文就能跑。架构决策记录(ADR)、运维 Runbook、品牌手册、API 规约、RFC、合规章程——任何一份你反复打开却记不住的文档,都是合格的"目标书"。
四、技术亮点与性能数据
核心创新:把"发现循环税"前置一次性付清。传统 PDF 阅读 Agent 每轮都要重读目录、回溯整书做理解;book-to-skill 在转换阶段就把全书结构化,查询时只加载真正相关章节,token 消耗与答案长度成正比,与书厚度无关。
实测算下来,回答同一问题,转换后技能相比把整本书丢进上下文,token 消耗降低 24× 到 51×(评测数据见官方 docs/performance.md)。一本 600 页的数据库系统书,平均会话成本从数美元降到几美分。
架构上分两半:Python 提取器(文档→干净文本+元数据)+ 规范驱动的生成器(Agent 遵循 SKILL.md 把文本变成结构化技能)。本机处理,文件不上传;输出是框架、定义、决策规则的合成衍生品,不复制任何原文段落。
五、适用场景与人群
典型场景:
- 资深工程师把经典技术书(如《DDIA》《SRE 手册》《TCP/IP 详解》)变成可对话的 AI 顾问
- 架构师把内部 ADR 与 Runbook 整合成统一技能,问"新服务上线该跑哪些检查清单"秒得答案
- 设计团队把品牌手册转成可查询的 AI 助理,告别 60 页 PDF 来回翻
适合谁:每天与 AI 编程助手协作的开发者、需要把团队知识沉淀成可调用资产的技术负责人、希望系统性消化技术书的进阶学习者。
不适合谁:只想做一次性 PDF 摘要的轻度用户;只处理扫描版 PDF 且不愿提前 OCR 的场景;不愿自备合法的书源文件的人。
六、竞品对比
| 工具 | 输入 | 输出 | Token 成本 | 幻觉控制 | 标准化 |
|---|---|---|---|---|---|
| 把 PDF 丢给 ChatGPT | 原文 | 自由问答 | 高(整书上下文) | 弱 | 无 |
| 通用 PDF 摘要器 | 原文 | 摘要 | 中 | 弱 | 无 |
| NotebookLM | 原文 | 自由问答 | 中 | 中 | 锁定 Google 生态 |
| book-to-skill | 7 种格式 | 结构化技能 | 极低(按需加载) | 强(基于真实章节) | 开放 Agent Skills 标准 |
核心差异:别人解决"让 AI 看到书",book-to-skill 解决"让 AI 真正按需读懂书"。输出遵循 Agent Skills 开放标准,Claude Code、Copilot CLI、Amp 三家都能用,不被单一厂商绑定。
七、如何快速上手
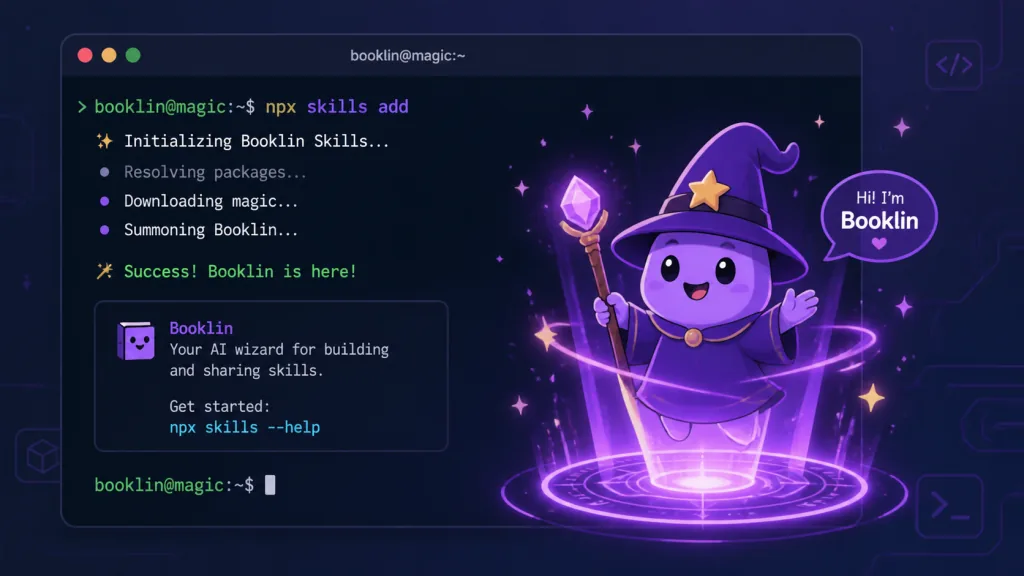
一行命令安装(通过跨 Agent 的 skills CLI):
npx skills add virgiliojr94/book-to-skill
或手动克隆到对应 Agent 的 skills 目录:
git clone https://github.com/virgiliojr94/book-to-skill.git ~/.claude/skills/book-to-skill
最小可用流程:先跑 python3 scripts/extract.py --check 检查环境依赖,然后执行 /book-to-skill ./你的书.pdf,几分钟后在终端输入 /书名简写 你的问题 即可调用。技术书建议先装 docling(pip3 install docling),纯文字书装 poppler-utils 即可。
进阶玩法:把一整个 docs/ 文件夹折叠成一个技能,持续 update/fold-in 新文档;用 tools/discovery_tax.py 自测 token 节省倍数。
八、总结与行动建议
book-to-skill 重新定义了"人和书的关系":书不再是放在书架上吃灰的 PDF,而是你 AI 助手随时能调用的结构化记忆。24×–51× token 节省是真金白银的成本下降,按需加载是从根本上解决 AI 幻觉的工程方案。
如果你家里有几本反复查阅却记不住的技术书,立刻试一次 /book-to-skill,把第一本书变成你的 AI 技能。仓库地址:https://github.com/virgiliojr94/book-to-skill ,文档、基准测试、架构说明都齐全。
一句话推荐:让 AI 真正读懂你的书,而不是假装读过它。