一、开篇:为什么你需要这个工具?
做量化研究的朋友都懂一个痛点:通用时序大模型在金融 K 线面前频频失灵。A 股一分钟线噪声占比超过 60%,加密货币更是 24 小时震荡,传统 Transformer 直接拟合 OHLCV(开盘/最高/最低/收盘/成交量)连续值就像用漏勺盛水——抓不住离散结构,更学不会市场的「语法」。
更现实的问题是,开源界长期缺少专为金融 K 线设计的预训练底座。研究人员想微调,只能拿 GPT 类通用模型硬扛;想用专用模型,又被付费接口和封闭权重挡在门外。直到 Kronos 出现——一个专门为 K 线「学说话」的基础模型,把 45 家全球交易所的数据压缩进 499M 参数里,还直接开源了三个规格的权重。
二、项目简介:一句话说明它是什么
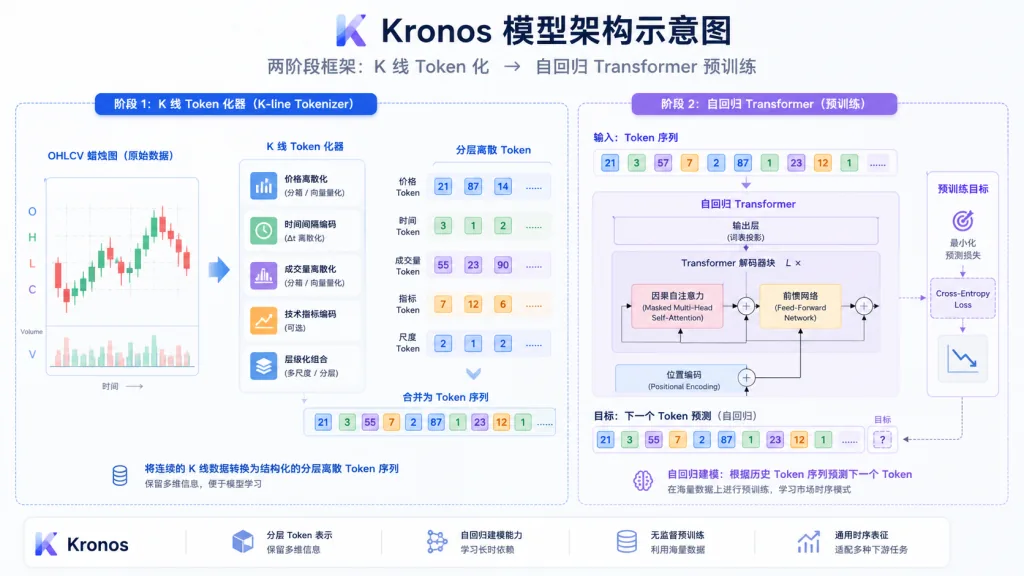
Kronos 是全球首个开源的金融 K 线基础模型,主打「K 线的语言建模」路线。它把 OHLCV 连续序列先量化成分层离散 Token,再喂给自回归 Transformer 做大规模预训练。截至 2025 年 11 月,GitHub Stars 已突破 36.8K,被 AAAI 2026 接收,论文同步上线 arXiv(2508.02739)。
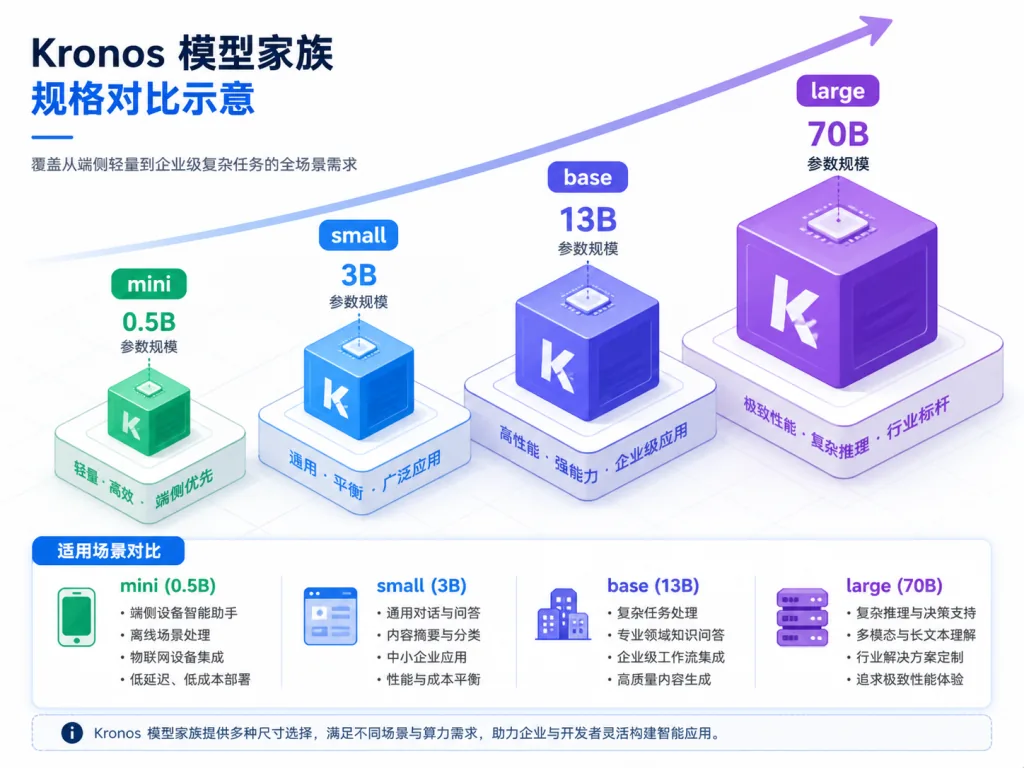
四个核心关键词:金融专用、Token 化预训练、多任务统一、全规格开源。目前已开源 Kronos-mini(4.1M)、Kronos-small(24.7M)、Kronos-base(102.3M)三个版本,Large 版本(499.2M)尚未开放权重。
三、核心功能深度解析
1. 两阶段 K 线 Token 化框架
Kronos 的核心创新在于把 K 线当成「语言」处理。第一阶段,专用的 Kronos-Tokenizer 把连续多维 OHLCV 数据量化成分层离散 Token,保留开盘价、收盘价等不同字段的语义层级;第二阶段,自回归 Transformer 在这些 Token 上做大规模预训练,输出统一表征。相比直接回归数值,这种方式更抗噪,也更容易迁移到分类、生成等下游任务。
2. 统一多任务接口
Kronos 把价格预测、波动率建模、信号生成等典型量化任务统一到同一个预训练底座,无需为每个任务单独设计模型头。用户只需更换 Tokenizer 与 Predictor 的组合,就能从 4.1M 到 499.2M 灵活选型,单卡笔记本也能跑 mini 版做实验。
3. 批量并行预测
predict_batch 接口支持多资产并行预测,所有序列共用同一组超参数(温度 T、top-p 采样、采样次数)。在多 GPU 环境下,吞吐可提升 3–5 倍,特别适合做因子扫描和组合回测前的批量打分。
4. 完整微调与回测流水线
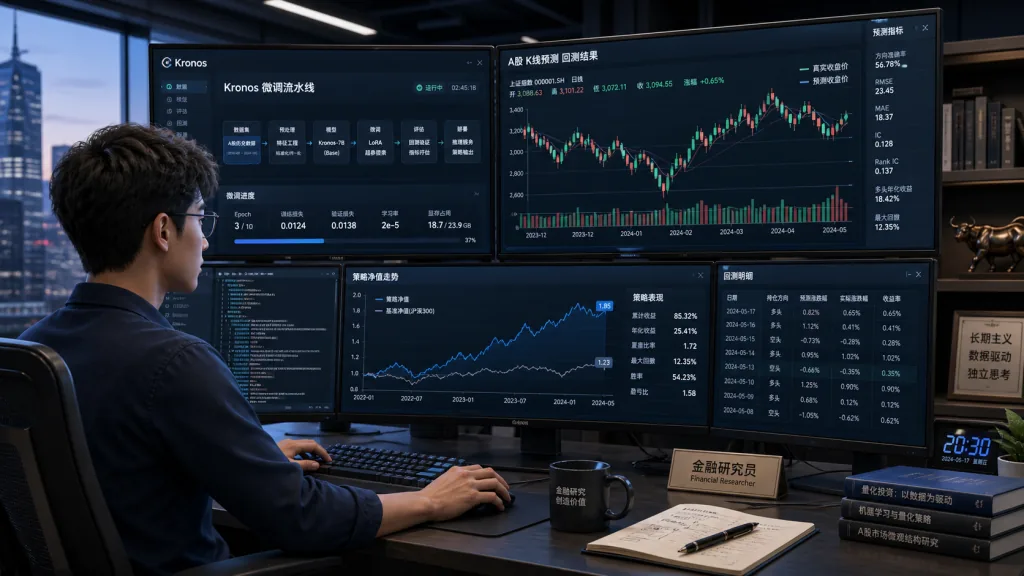
项目内置基于 Qlib 的微调示例,覆盖 A 股日频数据预处理、Tokenizer 与 Predictor 的双阶段微调、Top-K 简单回测。虽然官方明确声明这只是 Demo 而非生产级策略,但整条链路已经打通,研究人员可以照葫芦画瓢迁移到自己的数据集。
四、技术亮点与性能数据
Kronos 的训练数据覆盖 45 家全球交易所的跨市场 K 线,是目前公开的最大规模 K 线预训练语料。模型架构采用 Decoder-only Transformer,配合分层 Token 化,在多项金融预测基准上明显优于 TimeGPT、Lag-Llama 等通用时序基线。
生态兼容性方面,权重全部托管在 Hugging Face Hub(NeoQuasar 组织),一行 from_pretrained 即可加载;同时支持 PyTorch + torchrun 多卡微调,与 Qlib、pandas、matplotlib 无缝衔接。论文已被 AAAI 2026 接收,社区维护活跃,最近一次更新在 2025 年 11 月。
五、适用场景与人群
量化研究员:需要快速验证 K 线预测因子,又不想从零训练 Transformer 的同学,Kronos-mini 4.1M 参数的轻量级版本,单卡 GPU 即可微调。
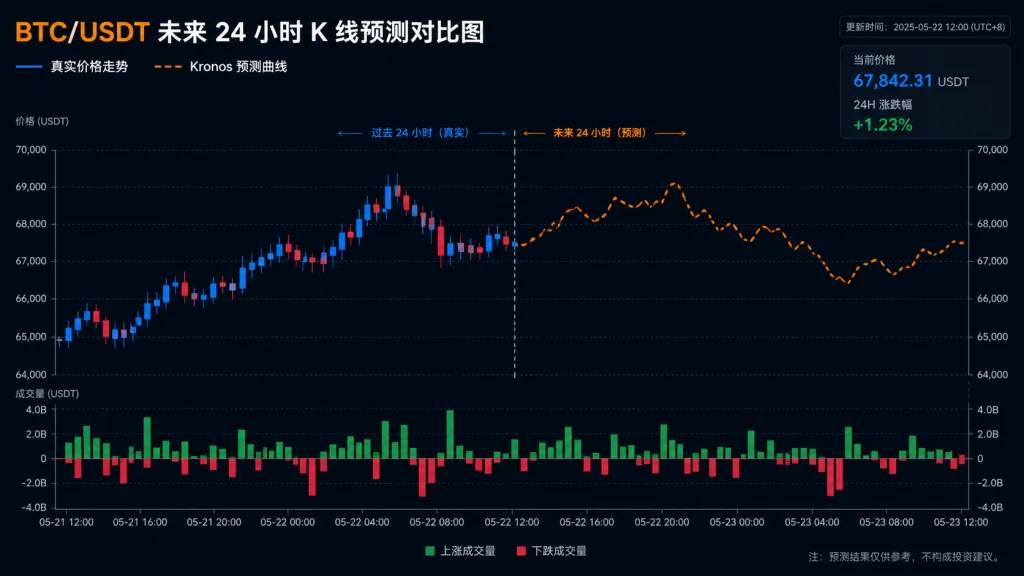
加密货币与外汇交易者:BTC/USDT 等 24 小时品种对噪声极敏感,Kronos 在 Live Demo 中展示了未来 24 小时的预测效果,可作为辅助信号源。
高校与金融机构研究者:希望复现 AAAI 2026 论文、做对比实验或迁移到私有数据的团队,可直接基于开源权重微调。
不适合谁:追求「开箱即用、稳定年化」的散户交易者——Kronos 提供的是研究底座,不是带风控的策略产品。
六、竞品对比
| 项目 | 数据范围 | 开源情况 | 金融专用 | 最小模型规模 |
|---|---|---|---|---|
| Kronos | 45 家交易所 K 线 | 三个规格全开源 | ✅ | 4.1M |
| TimeGPT-1 | 通用时序 | 闭源 API | � | 不公开 |
| Lag-Llama | 单变量时序 | 开源 | ❌ | 通用 |
| Chronos | 通用时序 | 开源 | ❌ | 8M |
对比之下,Kronos 在「金融 K 线专用 + 完整开源 + 多规格可选」三个维度同时占优,且预训练数据规模远超同类开源项目。
七、如何快速上手
环境准备只需三步:Python 3.10+、pip install -r requirements.txt、准备好包含 open/high/low/close 列的 CSV 数据。
最小可用示例(4 步拿到预测):
from model import Kronos, KronosTokenizer, KronosPredictor
import pandas as pd

tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base")
model = Kronos.from_pretrained("NeoQuasar/Kronos-mini")
predictor = KronosPredictor(model, tokenizer, max_context=2048, device="cuda:0")

df = pd.read_csv("data.csv")
pred_df = predictor.predict(df=df, x_timestamp=df['timestamps'][:400],
                           y_timestamp=df['timestamps'][400:520], pred_len=120)
进阶建议:从 Kronos-mini 开始做实验,确认数据格式 OK 后,再切换到 Kronos-base 提升精度;要做 A 股因子研究,直接复用 finetune/ 目录下的 Qlib 流水线。
八、总结与行动建议
Kronos 的核心价值在于「把金融 K 线变成一种可被基础模型学习的语言」:分层 Token 化解决噪声问题,自回归 Transformer 解决多任务统一问题,全规格开源解决工程落地问题。对任何想跳过「从零造模型」阶段的量化团队来说,这都是 2025 年最值得收藏的金融大模型底座。
使用建议:先用 Demo 跑通 BTC/USDT 24 小时预测,再用 mini 版在自有数据上做微调验证,最后按需升级到 base 或申请 large 权限。
项目链接:
- GitHub 仓库:https://github.com/shiyu-coder/Kronos
- Hugging Face 模型:https://huggingface.co/NeoQuasar
- Live Demo:https://shiyu-coder.github.io/Kronos-demo/
- 论文:https://arxiv.org/abs/2508.02739
一句话推荐:Kronos 把 K 线变成了 NLP 的 WordPiece——从此,金融时序建模有了一个真正可微调、可商用、可复现的开源底座。