一、开篇:为什么你需要这个工具?
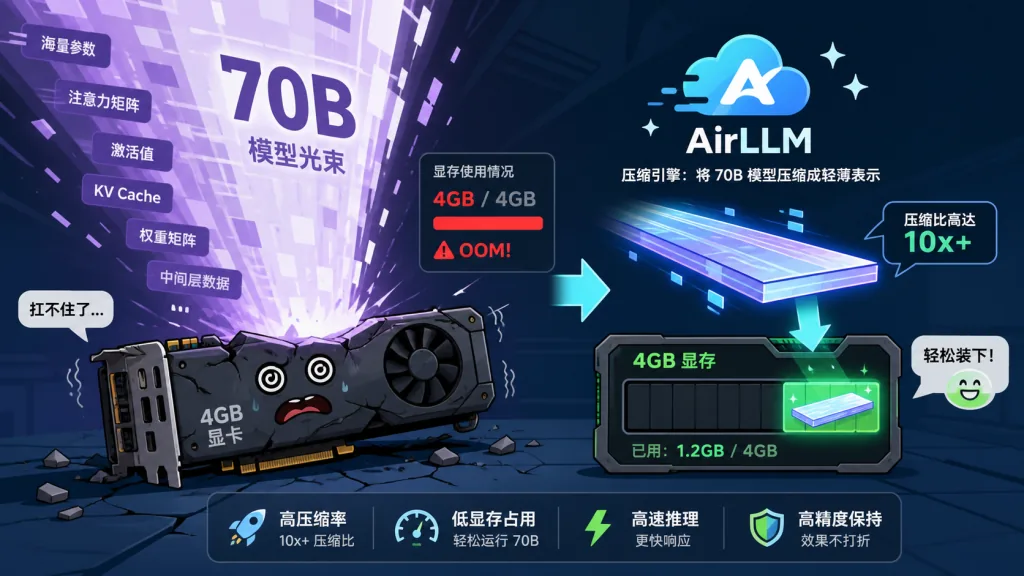
手握一张 4GB 显存的老显卡,却想跑 70B 大模型——这是过去两年无数个人开发者的真实困境。Hugging Face 上 Llama 3.1 70B 的全精度权重就要 140GB,按传统加载方式至少需要 24GB 显存的 A5000。很多人在本地折腾三天,最终只能看着 CUDA out of memory 报错放弃。AirLLM 把这条死胡同直接打通:70B 模型塞进 4GB,405B 模型塞进 8GB,671B 的 DeepSeek-V3 也只要 12GB。GitHub 上 30828 颗星,就是被这条死胡同折磨过的人投的票。
二、项目简介:一句话说明它是什么
AirLLM 是一款「单卡低显存大模型推理框架」,核心特性四个关键词:逐层加载、零量化、AutoModel 自动适配、3 倍压缩加速。项目自 2023 年 11 月发布至今,从 v2.0 引入分块压缩,到 v3.0 支持 FP8,再到 2026 年 7 月跑通 2.8 万亿参数的 Kimi K3,是 GitHub 上把「低显存」和「大模型」两个矛盾词绑得最紧的开源项目。
三、核心功能深度解析
1. 逐层流式加载:把显存占用从「模型大小」降到「单层大小」
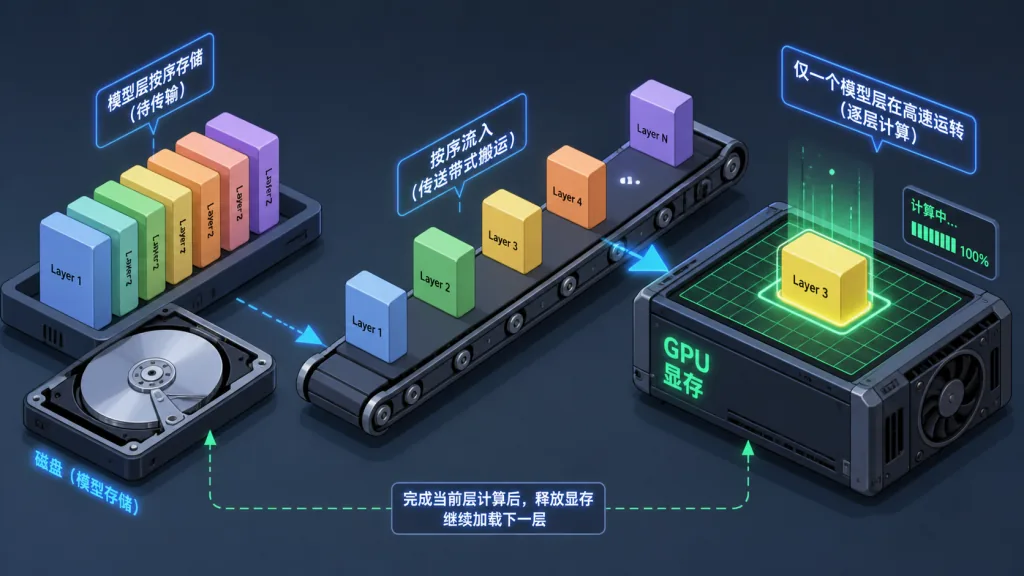
AirLLM 的核心思路极其简单:GPU 一次只保留模型的一层,计算完即卸载,下一层从磁盘流式读入。传统的 model.to('cuda') 把整个模型搬进显存,而 AirLLM 改造了 forward 流程,让每一层在算完后立刻腾位置。这意味着显存占用由「单层权重 + 激活值」决定,与模型总大小无关——这就是 70B 模型能跑进 4GB 的根本原因。
2. AutoModel 自动路由:一个接口兼容所有主流模型
老版本需要根据模型类型选 AirLLMLlama2、AirLLMQWen 等不同类,v2.6 引入 AutoModel 后彻底告别这一负担。无论 Llama 3.x、Qwen3、DeepSeek-V3、Mixtral、ChatGLM 还是 Mistral,统一通过 AutoModel.from_pretrained("repo_id") 调用,框架自动识别架构。底层原理是注册表模式+配置文件嗅探,类似 Transformers 的设计哲学。
3. 块状权重量化压缩:3 倍速度提升
v2.0 引入基于 bitsandbytes 的 4bit/8bit 块状量化,只压缩权重、不压缩激活。原因是 AirLLM 的瓶颈在「磁盘 IO」而不是「计算」,只要让权重变小、加载更快,速度就能起飞。官方测试显示 4bit 压缩带来约 3 倍推理加速,且精度损失几乎不可察觉。
4. 预取机制:把 IO 和计算重叠起来
v2.5 加入 prefetching,在 GPU 算当前层的同时,CPU 端异步预读下一层权重,把串行的「加载→计算」变成部分重叠的流水线。根据官方说明,这一改动带来约 10% 的速度提升。
5. 稀疏 MoE 单专家流式:撑起万亿模型
对于 Mixtral、Qwen3-MoE、DeepSeek-V3 这类 MoE 模型,AirLLM 进一步细化粒度:只把当前 token 路由到的专家加载进显存。Kimi K3(2.8T 参数)的 3.72GB 显存占用即由此而来——专家按需流式加载,理论上支撑无限大的 MoE 模型。
四、技术亮点与性能数据
核心性能数据(来源:官方 README 表格):
| 模型 | 参数规模 | 显存占用 |
|---|---|---|
| Qwen3 / Mistral / Phi (8B) | 8B | 1–2 GB |
| Qwen3-30B / Mixtral MoE | 30–47B | 1–3 GB |
| Qwen3-235B MoE | 235B | ~3 GB |
| Llama 3.x 70B 全精度 | 70B | ~4 GB |
| Llama 3.1 405B | 405B | ~8 GB |
| DeepSeek-V3 | 671B | ~12 GB |
| Kimi K3 MoE | 2.8T | 3.72 GB |
架构亮点:纯 PyTorch 实现,无需编译自定义 CUDA 算子;底层采用 safetensors 分片;MacOS 通过 mlx 适配 Apple Silicon;v3.0 支持 FP8 权重直读。生态兼容性上,已覆盖 Llama 2/3/3.1/3.3/4、Qwen 全系、DeepSeek V2/V3/R1、Phi-4、Gemma 等几乎所有主流开源 LLM。
五、适用场景与人群
个人开发者本地调试:手里只有游戏本(如 RTX 3060 6GB),想本地跑 70B 模型做 prompt 工程或 RAG 验证,AirLLM 是目前唯一可行方案。
学术研究者低成本实验:学生或独立研究者预算有限,无法租用 A100/H100 集群,可用 AirLLM 在单卡上完成 70B–405B 模型的 baseline 复现。
边缘部署与原型验证:在 Jetson、MacBook M2/M3 等低显存设备上快速验证大模型可行性,再决定是否采购高端硬件。
不适合的场景:对推理延迟敏感的高并发在线服务(逐层流式 IO 会成为瓶颈),以及需要全模型同时驻留显存做训练微调的场景。
六、竞品对比
| 方案 | 70B 显存需求 | 是否量化 | 速度损失 | 适用规模 |
|---|---|---|---|---|
| AirLLM | ~4 GB | 无 | 略慢于全显存 | 8B–2.8T |
| GPTQ/AWQ 4bit 量化 | ~20 GB | 是 | 接近原速 | 7B–70B |
| llama.cpp (GGUF) | ~24 GB (Q4) | 是 | 接近原速 | 7B–70B |
| vLLM / TGI | ~140 GB+ | 无 | 最快 | 单机多卡 |
| 设备卸载 (HuggingFace device_map) | ~12 GB | 无 | 较慢 | 7B–13B |
AirLLM 的核心优势:在「不量化」「不剪枝」「不蒸馏」的前提下,把显存占用压到极致;劣势是磁盘读写成为瓶颈,速度慢于全显存方案。选它的理由很简单——当你没有大显存又不想损失模型精度时,它是当下唯一的选择。
七、如何快速上手
安装:
pip install airllm
最小可用示例(以 Qwen3-32B 为例):
from airllm import AutoModel

model = AutoModel.from_pretrained("Qwen/Qwen3-32B")

input_tokens = model.tokenizer(["What is the capital of United States?"],
    return_tensors="pt", return_attention_mask=False, truncation=True, max_length=128, padding=False)

generation_output = model.generate(input_tokens['input_ids'].cuda(), max_new_tokens=20, use_cache=True, return_dict_in_generate=True)

print(model.tokenizer.decode(generation_output.sequences[0]))
进阶建议:
- 想跑更大的模型?加上
compression='4bit'可获得约 3 倍速度提升,同时显存占用更小。 - 磁盘不够?设置
delete_original=True自动删除原始 HF 模型,仅保留分片版本。 - 首次运行会进行模型分层切分并缓存,请预留足够磁盘空间(建议 2 倍模型大小)。
- 想跑 Apple Silicon?安装
mlx后可直接使用,无需任何额外配置。
八、总结与行动建议
AirLLM 用「逐层流式 + MoE 单专家流式」这套工程技巧,重新定义了大模型推理的硬件门槛。它不是最快的方案,但一定是最普惠的方案——把 70B 拉进 4GB,把 2.8T 拉进 4GB,让显卡不再是玩大模型的入场券。
项目地址:https://github.com/lyogavin/airllm
一句话推荐:买不起 A100 也能玩 70B,AirLLM 是穷人的大模型自由。