一、开篇:写一篇论文,到底要踩多少坑?
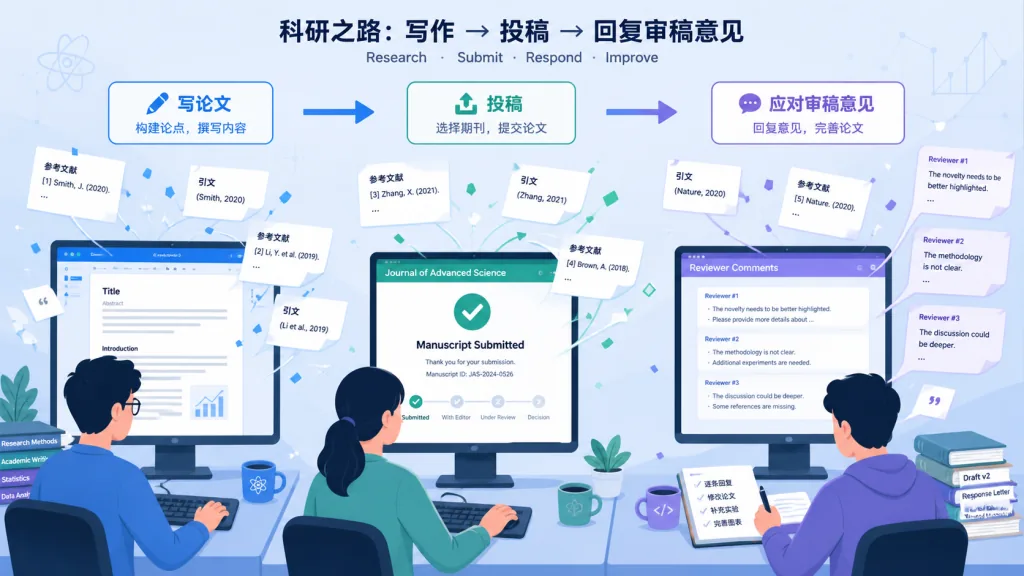
博士生 A 写到第三章,导师一句「文献综述不够深」打回来重写;青年学者 B 投稿 IEEE,被审稿人指出「3 篇参考文献是编造的」;研究生 C 改完 R1,准备 R2,发现 reviewer 关注的问题和上一轮完全错位。三个人共同的痛点:学术写作从来不是单人能完成的事,但协作的每个环节都在掉链子——文献检索漏、参考文献造假、引文与论点脱节、审稿意见解析错、修改无从下手。这些坑不会因为你换更强的模型就消失,根因在流程。
二、项目定位:Academic Research Skills 是什么
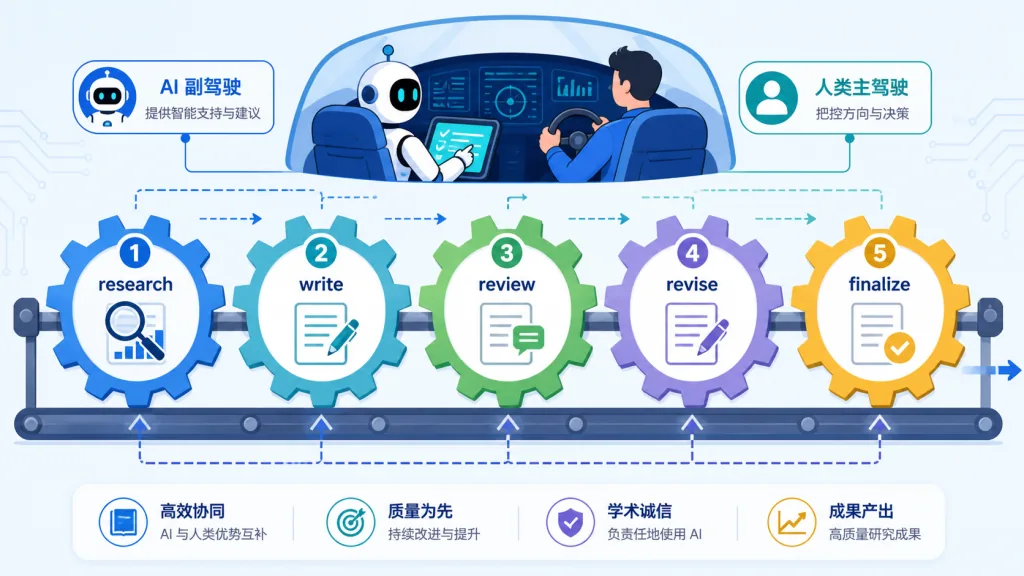
GitHub 上 Imbad0202/academic-research-skills(42k+ Stars)是一套面向 Claude Code 的学术研究技能套件,把论文生产链路拆成 research → write → review → revise → finalize 五个阶段。当前版本 v3.19.0,已经走过 19 次大迭代。核心标签:Human-in-the-loop、AI 副驾驶、引用可信链、跨模型盲检。项目用一句话定位自己——「AI 是副驾驶,不是主驾驶」,副驾驶帮你处理脏活:扒文献、查引用、核数据、检逻辑;主驾驶始终是你。
三、核心功能深度解析
1. Deep Research:13 名 Agent 组成的科研侦察连
Deep Research 不是「一个模型 + 一个 prompt」那么简单。它拆出 13 个 Agent,覆盖 Socratic 引导、PRISMA 系统综述、意图识别、对话健康监测、Semantic Scholar API 校验八个模式。其中 Socratic 模式最值得展开:v3.0 之后加入了意图识别层,把用户的「探索式对话」和「目标导向任务」区分开——探索模式下禁止「要不要我帮你总结」的过早收束,把最大轮次抬到 60 轮。还偷偷埋了一个 Dialogue Health Indicator,每 5 轮做一次自我体检:持续顺从、回避冲突、过早收敛,发现问题自动注入挑战性问题,且对用户不可见以防被「博弈」。
2. Academic Paper:从大纲到 APA 7 PDF 的写作流水线
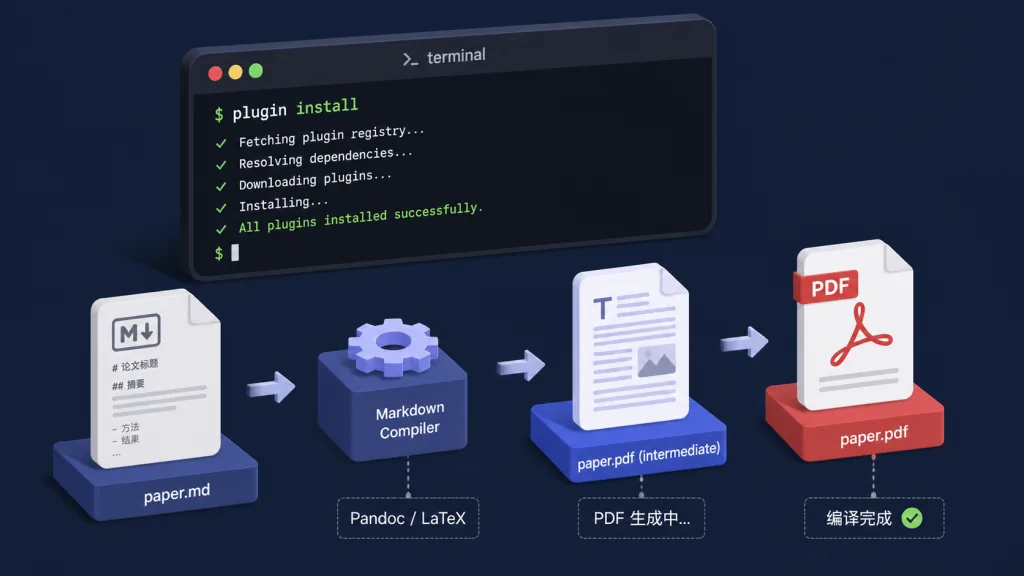
12 个 Agent 串成的写作管线,覆盖 Style Calibration(从你过往论文里学习语气)、Writing Quality Check(捕捉一眼像机器写的句式)、LaTeX 加固、可视化、修改教练、引文转换、防泄漏协议、VLM 图表校验十一种模式。引用格式默认 APA 7.0,也支持 Chicago、MLA、IEEE、Vancouver;论文结构覆盖 IMRaD、专题文献综述、理论分析、案例研究、政策简报、会议论文六种。输出走 Pandoc → DOCX、Tectonic → LaTeX/PDF,DOCX/PDF 不依赖也能直接出 Markdown。
3. Academic Paper Reviewer:7 位审稿人 + 魔鬼代言人
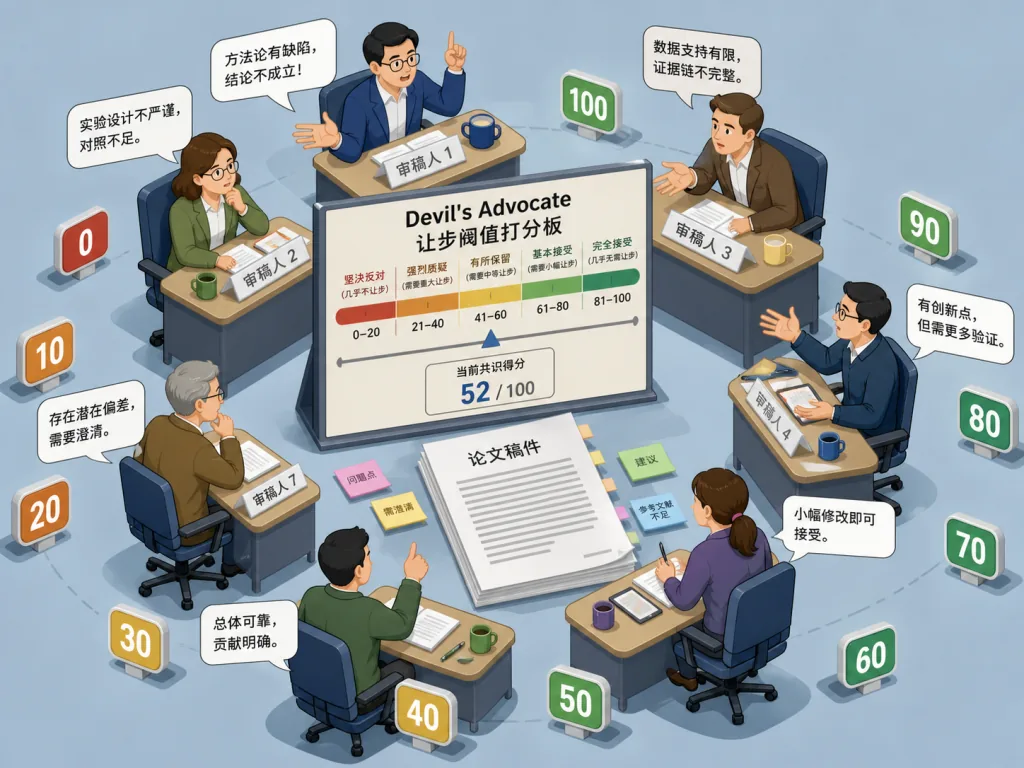
full 模式固定组合:Journal-Fit Reviewer + 3 名动态审稿人 + 1 名 Devil's Advocate,给 0–100 质量分。决策映射写死:≥80 Accept,65–79 Minor Revision,50–64 Major Revision,<50 Reject。重点:DA 不是走过场,它内置 Concession Threshold Protocol——每次反驳先打 1–5 分,≥4 分(反驳直接命中核心攻击且有证据)才允许让步,≤3 分死守原攻击;连续让步检测、让步率追踪、Frame-lock 检测全在台上。这一套是 v3.0 直接逼出来的:作者发现 DA 四轮辩论都在「攻击论点不攻击前提」,从未质疑「我们讨论的这个问题对不对」。
4. Academic Pipeline:10 阶段编排器 + 两道硬门禁
整个学术管线是 10 阶段编排器,每阶段必须用户确认才能进入下一阶段。最狠的是 Stage 2.5 和 Stage 4.5 两道完整性门禁——前者是写作前体检(Showcase 里捕获了 15 个编造文献 + 3 个统计错误),后者是终稿前体检(零回归确认)。门禁里跑一份 7 模式失败清单:实现 Bug、幻觉结果、走捷径依赖、把 Bug 当 Insight 重新包装、方法学捏造、Frame-lock、引文幻觉。这七种失败模式直接引用自 Lu et al. (2026, Nature 651:914–919) 的「The AI Scientist」论文,作为设计依据。
5. 引用可信链:三层定位 + Claim Audit
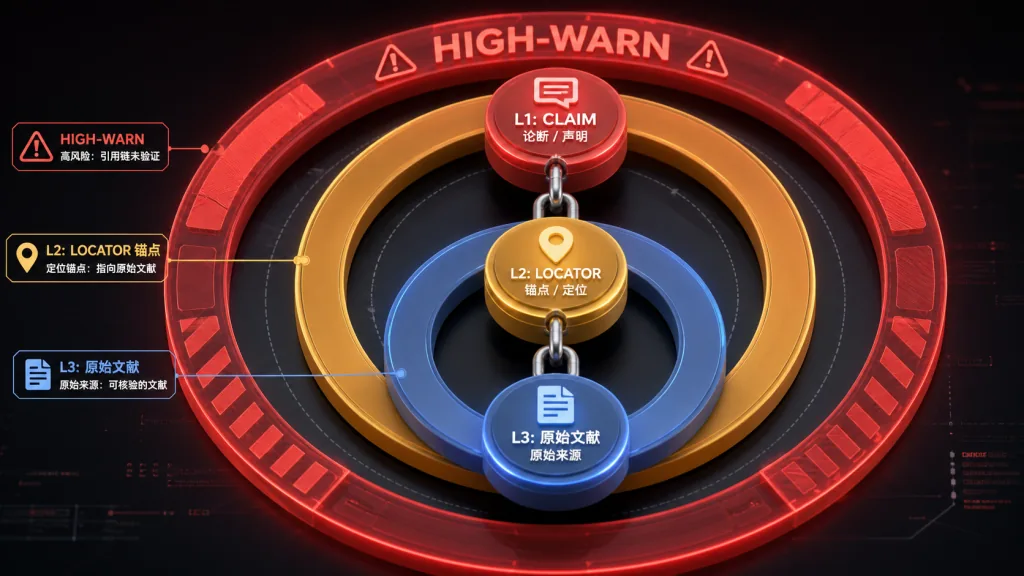
2026-05 的 Zhao et al. 跨 2.5M 篇论文、1.11 亿条引文的审计触发了 v3.7 的重写:当年度估计 14.6 万条幻觉引文,「真实引文支持错误论点」描述为开放挑战。v3.7.x 加入三件事:参考文献前置数据可追溯(trust-chain frontmatter)、三层定位锚点(locator infrastructure)、Claim Audit 审计开关(ARS_CLAIM_AUDIT=1)。打开开关,每条引文自动拉原文核对,判断论点是否真的被引文支持;判定失败的五个 HIGH-WARN 类(claim-not-supported、negative-constraint-violation、fabricated-reference、anchorless、constraint-violation-uncited)会被格式化器强行拒绝输出。
四、技术亮点与性能数据
- 10 阶段管线 + 39 个 Agent 总规模:4 个核心技能(Deep Research / Paper / Reviewer / Pipeline),每个技能都有专属 Agent 团队。
- 成本透明:一份 1.5 万字论文走完全流程约 4–6 美元,文档
docs/PERFORMANCE.md给出每模式 token 预算。 - 跨模型盲检:
ARS_CROSS_MODEL开关下,主人/调度员/主人三段盲检路径走标准[CROSS-MODEL-HANDOFF v1]协议,配套 Python 语法解析器scripts/cross_model_handoff.py,不再靠「请遵守」式的散文式约束。 - Socratic 模式跨语言意图识别:意图基于语义而非关键词,所以 Socratic 引导在任意语言下都能工作;通用 Trigger Keywords 部分目前覆盖英、繁中,可手动扩展。
- Data Access Level + Task Type 标注:每个技能声明
data_access_level(raw / redacted / verified_only)和task_type(open-ended / outcome-gradable),由check_data_access_level.py强制;模式来自 Anthropic 2026 的 automated-w2s-researcher 实践。 - 生态面:支持 Claude Code、Claude Science(GitHub 直导入)、Pi、Codex CLI;多语言 README 覆盖简中、繁中、日文、韩文。
五、适用场景与人群
- 场景 1:博士/硕士研究生独立完成首篇英文论文:Socratic 模式拆章节、Plan 模式搭大纲、Style Calibration 学习语气、引用可信链兜底幻觉。
- 场景 2:青年学者投稿 IEEE/Springer/Elsevier:Journal-Fit Reviewer 选刊,DA 防 frame-lock,Stage 4.5 完整性门禁 + Post-Publication Audit(Showcase 抓到 21/68 处三轮门禁都漏掉的问题)。
- 场景 3:交叉学科团队多人协作写综述:13 名 Agent 做的 systematic review + PRISMA 双校验、跨模型盲检避免同认知框架的假阳性、Material Passport 跟踪每个声明的证据链。
- 不适合:不愿做人类把关的人(整套设计的核心前提就是 Human-in-the-loop)、想用 ARS 跑实验的人(实验请用配套的 experiment-agent,ARS 自身不执行实验)、想拿 byte-级可复现 LLM 输出的人(文档明确说「LLM 输出无法字节复现」)。
六、竞品对比
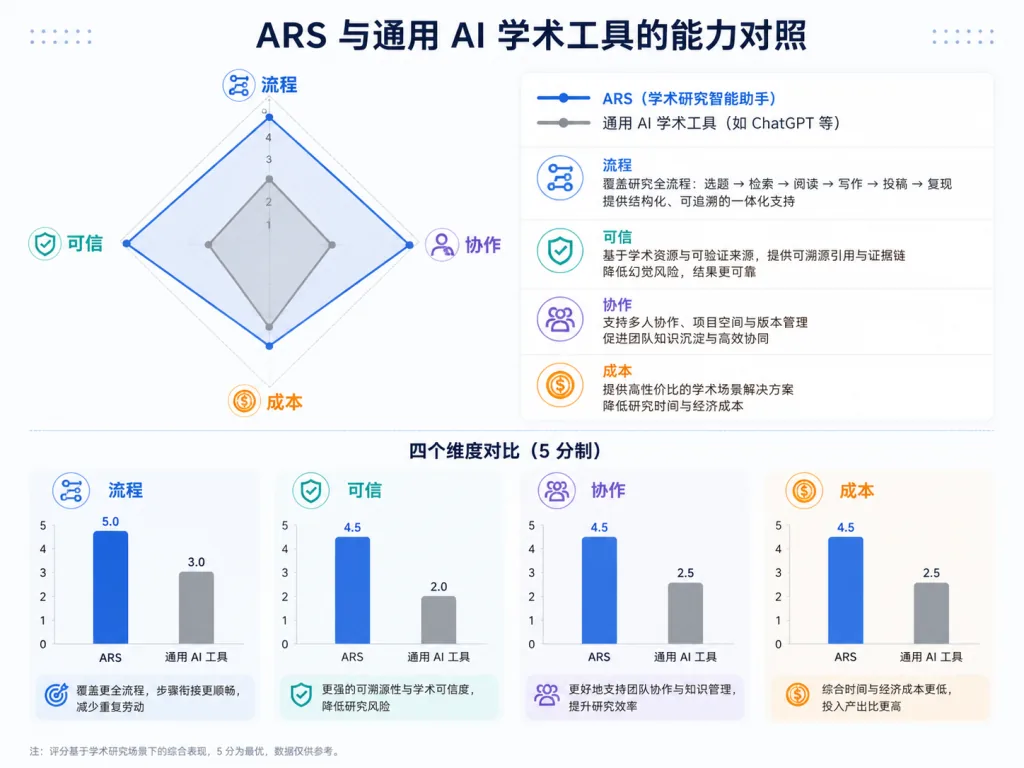
| 维度 | academic-research-skills (ARS) | Elicit / Consensus / Scite 等通用 AI 学术工具 | 直接调用 ChatGPT/Claude |
|---|---|---|---|
| 覆盖链路 | research → write → review → revise → finalize 完整闭环 | 多停留在文献检索/问答阶段 | 单点能力,需自己串流程 |
| 引用可信 | 三层定位 + Claim Audit + trust-chain frontmatter | 多数不做 Claim 级别对齐校验 | 易出现「真引文支持错论点」问题 |
| 审稿机制 | 7 Agent 多视角 + DA + 0–100 rubric + 让步阈值 | 通常单一视角打分 | 没有 rubric 框架 |
| Human-in-the-Loop | 强制每阶段确认 + 两道硬门禁 | 大多自动放行 | 完全靠用户自觉 |
| 成本/可控性 | 1.5 万字约 4–6 美元,开源 | 订阅制,闭源 | API 成本按 token,技术栈不可控 |
一句话:ARS 把「流程」「可信」「协作」三件事做成了一等公民,通用工具把这三件事留给用户。
七、如何快速上手
最快路径(v3.7.0+):
/plugin marketplace add Imbad0202/academic-research-skills
/plugin install academic-research-skills
环境准备:装好 Claude Code 并导出 ANTHROPIC_API_KEY;可选 Pandoc(DOCX 导出)+ Tectonic + Source Han Serif TC(APA 7.0 PDF)。
最小可用示例:
打开 Claude Code,输入 /ars-plan 并描述你正在写的论文,ARS 用 Socratic 对话带你梳理章节结构;如果你只想试单点能力,输入 /ars-lit-review "你的课题"。
进阶: 想在 Claude Science 用,GitHub URL 直导入(需 v3.14.0+),导入后只携带 ARS 方法论,slash 命令/Hook 不迁移;想跑实验,前后衔接 experiment-agent 仓库;想跑跨模型盲检,设 ARS_CROSS_MODEL=1;想做 Claim Audit,设 ARS_CLAIM_AUDIT=1。完整六种安装方式看 docs/SETUP.md。
八、总结与行动建议
学术研究 Skills 的核心价值一句话:把 AI 当副驾驶,把流程当主驾驶。它不替你写论文,但是帮你把写论文过程中的脏活——文献检索、引用核查、逻辑一致性、统计把关、审稿对抗——收敛进 10 阶段管线和两道硬门禁里,让你专心做「定义问题、选方法、解释数据、写出 I argue that 之后那句真正属于你的句子」这些只有人类能做好的事。
使用建议:从 /ars-plan 或 /ars-lit-review 切入熟悉流程;正式投稿前确保 Stage 4.5 完整性报告通过、Post-Publication Audit 跑过;引用密集型工作打开 ARS_CLAIM_AUDIT=1。
项目地址:https://github.com/Imbad0202/academic-research-skills;文档入口 https://docs.claude.com/en/docs/claude-code/setup;配套实验仓库 https://github.com/Imbad0202/experiment-agent。如果你也厌倦了一个人和论文死磕,不妨把它装进 Claude Code,让副驾驶上线。