一、开篇:为什么你需要这个工具?
做 AI 应用的开发者,谁没被「接口碎片化」折磨过?想接 GPT,要去 OpenAI 申请 key;想用 Gemini,得换一套调用方式;想跑 DeepSeek,又要适配另一套 SDK。每个厂商一套鉴权、一套限流、一套错误码,光是写适配层就占去了项目一半工期。
更现实的问题是:个人开发者、学生、独立研究者,预算有限,跑不动全线付费 API。可一旦想尝试不同模型的能力差异,又只能一家一家去薅免费额度,账号管理成本陡增。
GitHub 上有一个 66.5K Stars 的项目,把这件事一次解决了——用一套统一接口调用 GPT、Claude、Gemini、DeepSeek、Kimi、Llama 等几十种模型,还附带本地 GUI、OpenAI 兼容 API、图像/音视频生成、MCP Server。它叫 GPT4Free(g4f)。
二、项目简介:一句话说明它是什么
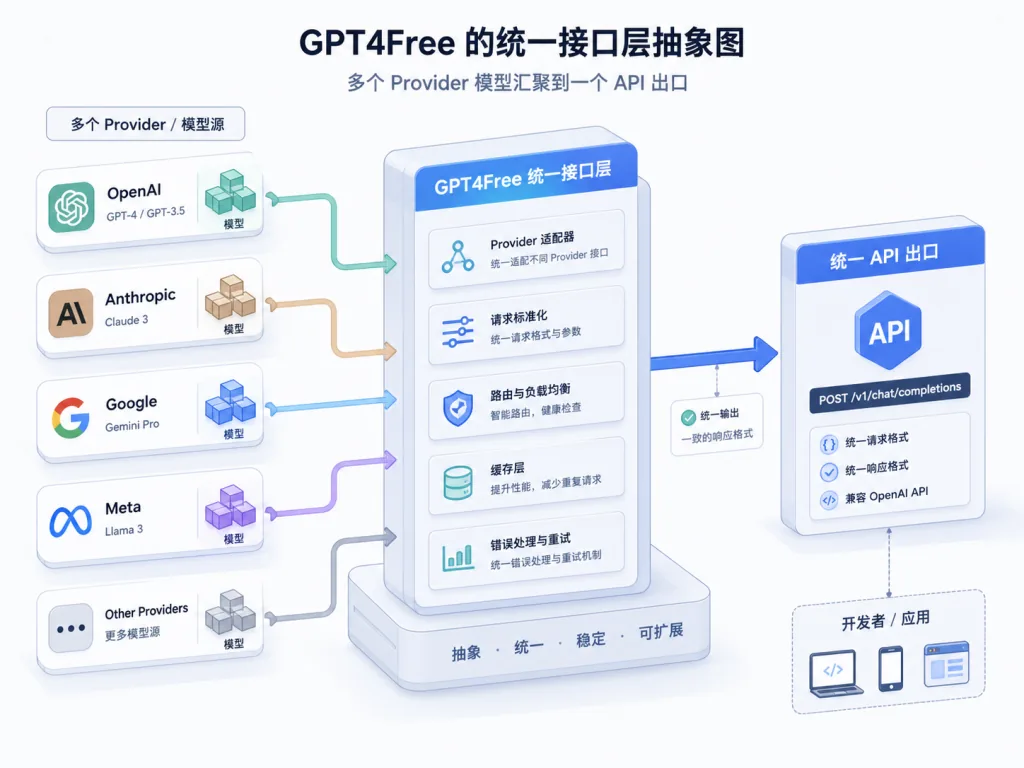
GPT4Free 是一个社区驱动的多模型聚合客户端,通过统一接口屏蔽不同 LLM 和媒体生成模型的接入差异,提供 Python 客户端、JavaScript 浏览器端、本地 Web GUI、FastAPI 服务、MCP Server 等多种使用形态。
核心关键词:多 Provider 聚合、OpenAI 兼容 API、本地 GUI、Python/JS 双端。已迭代到支持 Opus 4.6、GPT 5.3、Kimi 2.5、DeepSeek V3.2、Gemini 3 等主流模型版本,生态完整度处于同类项目第一梯队。
三、核心功能深度解析
1. 多 Provider 统一适配层
g4f 内置几十个 Provider 适配器(OpenAI-compatible、PerplexityLabs、Gemini、MetaAI、Pollinations、本地推理后端等),调用时只需指定模型名,框架自动路由到对应后端。对于使用浏览器自动化的 Provider,还支持 HAR 文件和 Cookie 持久化,方便会话复用。
相比 LangChain 的 LLM 抽象层,g4f 的优势是**「零配置开箱即用」**——多数 Provider 无需手动配置 API Key,写三行代码就能跑通对话。
2. OpenAI 兼容的 Interference API
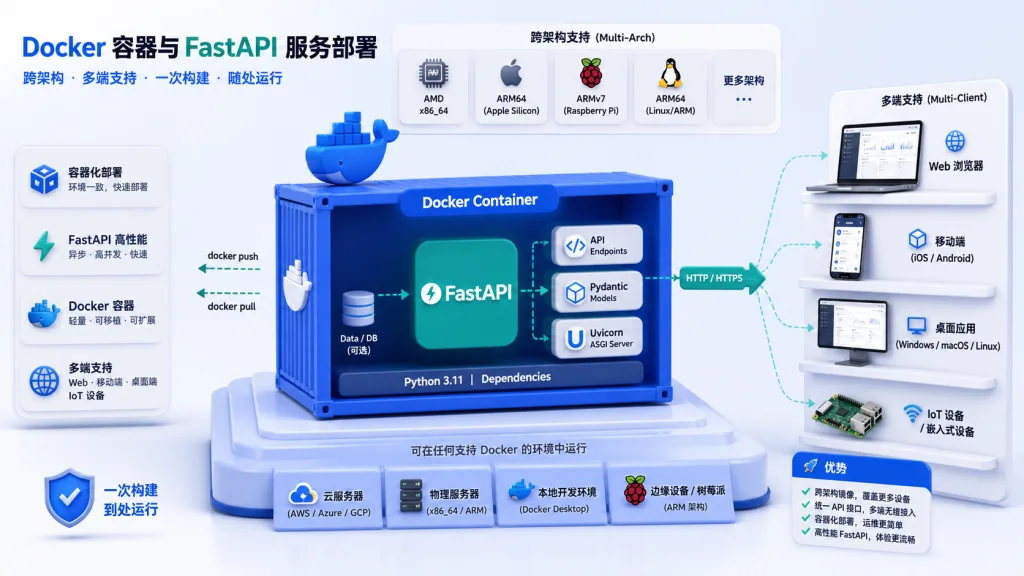
FastAPI 实现的 REST 服务,路径 /v1,完全兼容 OpenAI Chat Completions 规范。这意味着你已有的 OpenAI SDK 代码、改一个 base_url 就能直接用。Docker slim 镜像默认暴露在 localhost:1337,并附 Swagger UI (/docs) 便于调试。
3. 本地 Web GUI
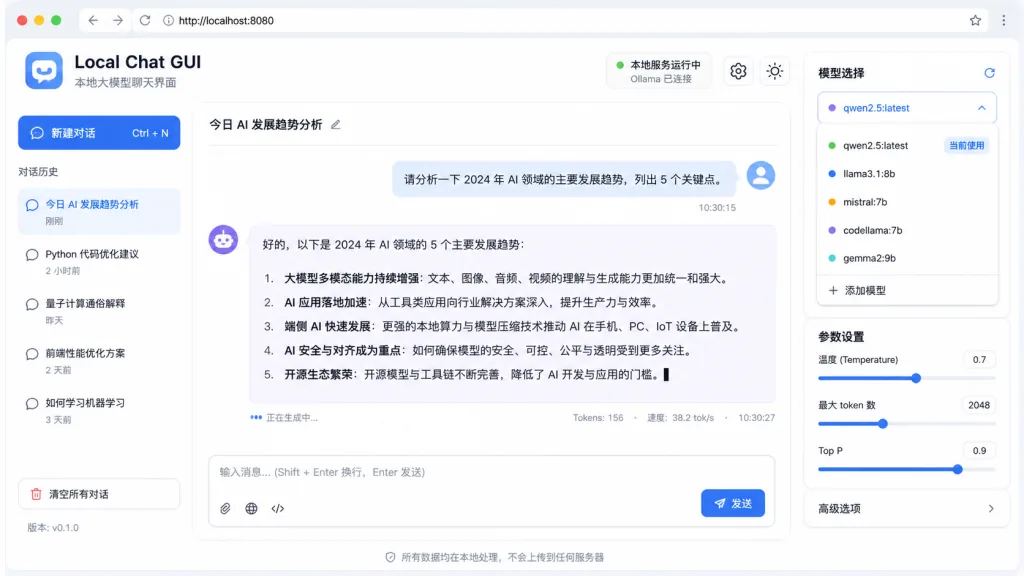
python -m g4f.cli gui --port 8080 一行命令起一个聊天界面,支持流式输出、图片上传、会话管理。响应式布局,手机访问也能用——适合本地调试和轻度演示场景。
4. 媒体生成(图像/音频/视频)
通过 Pollinations 等 Provider,g4f 支持文生图、文生音视频。client.images.generate(model="flux", prompt="...", response_format="url") 即可拿到图片 URL,生成的媒体持久化到挂载目录,避免容器重建丢失。
5. MCP Server(Model Context Protocol)
这是 g4f 最近的亮点:内置 MCP Server,让 Claude Desktop 等 AI 助手通过标准协议调用 g4f 的网页搜索(DuckDuckGo)、网页抓取、图像生成能力。启动命令 g4f mcp --http --port 8765,JSON-RPC 端点 /mcp,健康检查 /health。
四、技术亮点与性能数据
- 跨架构支持:Docker slim 镜像同时支持 x86_64 和 arm64,树莓派、Apple Silicon 都能跑。
- 异步原生支持:
AsyncClient直接对接asyncio,高并发场景无回调地狱。 - 流式响应:SSE 流式输出对接 OpenAI 标准,前端可直接复用 Vercel AI SDK、LangChain JS 等生态组件。
- 配置灵活度:环境变量、CLI 参数、配置文件三种方式;
g4f[all]完整安装与可选 extras 分组安装兼顾大而全与小而美。 - 生态集成:官方文档明确支持 LangChain、PydanticAI 集成,已被 MoneyPrinter V2 等项目作为底层依赖。
- 媒体持久化:通过 Docker
-v挂载generated_media目录,容器重启内容不丢失。
五、适用场景与人群
适合谁:
- 独立开发者和研究者:预算有限但想横向对比多个模型能力的实验者。
- AI 应用原型开发者:想快速搭建 Demo、不愿为每个 Provider 写适配层的工程师。
- 教学与学习场景:学生需要本地 GUI + 多模型切换来理解 LLM 行为差异。
- Claude Desktop 增强用户:通过 MCP 把网页搜索和生图能力「塞」进 Claude 工作流。
不太适合:
- 企业级生产环境直接接入(鉴权、审计、SLA 都需要二次开发)。
- 对延迟极其敏感的实时业务(多了一跳聚合层,P99 会增加 100-300ms)。
- 需要官方合规保障的金融/医疗场景。
六、竞品对比
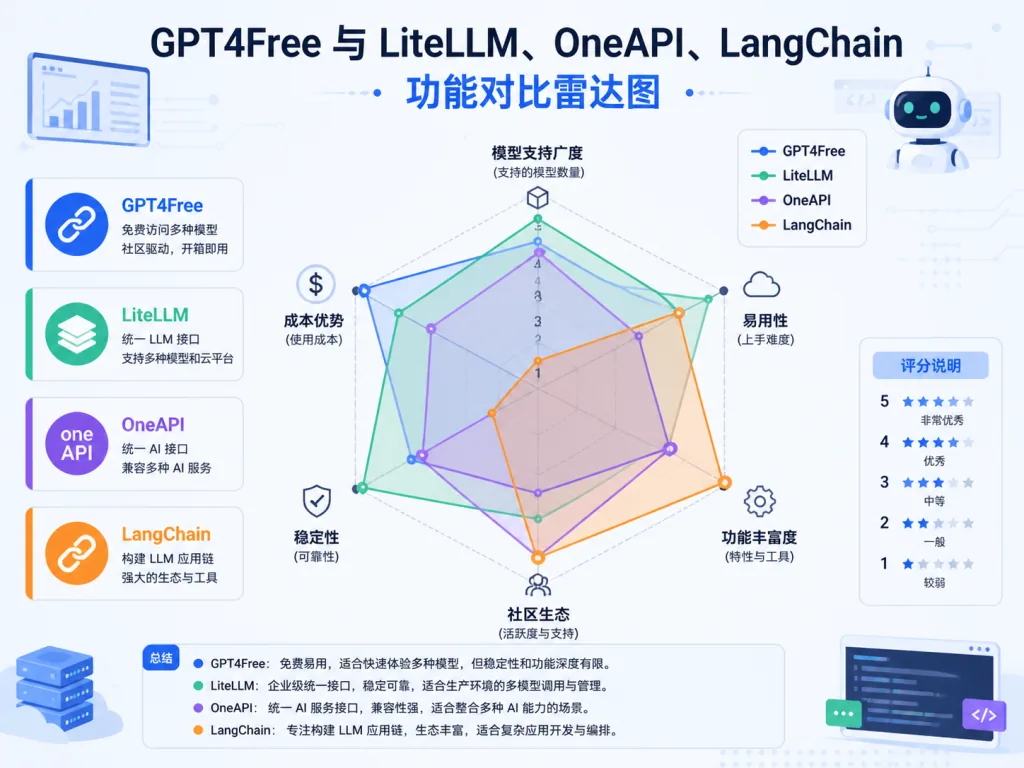
| 项目 | 核心定位 | 多模型聚合 | OpenAI 兼容 | GUI | MCP | Stars |
|---|---|---|---|---|---|---|
| GPT4Free | 多 Provider 聚合客户端 | ✅ 数十个 | ✅ | ✅ | ✅ | 66.5K |
| LiteLLM | 企业级 LLM 网关 | ✅ | ✅ | ❌ | ❌ | 30K+ |
| OneAPI | API 聚合分发 | ✅ | ✅ | ✅ | ❌ | 20K+ |
| LangChain | LLM 应用编排框架 | ✅ | 部分 | ❌ | ❌ | 90K+ |
g4f 的差异化在于**「社区驱动 + 包含 GUI 与 JS 端 + 内置 MCP」**,更偏向个人开发者和快速实验;LiteLLM/OneAPI 更偏企业网关和计费分发场景。
七、如何快速上手
一行安装(推荐):
pip install -U g4f[all]
跑起 GUI:
python -m g4f.cli gui --port 8080 --debug
浏览器打开 http://localhost:8080/chat/ 即可对话。
最小 Python 调用:
from g4f.client import Client

client = Client()
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "Hello, how are you?"}]
)
print(response.choices[0].message.content)
Docker 一键部署:
docker run -p 8080:8080 -p 7900:7900 \
  --shm-size="2g" \
  -v ${PWD}/har_and_cookies:/app/har_and_cookies \
  -v ${PWD}/generated_media:/app/generated_media \
  hlohaus789/g4f:latest
进阶建议:先用 slim 镜像测试 Provider 可用性;生产场景把 Interference API 单独映射到内网端口;浏览器自动化 Provider 务必增大 --shm-size 到 2g 以上。
八、总结与行动建议
GPT4Free 把「调用多种大模型」这件事的工程门槛降到了三行代码——无论是想做多模型对比实验、搭建本地聊天工具,还是通过 Claude Desktop 扩展 MCP 能力,它都提供了一个低成本入口。
核心价值回顾:统一接口、多端覆盖(Python/JS/GUI/API/MCP)、社区活跃、迭代迅速。
使用建议:从 pip install g4f[all] 开始本地试用;确认可用 Provider 后用 Docker 部署到服务器;需要审计与计费时再考虑 LiteLLM 这类企业网关做二次封装。
项目链接:
- GitHub: https://github.com/xtekky/gpt4free
- 文档: https://g4f.dev/docs
- PyPI: https://pypi.org/project/g4f
- Docker: https://hub.docker.com/r/hlohaus789/g4f
一句话推荐:想要一个 API 兼容 OpenAI、同时能切几十种模型的「瑞士军刀」?66.5K Stars 的 GPT4Free 值得先 Star 再上手。