选择标题(3 选 1)
私藏 7 个 AI 工程师必备的开源神器,效率直接起飞
从装环境到跑模型:我每天在用的 7 个开源项目
大模型再火,没有这 7 个开源工具你也白搭
一、开篇:从踩坑到真香,只差这一个项目
最近一次需求里,我要在一台 4GB 显存的小机器上跑 70B 的开源大模型,同时还得写个 Python 服务把模型请求接出去。光是为「先装 Python 依赖、再装模型服务、最后再搞个 Web 界面调参」这三步搭建环境,就折腾了一整天。这种场景下,单一工具解决不了,得有把几件趁手的家伙拼起来用。下面这份清单就是我从反复踩坑里筛出来的 7 个开源项目,按需取用。
二、项目速览
| 仓库 | Stars | 主要语言 | 一句话定位 |
|---|---|---|---|
bentoml/OpenLLM | 12.5k | Python | 一行命令跑 OpenAI 兼容的开源大模型 |
open-webui/open-webui | 152.6k | Python | 自托管的 LLM 聊天 / Agent 前端 |
lyogavin/airllm | 34.6k | Jupyter | 单张 4GB 显卡跑 70B 大模型 |
cactus-compute/needle | 11.9k | Python | 8MB 级端侧模型,工具调用 / 抽取 |
astral-sh/uv | 90.0k | Rust | 10-100 倍速 Python 包管理 |
fastapi/sqlmodel | 18.3k | Python | SQLAlchemy + Pydantic 双修的 ORM |
denoland/deno | 108.5k | Rust | 内置 TS / 安全的 JS 运行时 |
三、项目解析
bentoml/OpenLLM — 一行命令把开源 LLM 变成 OpenAI 兼容 API
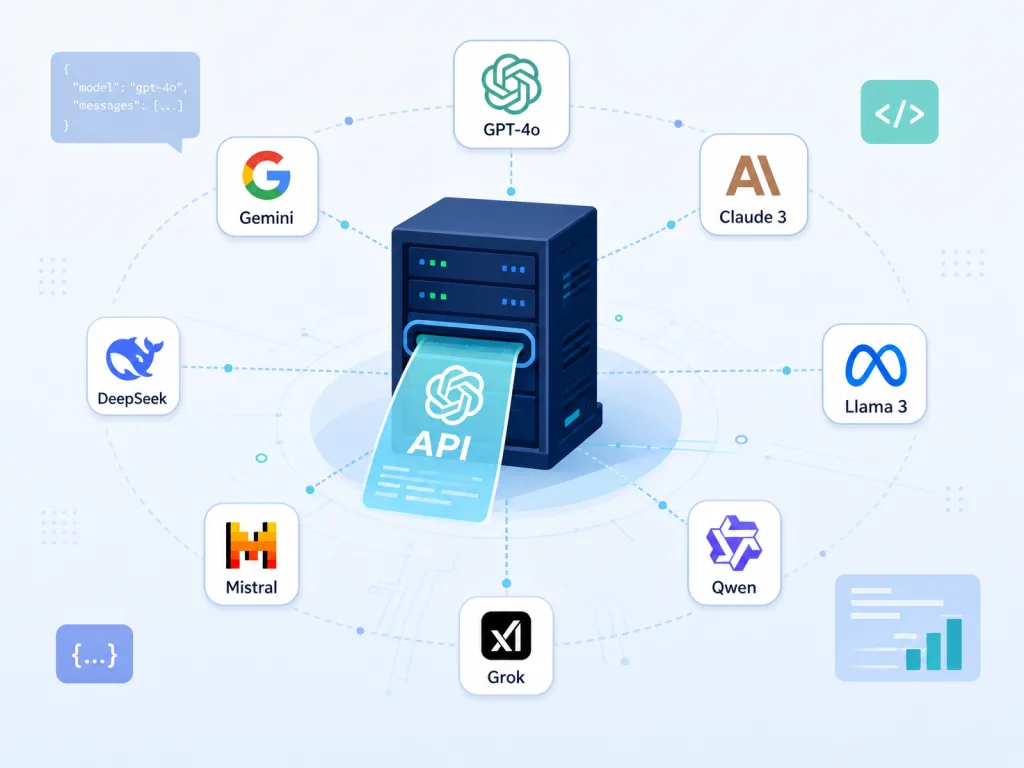
核心能力:把任何开源大模型 1 命令变成 OpenAI 兼容 API。内置 Llama、Qwen、Mistral、DeepSeek 等 10+ 主流模型,支持量化、推理后端切换,再带一个聊 UI 让本地调试直接打开浏览器。
==注意:部分模型如 Llama 需要先在 Hugging Face 申请权限,再设 HF_TOKEN 环境变量==。它的 Docker / Kubernetes / BentoCloud 一条龙部署也省了大量云上线工作。
- 适合谁: 想快速替换 OpenAI、做私有化部署的工程师
- 不适合谁: 只跑单一巨型闭源模型的用户
最小上手
一行起服务:
openllm serve llama3.2:1b
服务起来后访问 http://localhost:3000 就能开聊,已有 OpenAI SDK 的代码只需把 base_url 指向这里。
开源地址: https://github.com/bentoml/OpenLLM
open-webui/open-webui — 自托管的 LLM / Agent 平台前端
核心能力:一个浏览器界面统管本地和云端所有大模型。同时挂 Ollama、OpenAI、LMStudio、GroqCloud、vLLM 等多家 provider,模型间来回切不需要换客户端。它还能装插件(Filters、Actions、Pipes、Tools)、跑 RAG、做长期记忆,团队协作也有 Channels、RBAC、共享日历。
==注意:Mac 上用 Docker 跑需要分配足够内存,否则大模型会卡顿==。
- 适合谁: 团队想统一本地 / 远端模型入口
- 不适合谁: 只需要一次「问一句答一句」的场景
最小上手
Docker 启动:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main
浏览器开 http://localhost:3000 注册账号即可。
开源地址: https://github.com/open-webui/open-webui
lyogavin/airllm — 单 4GB 显卡跑 70B 模型
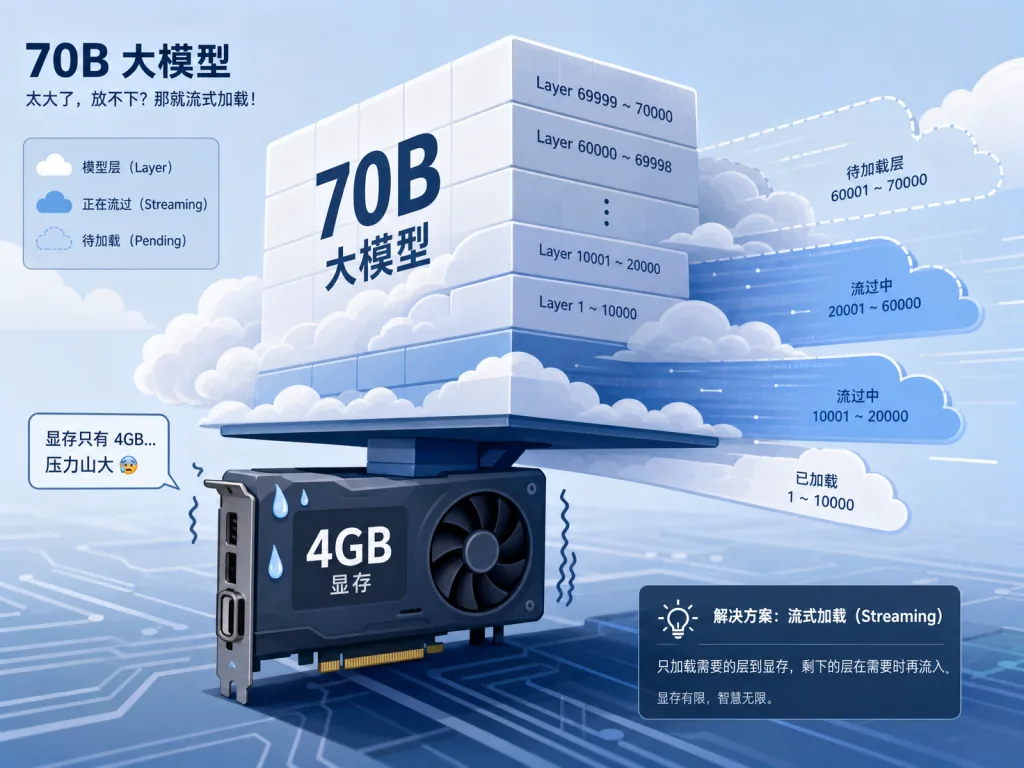
核心能力:通过分层流式加载把显存占用压到极致。它不需要量化、剪枝或蒸馏,70B 模型 4GB 显卡就能跑,Qwen3-235B 在 ~3GB、DeepSeek-V3 671B 在 ~12GB。原理是把模型按层流到显存推理。
对只有游戏本 / 入门卡的人来说,这是把大模型拉到本地的最低门槛。
- 适合谁: 显存紧张、想在本机体验大模型的开发者
- 不适合谁: 追求实时并发、低延迟的服务端
最小上手
装包:
pip install airllm
推理 70B:
from airllm import AutoModel
model = AutoModel.from_pretrained("llama3_70b")
print(model.generate("你好", max_tokens=20))
开源地址: https://github.com/lyogavin/airllm
cactus-compute/needle — 手机 / IoT 上的 8MB 模型
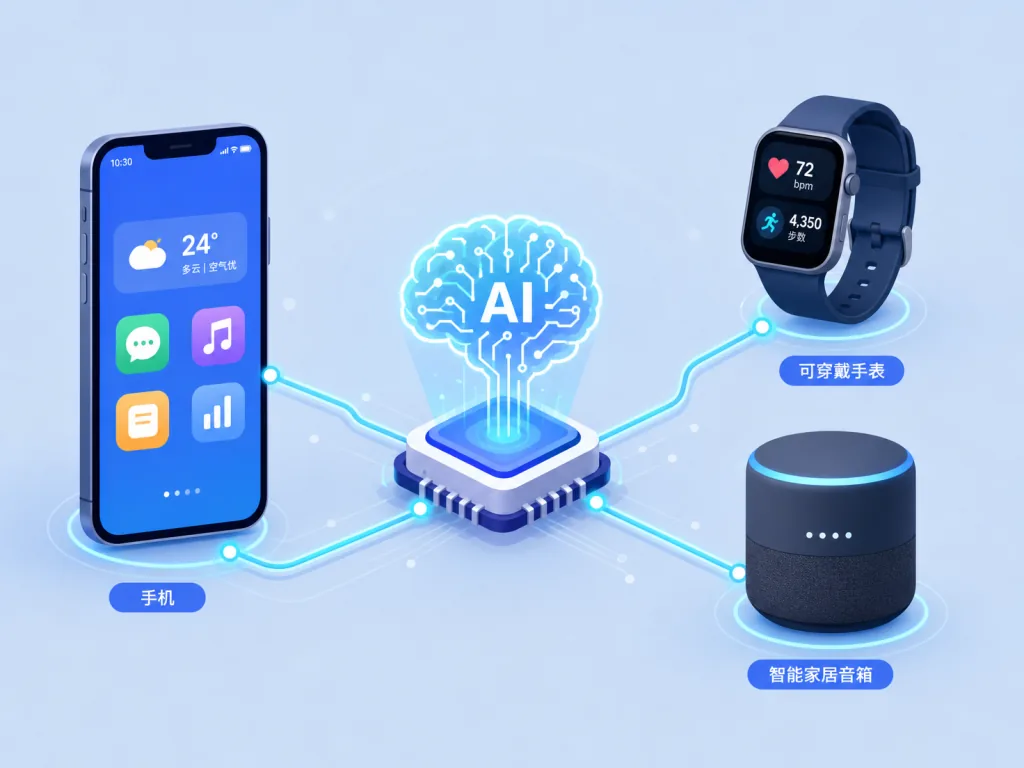
核心能力:在 2-bit 量化、8-29MB 体积下做工具调用和结构化抽取。专为手机、可穿戴、智能家居、车机和单片机设计,常被云端方案忽略的离线场景都能用。
它基于自研的 Simple Attention Network,工具调用精度比同尺寸传统模型高约 10 倍。同时支持结构化抽取(按 schema 填字段)和句子 embedding,一个模型三个用途。
- 适合谁: 做端侧 AI Agent、本地 RAG 的工程师
- 不适合谁: 需要长文本对话 / 复杂推理的场景
最小上手
装包:
pip install cactus-needle
工具调用示例:
import needle

@needle.tool
def get_weather(city: str):
    "Get the current weather for a city."
    return {"city": city, "temp_c": 27}

agent = needle.Needle(tools=[get_weather])
print(agent.run("Lagos 现在怎么样?")["results"])
开源地址: https://github.com/cactus-compute/needle
astral-sh/uv — 10-100 倍速的 Python 工具链
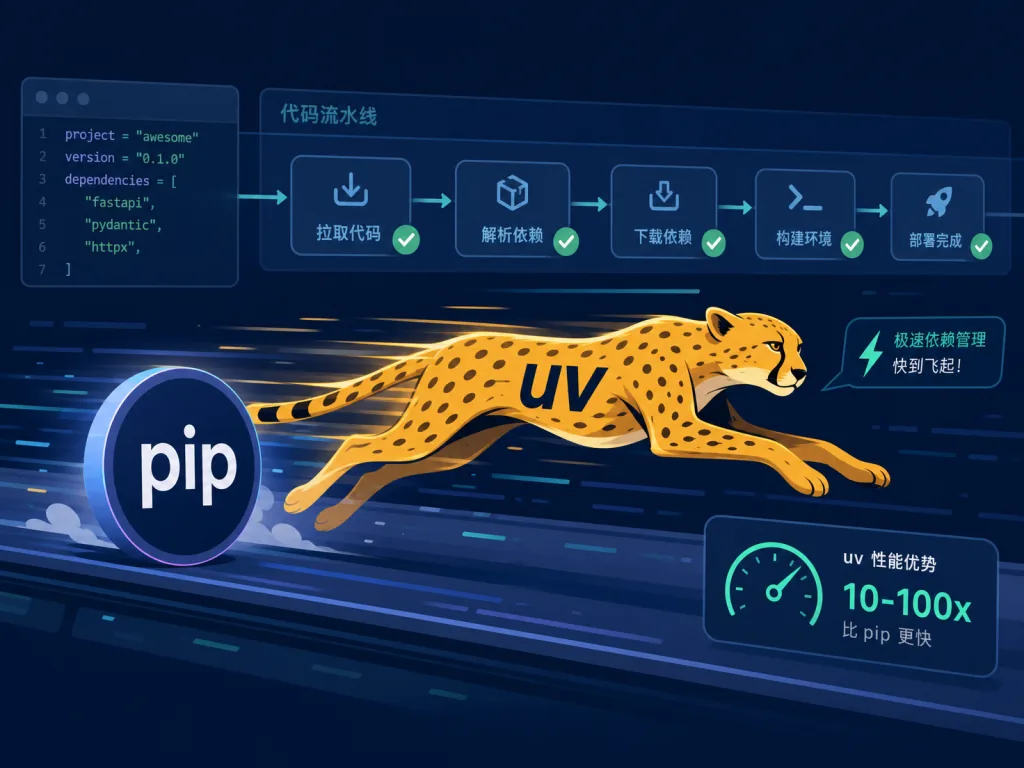
核心能力:用 Rust 重写的 Python 包 / 项目管理器。一个 uv 替代 pip、pip-tools、pipx、poetry、pyenv、virtualenv 等一票工具,速度比 pip 快 10-100 倍。它也支持 lockfile、workspaces、inline-script 依赖,跑单文件脚本自动建环境。
==注意:uv 自带 Python 版本管理能力,建议全新环境用 uv python install 直接装==。Astral 团队还做了 Ruff 和 ty,生态联动很顺畅。
- 适合谁: 任何还在用
pip install的 Python 开发者 - 不适合谁: 被旧工具链强约束的闭源公司项目
最小上手
一键装:
curl -LsSf https://astral.sh/uv/install.sh | sh
新建项目:
uv init example && cd example
uv add ruff
uv run ruff check
开源地址: https://github.com/astral-sh/uv
fastapi/sqlmodel — SQLAlchemy + Pydantic 合体的 ORM
核心能力:把 SQLAlchemy 和 Pydantic 的工作合并到一个类里。一个类同时是数据库表、API 请求模型、API 响应模型,省掉一层重复定义。它由 FastAPI 作者打造,跟 FastAPI 项目天然贴合。
需要复杂查询或迁移时仍可下沉到 SQLAlchemy / Alembic,扩展性不受限。
- 适合谁: 用 FastAPI 写后端、又不想维护两套模型的工程师
- 不适合谁: 不需要 Pydantic 的纯命令行项目
最小上手
加依赖:
uv add sqlmodel
定义模型 + 查数据:
from sqlmodel import Field, SQLModel, select

class Hero(SQLModel, table=True):
    id: int | None = Field(default=None, primary_key=True)
    name: str

with SQLModel.metadata.create_all(engine):
    session.add(Hero(name="Spider-Boy"))
    session.commit()
开源地址: https://github.com/fastapi/sqlmodel
denoland/deno — 内置 TS 的现代 JS 运行时
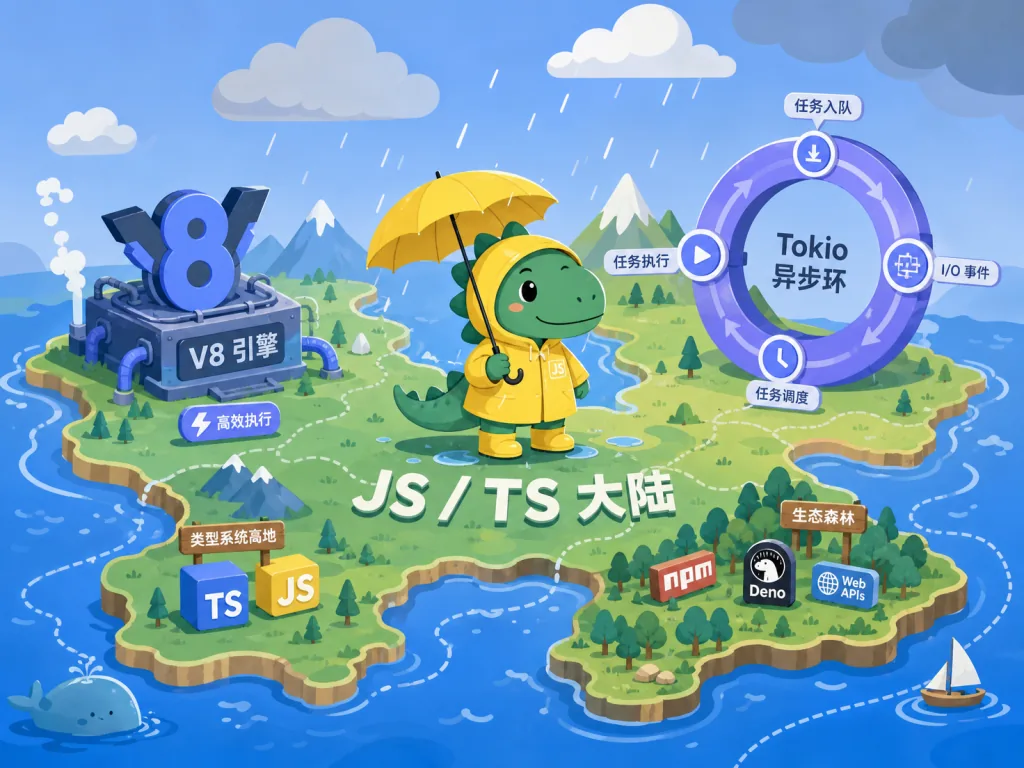
核心能力:原生支持 TypeScript、WebAssembly、安全默认。基于 V8 + Rust + Tokio,加 --allow-net / --allow-read 这类显式权限解决了 Node 的长期痛点。配套还有 Deno.serve 写接口、JSR 注册中心、Deno Deploy 部署平台一套组合拳。
==注意:早期 Deno 项目用的 deno.land/x/ 仍在维护,新项目建议用 jsr.io 上发布==。
- 适合谁: 想从 Node 升级,但不想背 build 工具链的开发者
- 不适合谁: 需要大量吃 Node 历史包袱的项目
最小上手
装:
curl -fsSL https://deno.land/install.sh | sh
写个服务并跑:
// server.ts
Deno.serve((_req: Request) => new Response("Hello, world!"));
deno run --allow-net server.ts
开源地址: https://github.com/denoland/deno
四、总结与行动建议
这 7 个项目分别覆盖了模型服务、前端交互、低显存推理、端侧部署、Python 工程化、ORM、JS 运行时,按需组合就能拼出完整链路。给三条上手路径:
- 先装
uv和Deno:这两个是工程底座,能立刻让日常开发提速。 - 接着搭模型服务层:用
OpenLLM起服务 +Open WebUI做界面,几分钟就能体验私有 ChatGPT。 - 按设备再选边:缺显存加
AirLLM,做端侧 / IoT 选Needle,要写后端补SQLModel。
#AI智能体 #AI工作流 #自动化 #Openllm #OpenWebui #Airllm #Needle #Uv #Sqlmodel #Deno