一、开篇:为什么你需要这个工具?
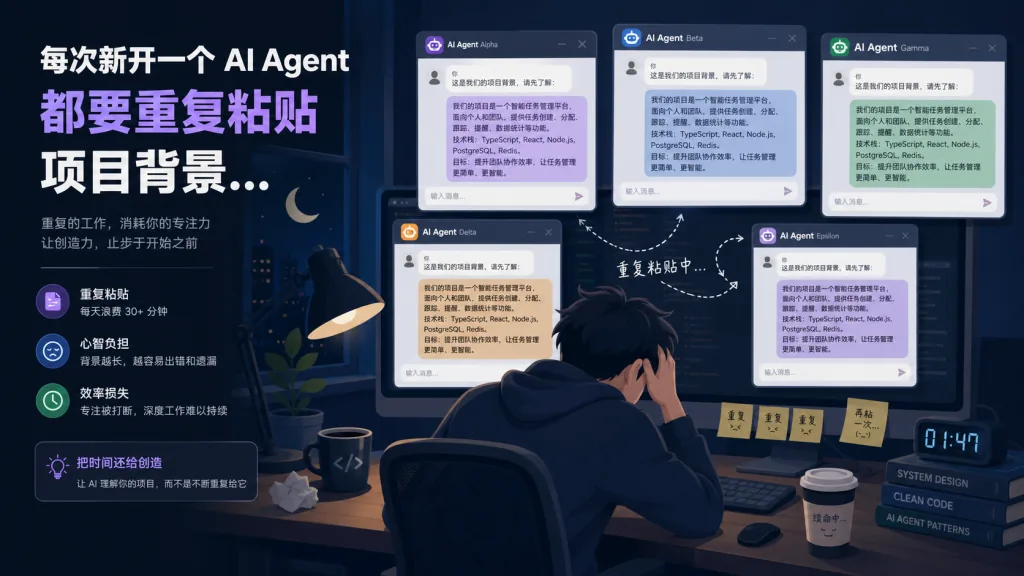
凌晨两点,你第三次把项目背景、架构图和上个月的故障复盘贴给新开的 Agent 会话。Agent 礼貌地回了一句「已了解」,然后在下一步又问出同样的问题——你盯着屏幕,一种熟悉的疲惫感涌上来。
这不是个例。Gartner 2025 年报告显示,企业开发者平均每天与 AI Agent 进行 11 次以上会话,42% 的回合用于重复传递上下文;单个项目中,知识重建成本往往占总耗时的 30%-50%。更让人难受的是:今天这位同事离职,明天那位 Agent 重启,整个团队的「肌肉记忆」瞬间归零。
如果你也受够了这种「原地踏步式 AI 协作」,腾讯云刚开源的 TencentDB Agent Memory(GitHub Star 17,042),可能是 2026 年最值得装上的「Agent 团队大脑」。
二、项目简介:一句话说明它是什么
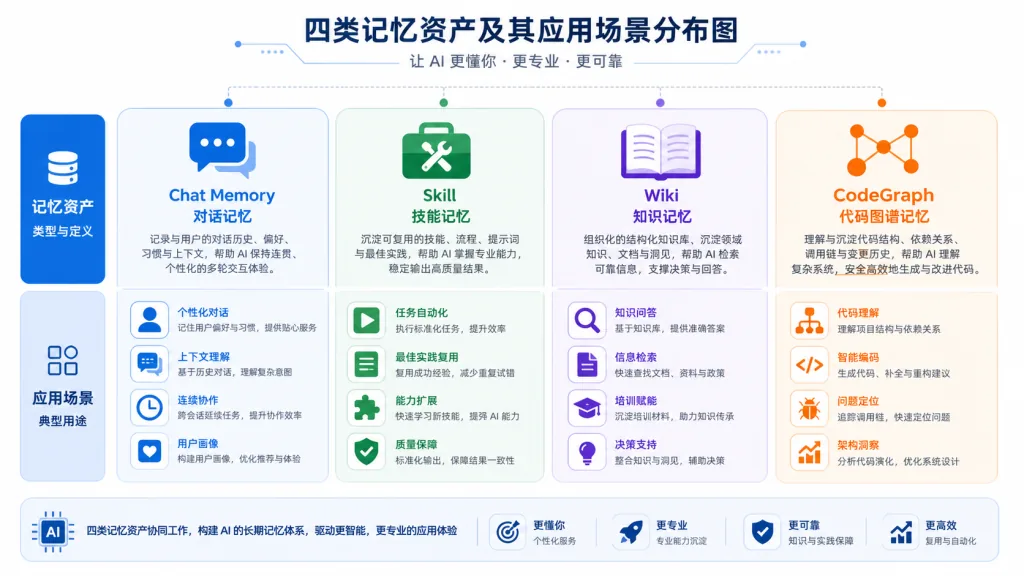
TencentDB Agent Memory 是一个面向 Agent 团队的「记忆中枢」——把对话、文档、代码自动沉淀为四类可复用、可治理、可共享、可装载的记忆资产(Chat Memory / Skill / Wiki / CodeGraph),跨 Agent、跨框架流转。
- 核心特性:四类资产 · 团队治理 · 多框架兼容 · 分层记忆
- 里程碑:GitHub 17,042 Stars,MIT 协议,TypeScript 编写,支持 OpenClaw、Claude Code、CodeBuddy、Hermes 等主流框架
- 定位:不止是 RAG,而是「团队级」记忆资产的控制面板
三、核心功能深度解析
1. Chat Memory:记住「人」的偏好与上下文
Chat Memory 负责长期保存用户偏好、关键决策与交互历史。每个 Agent 创建时自动获得独立记忆空间,下次无需重新自我介绍。
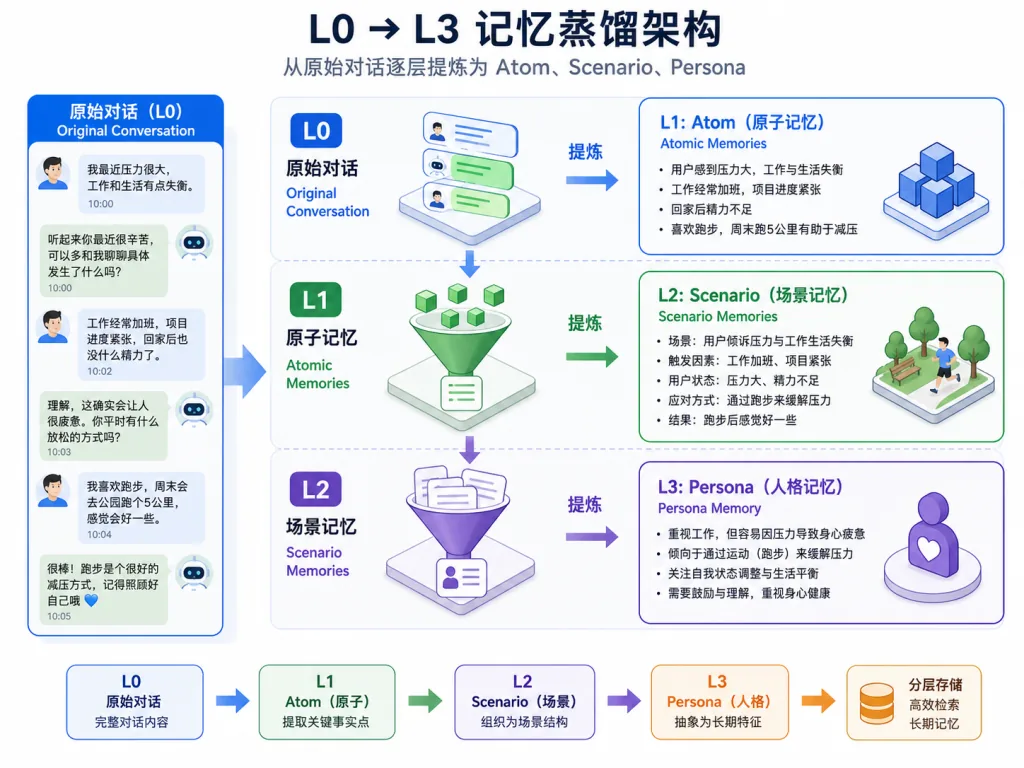
它采用 L0 → L1 → L2 → L3 四层蒸馏架构:原始对话作为 L0 全量存档,异步管道抽取事实、偏好、约束为 L1 Atom,按项目/场景聚合为 L2 Scenario,最终提炼为长期人格画像 L3 Persona。
日常检索优先走 L2/L3 快速 bootstrap;需要精确事实时,自动回退到 BM25 + 向量检索 + RRF,在 L1/L0 中拉取原始证据,并通过条数、字符预算、超时三重闸门防止上下文溢出。
效果上,PersonaMem 基准测试准确率从 48% 提升到 76%,相对提升 +59%——这意味着 Agent 对用户上下文的理解能力近乎翻倍。
2. Skill:可执行的「经验包」
Skill 不是普通的 Prompt 片段,而是带有版本、资源文件、触发边界、执行步骤、验证规则的完整工作流资产。Agent 完成复杂任务后,可自动从对话和工具调用中抽取 Skill,经过审核后分享给团队其他成员。
个人 Skill 默认私有,经过 Owner 审核后才能升级为团队共享,并精准装载到指定 Agent。「故障排查」「代码评审」「发布清单」——团队里只要有人跑通一次,整个 Agent 团队都能复用。
3. Wiki + CodeGraph:文档与代码的双向知识图谱
Wiki 把产品文档、设计规范、运维手册转化为带链接图的结构化页面(灵感来自 Karpathy 提出的 LLM Wiki 理念);CodeGraph 则把代码符号、文件、调用关系、影响路径索引成图。
Agent 不必再逐行扫文件,只需通过 /v3/tools/list 发现能力,再通过 /v3/tools/call 按需读取页面、源码或影响路径。文档和代码不再「全量灌入」,而是「按需调用」——这彻底改变了 Agent 理解大型仓库的方式。
4. Memory Hub:团队级的「控制面板」
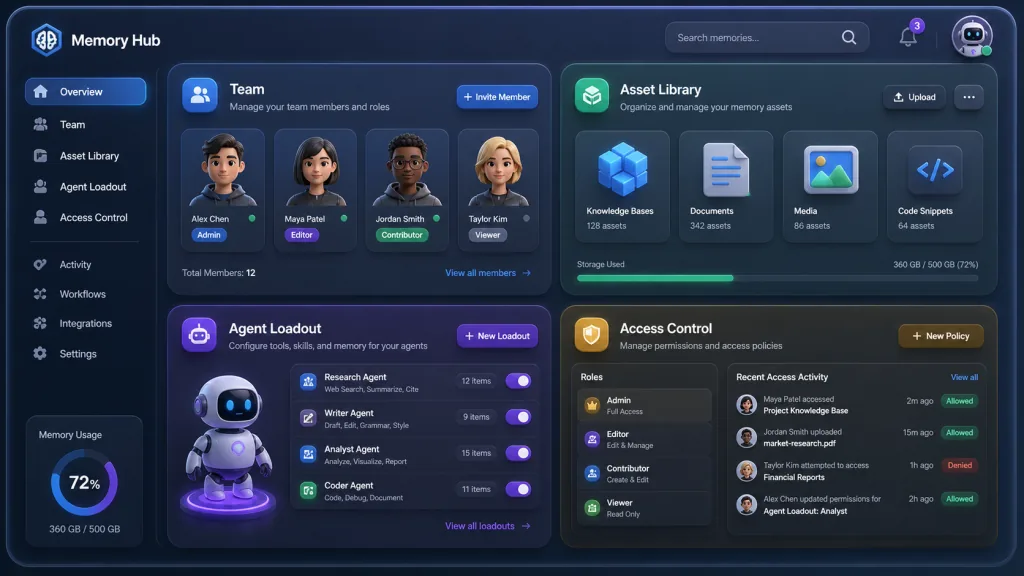
Memory Hub 提供四类核心操作:Team Up(建团队、加成员、划边界)、Asset Library(浏览/搜索/审核资产)、Agent Loadout(给不同 Agent 绑定不同资产并设定优先级)、Access Control(私有/团队/ACL 三级权限)。
资产还附带完整治理字段:Owner、版本、状态、可见性、使用次数、Agent 绑定情况。打开一个资产,你不仅看到「它说了什么」,还能看到「来自哪个版本、被谁用过、最近何时调用」——这是 RAG 给不出来的「运营级可见性」。
四、技术亮点与性能数据
- 分层记忆架构:L0-L3 四级蒸馏,生成与检索均分层处理,平衡「快速 bootstrap」与「精确回溯」。
- 固定绑定 + ACL 检索:先按 Team/User/Agent/可见性收缩权限范围,再按当前 Query 检索,实现「团队共享经验但不泄露隐私」。
- 工具化知识调用:Wiki / CodeGraph 不进 Prompt,而是注册为 Tool,按需
/v3/tools/call调用,避免上下文窗口爆炸。 - 生态兼容:同时支持 OpenClaw、Hermes、Claude Code、CodeBuddy 与 SDK 集成,跨框架迁移只需「重新装载」,无需「重新训练」。
- 基准成绩:PersonaMem 从 48% → 76%,+59% 相对提升。
五、适用场景与人群
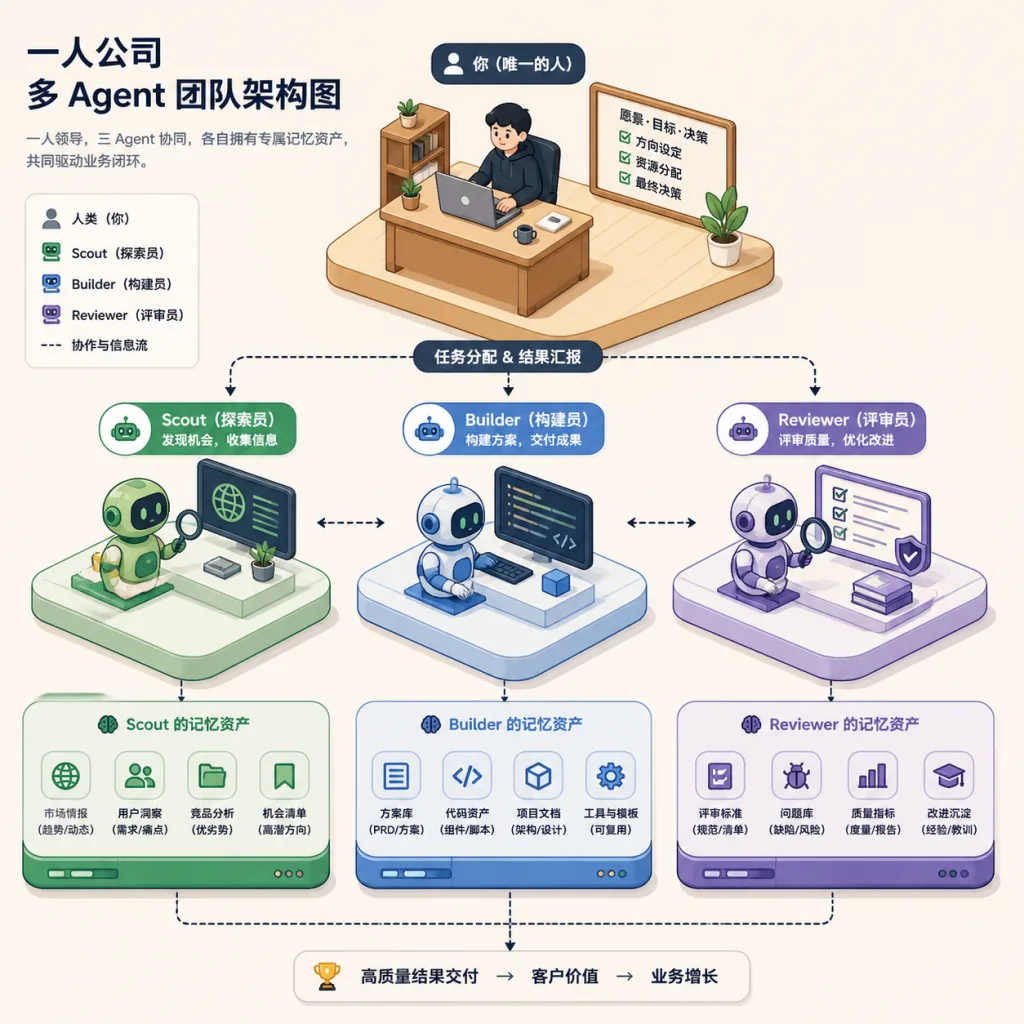
场景 1:一人公司 / 微型团队——组建 Scout、Builder、Reviewer 三人 Agent 团队,各自装载不同记忆资产,让「公司虽小,经验可累加」。
场景 2:大型项目的代码评审与变更影响分析——CodeGraph 直接给出「改这个函数会波及哪些调用方」,把评审从「凭经验」变成「看图说话」。
场景 3:客服/咨询类 Agent 的长期记忆——L3 Persona 让 Agent 第二次服务老客户时,直接接得上话,无需重复确认基本信息。
适合:长期维护中大型项目的研发团队、需要沉淀 SOP 的运营团队、构建多 Agent 协作系统的独立开发者。
不适合:纯一次性脚本场景、对实时性要求极高(<50ms)且无法容忍异步索引延迟的链路。
六、竞品对比
| 维度 | 普通 Chat History | 标准 RAG | TencentDB Agent Memory |
|---|---|---|---|
| 跨会话用户理解 | △ | △ | ✅ Chat Memory |
| 可执行经验蒸馏 | — | — | ✅ Skill |
| 文档结构与关系 | — | △ Chunk 检索 | ✅ Wiki + 链接图 |
| 代码调用图与影响范围 | — | △ 文本匹配 | ✅ CodeGraph |
| Owner/版本/状态 | — | — | ✅ |
| 团队共享与 Agent 装载 | — | — | ✅ |
| 私有/团队/ACL | — | △ | ✅ |
简单说:RAG 告诉你「文档里有什么」,Agent Memory 还告诉你「谁能用、哪个版本有效、该装给哪个 Agent」。
七、如何快速上手
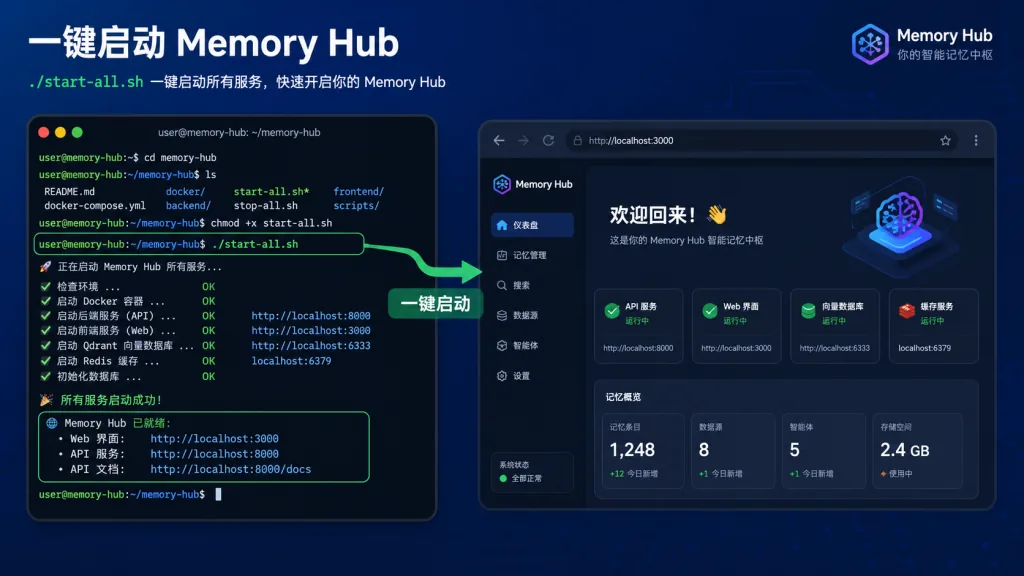
一行命令启动 memory-core + memory-hub + proxy 三大服务:
git clone https://github.com/Tencent/TencentDB-Agent-Memory.git
cd TencentDB-Agent-Memory/deploy/global-images
cp .env.example .env
$EDITOR .env
./start-all.sh
启动完成后,终端会打印一条可直接粘贴到 Claude 的一行配置。打开控制台 http://localhost:8125 即可看到 Memory Hub 面板。
最小可用示例:在面板里创建一个 Team → 添加 Builder Agent → 导入你的代码仓库(自动生成 CodeGraph)→ 导入历史对话会话(自动抽取 Skill 与 Chat Memory)→ 给 Builder 装载所需资产。
进阶建议:先在测试项目跑通端到端流程,再用官方提供的 migrate-v2-to-v3 工具把 v1.x/v0.x 数据迁移到 v2.0.0+,生产环境部署务必阅读完整 INSTALL.md(包含独立 Hub 部署、Proxy + Claude Code/CodeBuddy 联用、停止与清理、端口参考等)。
八、总结与行动建议
TencentDB Agent Memory 把「记忆」从单 Agent 的会话历史升级为团队级、可治理、可流转的资产——它解决的不是「怎么存更多」,而是「什么值得存、谁能用、下次怎么少取点」。
- 核心价值:四类资产 × 分层架构 × 团队治理 × 跨框架兼容
- 使用建议:从 CodeGraph + Wiki 开始(收益最直观),再叠加 Chat Memory 与 Skill
- 项目链接:
- GitHub: https://github.com/TencentCloud/TencentDB-Agent-Memory
- 文档:
INSTALL.md·CONTRIBUTING.md· OpenAPI:MemoryKnowledge/openapi.yaml - 社区:Discord · GitHub Discussions
一句话推荐:别再让 Agent 每次从零开始——把团队走过的路,变成下一个 Agent 的起跑线。