选择标题(3 选 1)
Agent 记忆又贵又难 debug?OpenViking 用文件系统把它装进「文件夹」
38K Star 开源项目:把 Agent 记忆准确率从 24% 拉到 82%,token 砍掉 91%
Agent 的记忆为什么总是个黑盒?这个 38K Star 项目想用文件系统掀翻它
38K Star 的 OpenViking:把 Agent 的记忆、知识和技能装进同一个文件系统
一、开篇:Agent 的记忆是个「黑盒」,你敢信?
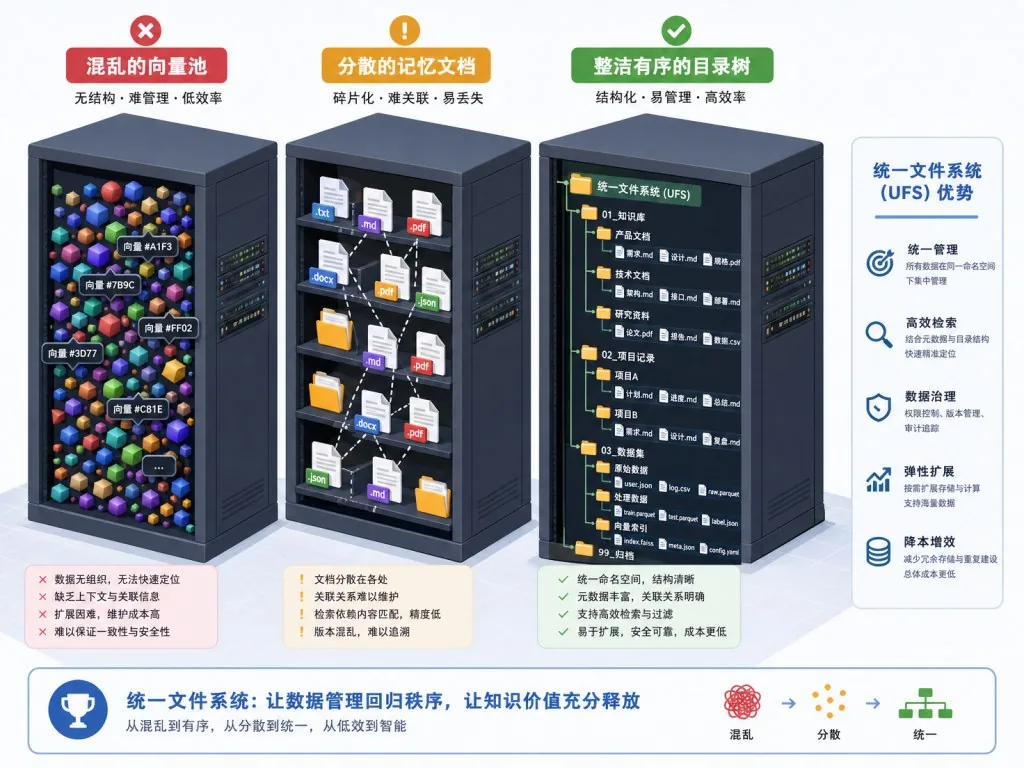
你把一堆文档喂给 AI Agent,它给你吐出一段回答。但你真的知道它「记住」了什么吗?绝大多数 Agent 的记忆机制是这样的:文本进去,向量出来,中间发生了什么,谁也看不见。开发者想 debug 一个错误召回?想删掉一条过时的偏好?想看看 Agent 到底把哪些上下文塞进了 prompt?答案是:拆不开、查不到、改不动。
更要命的是召回质量本身。LoCoMo 长对话记忆基准上,OpenClaw 原生记忆只有 24.20% 的准确率,Hermes 是 33.38%,Claude Code 也不过 57.21%。这意味着你精心配置的 Agent,在跨会话记忆这一项上,有一半概率在「瞎猜」。同时输入 token 居高不下,响应延迟飘忽不定——记忆系统既是质量瓶颈,也是成本黑洞。
二、一句话看懂:这是个什么项目
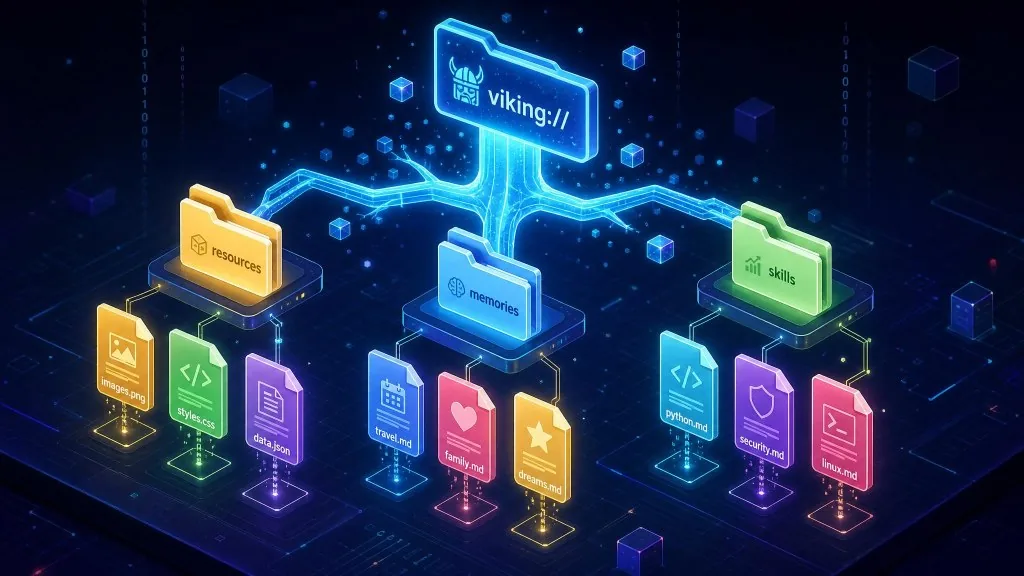
OpenViking 是火山引擎开源的 AI Agent 上下文数据库(GitHub 38.8K Stars),核心定位是「一个文件系统统一管理 Agent 的知识、记忆和技能」。它把 Agent 上下文组织成 viking:// 虚拟文件系统,支持 ls、tree、read、grep 这类熟悉的文件操作;每个目录自带 L0/L1 摘要,Agent 可先扫摘要判断相关性,再按需读取完整内容。当前最新版本 0.3.22,已在 LoCoMo 和 tau2-bench 公开评测中验证效果。
三、核心功能深度解析
1. 一切皆文件:知识、记忆、技能统一 URI
OpenViking 用 viking:// 协议把三类上下文收纳进同一棵树:resources/ 放项目文档与代码、user/{user_id}/memories/ 存用户偏好与经验、user/{user_id}/skills/ 定义任务执行流程。每个资源都分配独立 URI,既能浏览,也能直接检索。对比传统「向量池 + 多套独立存储」的方案,这套设计省去了多系统拼装的复杂度——Agent 用同一套接口访问所有上下文类型。
2. 目录级检索:搜索「一个目录」,而非「整个索引」
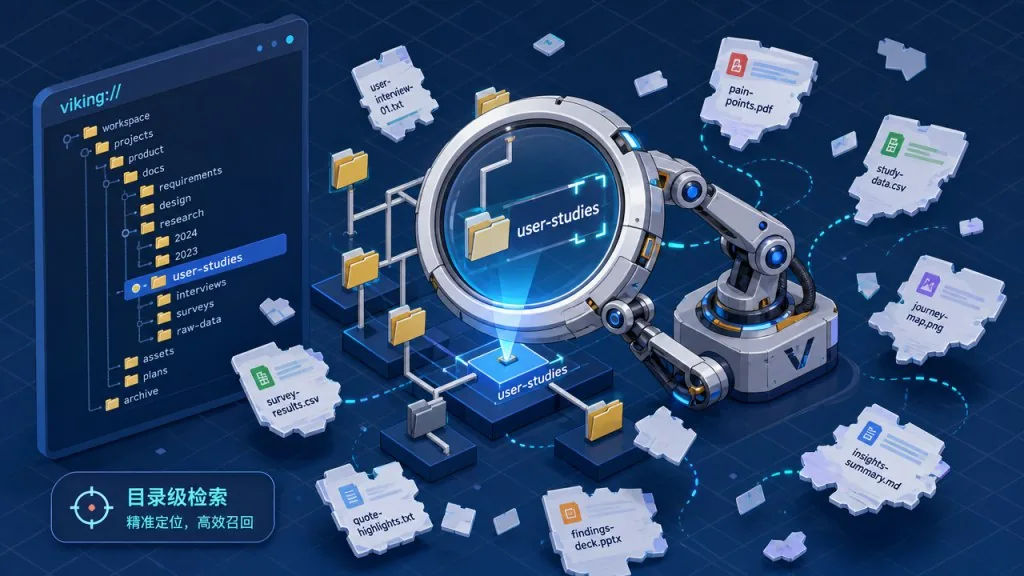
传统 RAG 检索是在扁平向量池里全局搜,召回结果散落各处。OpenViking 支持把检索范围限定到某个项目子目录或记忆子树。ov find "what is openviking" 直接跑语义检索;ov search 会基于会话上下文规划检索路径。配合 TrieHI 索引(已集成),系统会在向量排序之前先解析目录作用域,显著降低无关召回。
3. 三层加载:摘要先行,按需读取
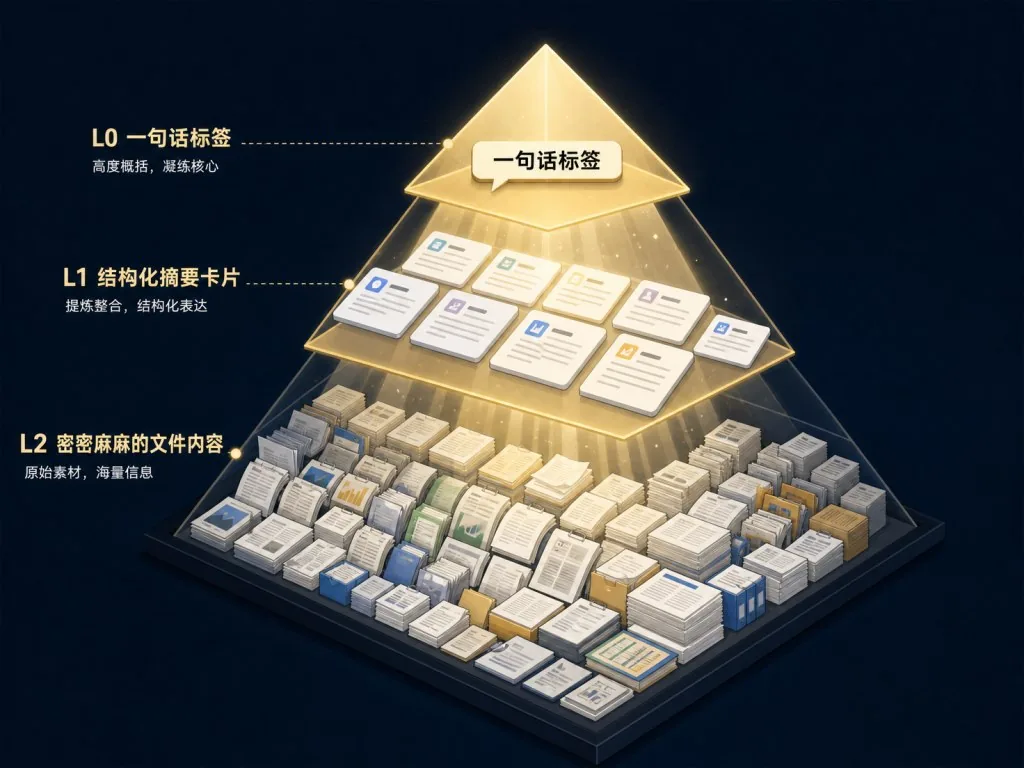
每个语义化处理的目录自带两层摘要:.abstract.md(L0,一句话相关性判断)和 .overview.md(L1,结构与要点)。Agent 先扫摘要决定是否深入,再读完整内容(L2)。这种「按需加载」机制是 token 成本下降的关键——官方数据显示接入 OpenViking 后,输入 token 下降 34.3% 至 91.0%。
4. 会话即文件:可读、可改、可合并
执行 ov compile 会把当前会话归档为可读 Markdown,自动抽取其中的记忆条目。开发者可以直接编辑这些 Markdown,再让 OpenViking 把人工修订合并回记忆库。开启 VikingBot 后,ov compile 还能把素材组织成 Wiki、知识图谱或报告——会话本身变成了可治理的资产,而非用完即弃的日志。
四、技术亮点与性能数据
在 LoCoMo 长对话记忆基准上,三套 Agent 接入 OpenViking 后准确率统一跃升到 80–83% 区间:OpenClaw 从 24.20% 提到 82.08%,Hermes 从 33.38% 提到 82.86%,Claude Code 从 57.21% 提到 80.32%。同时查询延迟下降 58.45% 至 66.10%。在 tau2-bench 多轮任务基准上,体验记忆让零售场景任务成功率 +6.87pp、航司场景 +11.87pp。
架构层面,OpenViking 把 VikingMem 的事件驱动记忆管理、VikingRAG 的结构化检索、TrieHI 的目录感知索引三项研究整合进单一系统。底层支持 Volcengine、OpenAI、Codex OAuth、Kimi、GLM、本地 Ollama 等多种模型提供方;SDK 覆盖 Python、Go、TypeScript,并提供 HTTP API;已为 Claude Code、Codex、Cursor、TRAE、OpenClaw、Hermes、LangChain 等十余款 Agent 框架预置集成。服务端支持多租户账户隔离与可选 ACL,开源协议为 AGPLv3,可自托管无需激活密钥。
五、适用场景与人群
- 场景一:跨会话需要稳定记忆的个人助手。你希望 Agent 记住你的写作风格、编码习惯、项目背景,OpenViking 的
user/memories/树直接对应这种需求。 - 场景二:需要可治理上下文的团队 Agent。RAG 知识库散落在多个向量库、文档库、记忆服务里难以审计,OpenViking 的文件系统范式让治理动作(删除、合并、修订)变成简单的文件操作。
- 场景三:长链路任务的多轮 Agent。零售、客服、航司这类需要多轮调用工具的场景,体验记忆可让任务成功率显著提升。
适合人群:需要为生产级 Agent 搭建记忆/知识基础设施的后端与平台工程师;正在评估 Agent 框架记忆方案的架构师;对 token 成本敏感的 AI 产品负责人。不太适合:仅做一次性问答、不需要持久上下文的轻量 Bot。
六、竞品对比
| 维度 | OpenViking | 传统向量数据库(Milvus/Qdrant) | 通用 Agent 记忆框架(Mem0 等) |
|---|---|---|---|
| 数据模型 | 虚拟文件系统(目录 + 文件 + URI) | 扁平向量集合 | 多为 KV 或文档集合 |
| 上下文类型 | 知识、记忆、技能统一管理 | 通常仅服务 RAG 检索 | 以记忆为主 |
| 可观测性 | 文件浏览直接查看 | 黑盒,需自建审计层 | 黑盒 |
| 检索粒度 | 目录级作用域检索 | 全局检索 | 通常全局 |
| 开源协议 | AGPLv3,可商用自托管 | Apache 2.0 等 | 视项目而定 |
| 主流 Agent 集成 | 十余款预置 | 需自研 | 部分支持 |
选择 OpenViking 的核心理由是:当你需要的不是「又一个向量库」,而是「Agent 上下文的统一治理平面」时,文件系统范式带来的可操作性是其他方案难以替代的。
七、如何快速上手
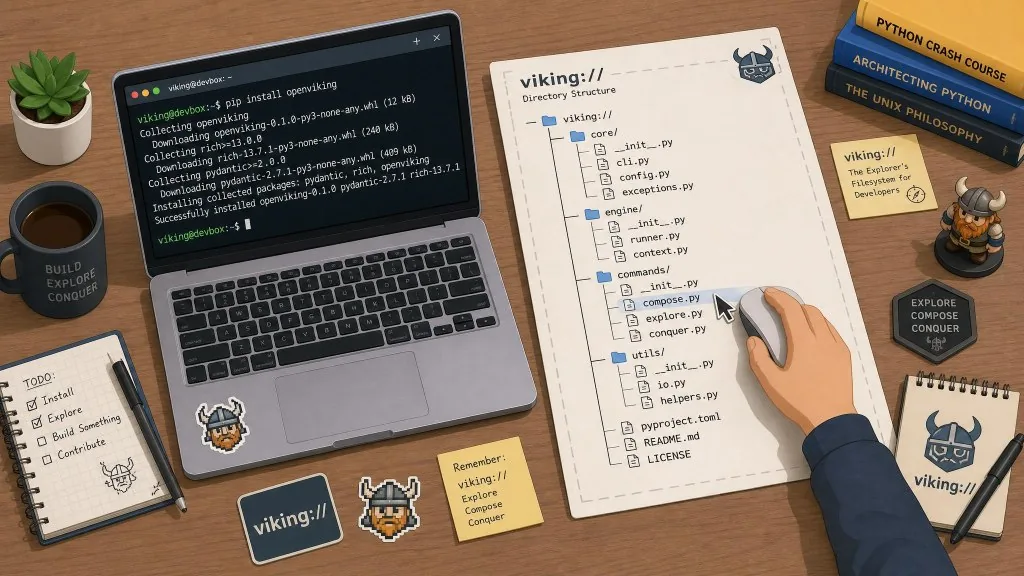
OpenViking 需要 Python 3.10+ 以及可用的 Embedding 模型与 VLM(云端或本地均可)。安装与启动只需四条命令:
pip install openviking --upgrade
openviking-server init      # 配置模型提供方
openviking-server doctor    # 检查连通性
openviking-server           # 启动服务
init 会写入 ~/.openviking/ov.conf,按提示填入 API Key 即可。服务起来后,在另一个终端用 ov CLI 导入资源并检索:
ov add-resource https://github.com/volcengine/OpenViking
ov task status TASK_ID     # 轮询直到状态为 completed
ov tree viking://resources/volcengine -L 2
ov find "what is openviking"
进阶用法包括:用 Python SDK 构建自定义 Agent 集成、部署 Docker 版本(自带 VikingBot 与控制台 UI)、通过 MCP 把任意兼容 Agent 接入。生产部署务必先阅读 认证文档 并启用账户隔离。
八、总结与行动建议
OpenViking 用「虚拟文件系统」这套极简抽象,把 Agent 上下文的三类资产——知识、记忆、技能——收进了同一棵可治理的树。它在公开基准上把长对话记忆准确率从 24–57% 拉到 80%+,同时压下 34–91% 的输入 token 与近六成查询延迟;对于正在为生产 Agent 搭建记忆层、又受困于向量黑盒的团队,这是一套值得放进评估清单的方案。
建议路径:先用 OpenViking Studio 在线体验语义检索与目录浏览;接着本地跑通 openviking-server 与 ov CLI;最后挑选一款你正在用的 Agent(Claude Code / Cursor / Codex 等),按官方集成文档接入并对比接入前后的准确率与 token 消耗。
- GitHub:https://github.com/volcengine/OpenViking
- 官网与文档:https://openviking.ai/ · https://docs.openviking.ai/
- 论文:VikingMem(arXiv:2605.29640)、Directory-Aware Query(arXiv:2606.16903)、VikingRAG(arXiv:2609.11390)
Agent 的记忆不该是黑盒,它应该像你的项目代码一样,可读、可改、可审计。
#openviking #Openviking #volcengine #AI智能体 #AI工作流 #自动化 #开源项目 #GitHub