一、开篇:为什么 AI 代理总在浏览器前栽跟头?
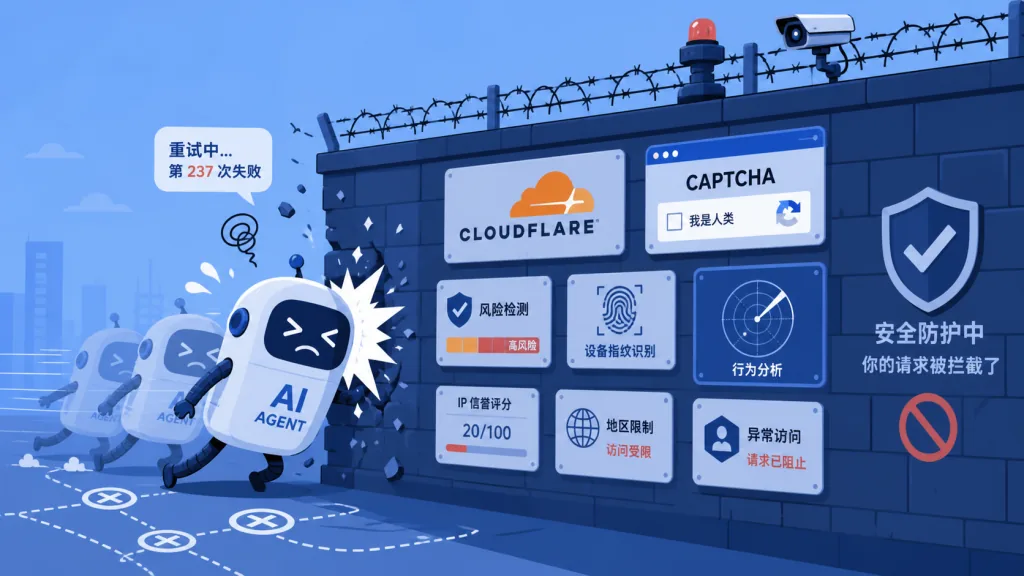
凌晨两点,你让 AI 代理去抓取某电商网站的商品价格。代理顺利打开了页面,却在 Cloudflare 五秒盾前停住,反复触发 CAPTCHA;你手动验证后,代理又因为指纹异常被风控拦截;换一台机器再试,登录态丢失,账号直接被风控冻结。一夜过去,任务列表里 0/200 完成。
这不是个例。当下大量 AI 代理仍依赖 Playwright 或 Puppeteer 跑在裸浏览器上,面对 2025 年普遍升级的 Bot 检测体系,平均任务失败率超过 60%。问题出在哪?脚本是为人类阅读 DOM 而写的,浏览器却是为人类操作而设计的——给 AI 用的浏览器,必须从头重做。BrowserAct Skills(GitHub 5.3k+ Stars)正是为此而来。
二、项目定位:给 AI 代理用的真浏览器
BrowserAct Skills 是一个面向 AI 代理的浏览器自动化 CLI 工具包,核心理念只有一句话:「A browser for agents must get four things right.」——能突破反爬、能跨平台远程接管、并行任务互不串扰、为 LLM 推理而设计。
三个关键标签:真实浏览器内核、隐身指纹 + 住宅代理、Skill 协议层。两周内拿下 5.3k Stars,社区在 Discord 持续活跃,已适配 Claude Code、Cursor、VS Code、OpenCode、OpenClaw、Codex、Gemini CLI 等主流 AI 代理。
三、核心功能深度解析
1. 三层渐进反检测体系
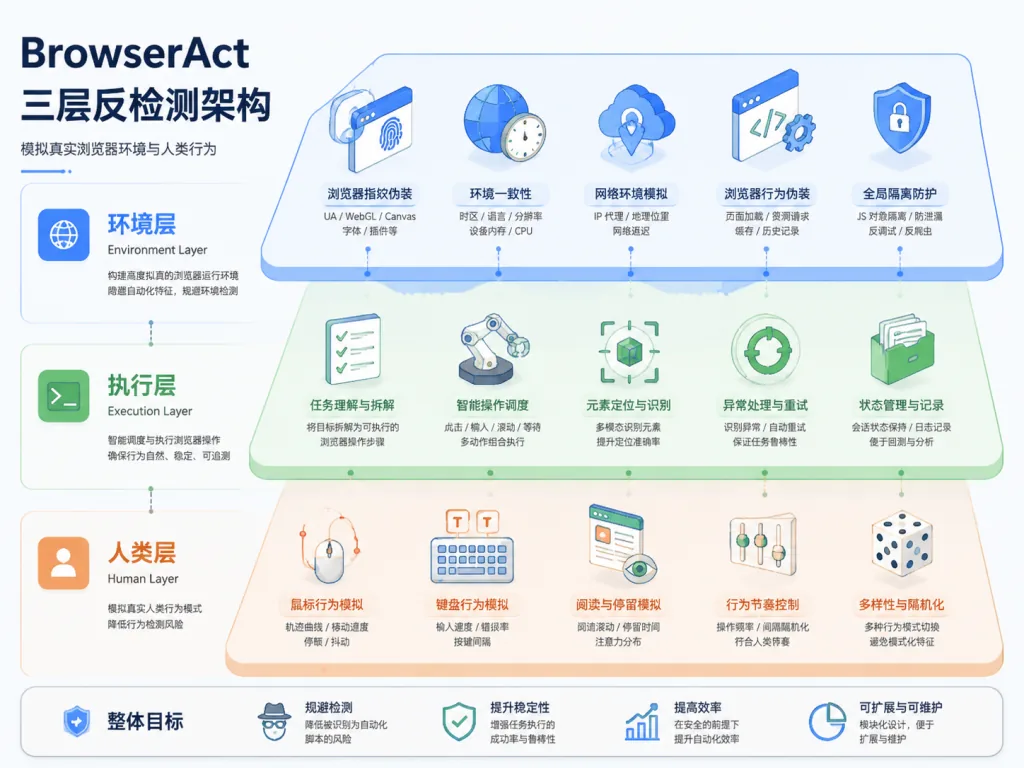
BrowserAct 把反爬拆成三层,逐级升级:第一层环境层跑隐身指纹伪装、TLS 指纹轮换、代理切换,常规风控直接绕过;第二层执行层内置 solve-captcha 自动解验证码,stealth-extract 一行命令拉取受保护页面;第三层人类层使用 remote-assist 生成实时链接,用户在任何设备接管后,代理无缝继续执行。三层互补,绝大多数站点无需人工介入。
2. 三种浏览器模式覆盖真实场景
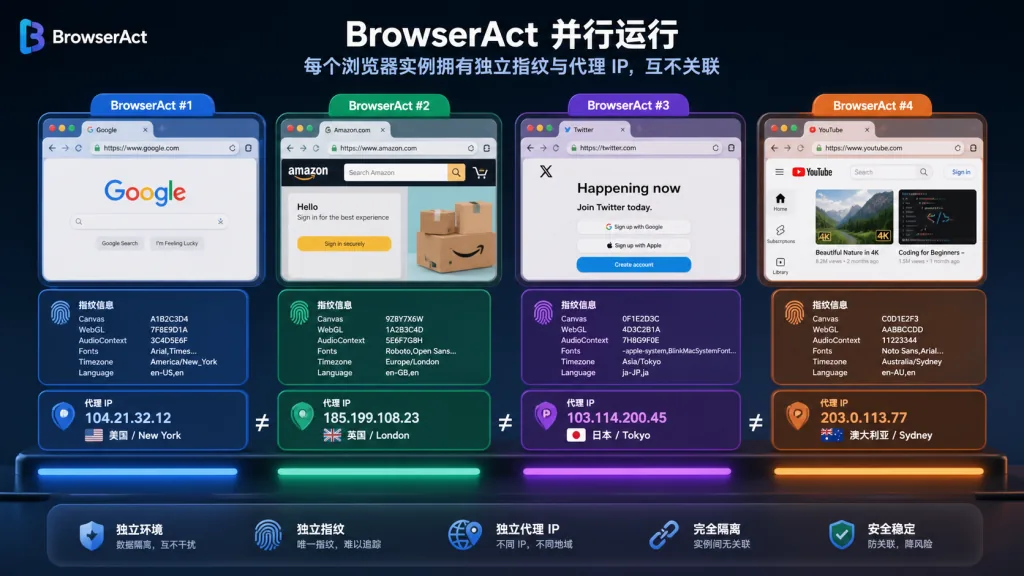
chrome 模式可复用本地 Chrome 登录态,适合需要已登录账号的任务;stealth 隐私模式每个会话生成全新指纹 + 自动轮换代理,适合无登录的批量抓取,零残留;stealth 固定身份模式则固定指纹与 IP,专为多浏览器并行运行同一账号设计,避免被关联标记。三种模式直接对应「复用本地」、「批量匿名」、「多账号并行」三大真实场景。
3. 零干扰并发
跨浏览器并行时,每个浏览器持有独立 Cookie、独立指纹、独立代理,站点无法跨会话关联账号;同一浏览器内多会话共享登录态但执行隔离,任务之间互不阻塞;隐私模式下会话结束即销毁指纹与 Profile,零数据残留。对于需要同时跑数百个账号的团队,这是刚需。
4. 为 LLM 推理而生的交互范式
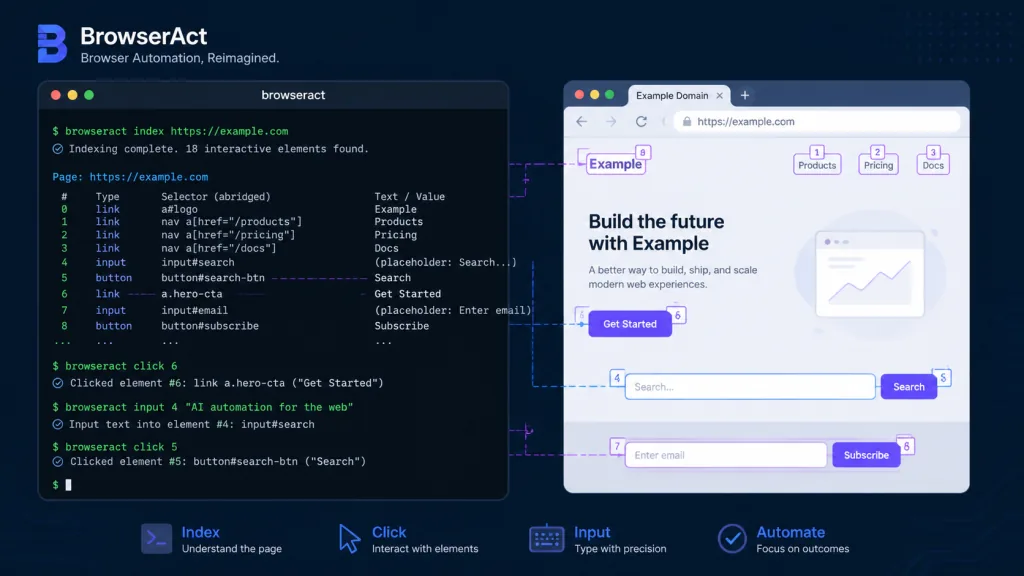
区别于传统脚本,BrowserAct 的输出是「索引化文本」而非 JSON/HTML,Token 消耗降低数倍;state 命令返回可交互元素列表,代理直接用 click 3、input 2 "hi" 按索引操作,无需解析 DOM;每个浏览器携带 desc 语义描述,按语义匹配任务;会话所有权 + 显式命名机制保证多代理并发不冲突。这套交互范式把「写脚本」变成「描述意图」。
四、技术亮点与性能数据
BrowserAct 的隐身引擎同时集成住宅代理池、TLS 指纹轮换、Canvas/WebGL 指纹伪装,配套 CAPTCHA 自动求解服务;架构上把浏览器内核抽离到云端容器,本地只留 Skill 协议层,代理通过网络调用真实浏览器;Skill Forge 子模块能一次探索站点、生成可复用的 Skill 包,单条路径稳定支撑 500 到 5,000 条记录的批量任务;兼容性覆盖 Windows、macOS、Linux 与七大主流 AI 代理;敏感操作(创建/删除浏览器、Profile 导入、代理变更)走确认门控,每次单独审批,不存在配置项被误改的安全风险。
五、适用场景与人群
场景一:跨境电商价格监控。运营团队需要并行抓取 50 个站点的 SKU 价格,BrowserAct 的固定身份模式能让 50 个浏览器实例同时挂着不同账号,互不关联。
场景二:AI 代理后台数据采集。Claude Code / Cursor 等代理需要联网拉取实时数据,传统 Playwright 在 Cloudflare 前频繁翻车,BrowserAct 的三层反检测直接解决。
场景三:社媒舆情与招聘信息抓取。Skill Forge 生成的 LinkedIn、Reddit、微信公众号 Skill 包,开箱即用,稳定跑批量任务。
适合人群:AI 代理开发者、数据工程团队、跨境电商运营、爬虫工程师。不适合人群:纯前端自动化测试工程师(用 Playwright 更顺手)、只需要本地一次性截图的用户。
六、竞品对比
| 维度 | BrowserAct Skills | Playwright + Stealth | Browser-Use 开源方案 |
|---|---|---|---|
| 反检测层级 | 三层(环境/执行/人类) | 单层指纹伪装 | 单层指纹伪装 |
| 远程人工接管 | 支持,跨设备链接 | 不支持 | 不支持 |
| 并发隔离 | 跨浏览器 + 同浏览器多会话 | 需自行实现 | 需自行实现 |
| LLM 友好输出 | 索引化文本,省 Token | DOM/HTML | DOM/HTML |
| CAPTCHA 自动求解 | 内置 | 需接第三方 | 需接第三方 |
| 免费额度 | 5 个隐身浏览器 + 全功能 | 完全免费 | 完全免费 |
结论:单点反爬 Playwright 够用,但要规模化、要稳定、要给 AI 代理用,BrowserAct 是目前最完整的方案。
七、如何快速上手
安装只需让代理执行:
Install browser-act. Skill source: https://github.com/browser-act/skills/tree/main/browser-act . Verify it works after installation.
验证安装:
browser-act get-skills core --skill-version 2.0.2
最小可用示例——零配置抓取受保护页面:
browser-act stealth-extract https://example.com
完整自动化流程:
browser-act --session my-task browser open <id> https://example.com
browser-act --session my-task state
browser-act --session my-task click 3
browser-act --session my-task input 2 "hi"
进阶建议:批量任务直接用 Skill Forge 生成专用 Skill 包;多账号场景使用 --session 显式命名;敏感操作会触发确认门控,生产环境务必保留。
八、总结与行动建议
BrowserAct Skills 的核心价值是把「浏览器自动化」从「写脚本」拉回到「描述意图」。它用一个真实浏览器内核 + 三层反检测 + Skill 协议层,解决了 AI 代理落地最棘手的反爬与并发隔离问题。5.3k Stars 与活跃的 Discord 社区证明这条路径走通了。
使用建议:先用一个 stealth-extract 命令验证反爬效果;再让 Skill Forge 针对你的目标站点生成专用 Skill;最后用 --session 管理并发,跑批量任务。
项目链接:
- GitHub:https://github.com/browser-act/skills
- 官网:https://www.browseract.com/?co-from=github
- 文档:https://docs.browseract.com
一句话推荐:如果你想让 AI 代理真正「上网办事」,BrowserAct Skills 是目前最值得装的浏览器工具包。