一、开篇:为什么你需要这个工具?
凌晨两点,你在 IDE 里盯着 AI Agent 刚刚生成的 800 行代码,脑子里只剩一个问题:这些代码到底能不能上线?
用 Cursor 半小时产出一个新功能,看着行云流水。但当你准备合入主干时,手心开始出汗:分支覆盖够吗?边界条件踩过雷吗?Agent 是不是偷偷引了一个带漏洞的依赖?更扎心的是——你想 review,可代码量已经超过你手动审计的极限。
这是 Vibe Coding 时代所有开发者的共同困境。生成速度被 Agent 拉到极限,但验证速度还停留在 2015 年。结果就是:代码产出 10x,信心却没涨 1x。
《2024 Stack Overflow 开发者调查》显示,77% 的开发者在使用或计划使用 AI 编程助手,但只有 29% 表示「高度信任」AI 生成的代码。缺口就卡在验证环节。
如果有一种方法,让 Agent 自己证明自己的代码没问题,而且你只需要读两份文档——你会怎么选?
二、项目简介:一句话说明它是什么
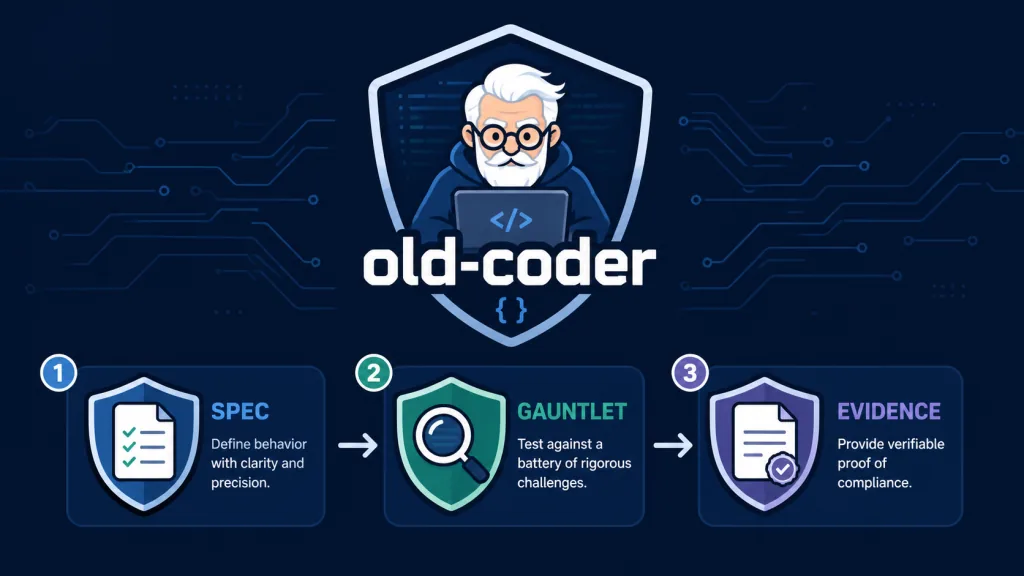
old-coder 是一个面向 AI 编程 Agent 的「证据优先开发」Skill,主张「不读代码,让代码跑过全套校验关卡」。它不读你的代码,而是让 Agent 提交 SPEC(测试计划)和 EVIDENCE(证据报告)两份文档,把验证这件事标准化、自动化、可审计。
核心关键词有四个:Test-First、Mutation Testing、Change-line Coverage、Supply Chain Audit。它兼容 Claude Code、Codex CLI、Cursor、Aider 以及任何自定义 Agent 循环——纯 Markdown 格式,无任何运行时依赖。
截至目前,该项目已收获 331 Stars,主仓库基于 Python 实现,但 Skill 本身可驱动任意语言项目。
三、核心功能深度解析
1. SPEC 先行:先写测试计划,再写代码
传统 TDD 是「先写测试再写实现」,old-coder 把这个思路抬到了 Spec 层级:Agent 在生成任何代码前,必须先输出一份 SPEC.md,写清楚「代码必须做什么、不做什么、依赖哪些工具」。你只审这一份文档,决定 yes 或 no。
这一步把需求边界从「口头描述」变成「可验收的条款」,同时把 Agent 引入供应链攻击、隐蔽依赖的窗口前移到审批环节。
2. RED → GREEN → REFACTOR 标准循环
Skill 内置了经典的红绿重构节奏,但加了一条铁律:测试一旦写好,运行期间不允许改动。这条铁律直接掐死 Agent「通过修改测试让代码通过」的作弊路径。
3. GAUNTLET 关卡:八道自动校验
跑完实现后,Agent 必须依次执行 8 项检查:
- 全量测试套件——有没有打破既有功能?
- 类型检查 + Lint + 圈复杂度——有没有低级错误或不可读的代码?
- 变更行覆盖率——新增的每一行有没有测试覆盖?
- 变异测试(Mutation Testing)——主动植入 Bug,看测试能不能抓住?
- 基于属性的测试(Property-based)——数百组随机输入能不能撑住?
- 真实执行——脱离测试 Harness,在真实环境跑得通吗?
- 供应链与密钥扫描——有没有偷偷拉危险包?有没有泄漏密钥?
- 套件健康度——测试本身稳不稳定?任意顺序跑会不会挂?
还会按任务风险模型,从 references/gauntlet.md 中追加并发、UI、API 兼容性、性能、可观测性等专项层。
4. EVIDENCE 报告:数字说话,可一键复跑
Agent 自评,但规则极严:未运行的检查只能标 unverified,不能标 pass;未审批 SPEC 的报告必须主动声明并降低置信度。最后输出 evidence.md,里面是真实跑出来的数字,不是一句「看起来没问题」。
仓库自带 demo-rate-limiter 演示:17 个测试、新代码 100% 分支覆盖、8/8 变异 Bug 全部被抓——更关键的是,整个流程发现了一个真实存在的 NaN 时间窗口绕过校验的 Bug,单元测试单独跑根本没暴露。
四、技术亮点与性能数据
架构层面,old-coder 采用 Skill + Reference 两层结构:SKILL.md 是主流程,references/gauntlet.md 是关卡清单。轻量、可插拔、可移植,符合「一个 Skill 解决一类问题」的工程哲学。
核心创新有三:
- 文档即接口:把 Agent 的工作产物收敛到 SPEC 和 EVIDENCE 两份文档上,把人类注意力从代码本身转移到验收条款和证据数字上。
- 变异测试落地:多数项目只跑覆盖率,old-coder 把 mutation testing 拉进默认关卡,这能直接暴露「测试看起来全绿但其实没断言」的伪测试。
- 诚实自评机制:用规则约束 Agent 不许作弊——这是少数把「AI 评估 AI」这件事设计成可审计流程的开源项目。
生态兼容性是另一大亮点。一行 npx skills add https://github.com/amazingang/old-coder 完成安装,支持 Claude Code 的 /old-coder 斜杠命令,也支持通过 AGENTS.md 接入 Codex CLI、Cursor、Aider。
五、适用场景与人群
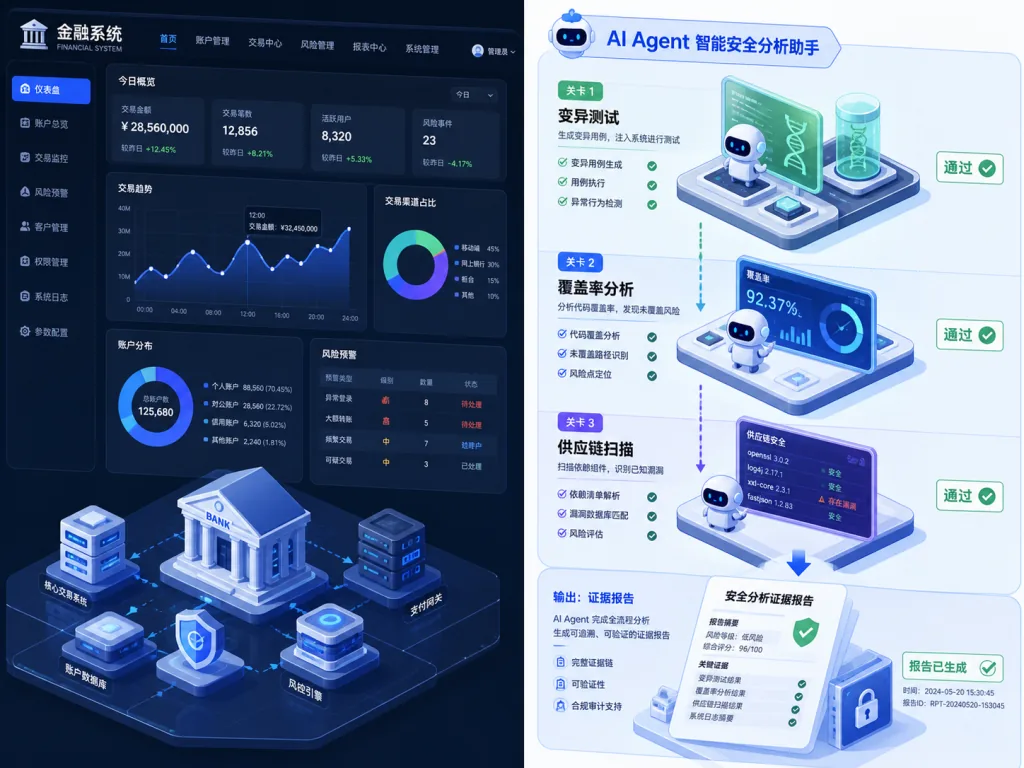
场景一:金融/支付系统重构 涉及钱、登录、数据并发的核心模块,old-coder 的全套关卡(含并发层)能拦住绝大多数回归——传统的 Code Review 在这种代码量级已经失效。
场景二:遗留系统迁移 把老 Java/PHP 服务重写到 Go/Rust,Agent 产出快但风险高。old-coder 的变更行覆盖率 + 真实执行层,能在迁移过程中持续守住基线。
场景三:开源库维护 个人开发者维护一个 star 上千的库,没时间逐行 review 社区 PR。让贡献者通过 old-coder 流程提交 EVIDENCE,你只审两份文档。
适合谁:用 AI Agent 写核心业务代码的中高级工程师;想给团队立 Coding Agent 使用规范的 Tech Lead;对「Vibe Coding 安全」有焦虑的全栈开发者。
不适合谁:纯做一次性脚本、原型 Demo、或者完全不接受任何流程约束的自由开发者。
六、竞品对比
| 维度 | old-coder | Aider --watch | Cursor 自带 Test | Cline + 自定义 Hook |
|---|---|---|---|---|
| 流程化(SPEC→GAUNTLET→EVIDENCE) | ✅ 完整 | ❌ 无 | ❌ 无 | ⚠️ 需自行配置 |
| 变异测试默认开启 | ✅ | ❌ | ❌ | ❌ |
| 变更行覆盖率追踪 | ✅ | ❌ | ⚠️ 仅整体覆盖率 | ❌ |
| 供应链/密钥扫描 | ✅ | ❌ | ❌ | ⚠️ 需额外工具 |
| 跨 Agent 兼容 | ✅ 6+ Agent | ⚠️ 仅 Aider | ❌ 仅 Cursor | ⚠️ 仅 Cline |
| 学习曲线 | 低(纯 Markdown) | 中 | 低 | 高 |
简单说:如果你的诉求是「让 Agent 自我证明 + 你只读两份文档」,old-coder 是目前 GitHub 上唯一把这件事做成端到端 Skill 的项目。其他工具要么只能生成代码,要么只能在某一种 Agent 里跑通。
七、如何快速上手
方式一:一键安装
npx skills add https://github.com/amazingang/old-coder
方式二:手动集成(Claude Code)
cp -r skills/old-coder ~/.claude/skills/
随后调用 /old-coder,或者在对话里说「prove it works」风格的需求,Skill 会自动触发。
方式三:接入其他 Agent
把 skills/old-coder/SKILL.md 内容写进你的 AGENTS.md、Cursor Rules 或系统提示词,同时把 references/gauntlet.md 放在同级目录即可。
最小可用示例:进入 demo-rate-limiter,跑 ./tools/gauntlet.sh——一行命令复现完整 evidence.md,看 8 道关卡怎么跑、报告怎么生成。
进阶建议:把 SPEC 模板接入你的 PR 模板,要求所有 Agent 生成的 PR 都附 EVIDENCE 报告;长期下来,你团队就有了可对比、可回归的 Agent 质量基线。
八、总结与行动建议
old-coder 的核心价值一句话总结:让 AI Agent 用证据交付代码,而不是用代码说服你。它重新分配了人类与 AI 在代码生产链上的注意力——人负责定义边界和审批,Agent 负责跑完全部校验并把数字交上来。
使用建议:
- 先在内部项目小范围试点,挑一个高风险模块走完整流程;
- 把 evidence.md 加入 CI 产物归档,作为后续审计依据;
- 长期沉淀团队的「Risk Model」,让 Agent 自动挑关卡,而不是每次都跑全套。
项目链接:GitHub 仓库 AmazingAng/old-coder;MIT 协议,可商用、可二次分发。
在 Agent 时代,会写代码已经不是竞争力,会验收 Agent 写的代码才是。old-coder 把这件事做成了开箱即用的 Skill,值得每个重度依赖 AI 编程的工程师收藏。