一、开篇:这个痛点,几乎每个开发者都踩过
「上次那个 bug 我已经修过了,怎么又问一遍?」「上回讨论的方案呢?这次又从头讲。」
用过 AI 编程助手的人,多半都被这种场景折磨过。每次新开会话,模型就像失忆一样——你花了十分钟讲清楚的项目背景、踩过的坑、做过的决策,下一秒全部归零。
数据能说明问题:Claude 单次会话的上下文窗口是 200K token,按当前主流模型的价格,完整回忆一次历史会话大约需要 0.6 美元;如果每天开 20 次会话,光「喂历史」一项,每月就要烧掉 360 美元。更糟的是,超过窗口的历史会被截断,模型根本无法回忆。
这不是 AI 笨,是它真的没有记忆。
二、项目简介:它到底是什么?
Claude-Mem 是一个为 AI 编程代理打造的持久化记忆压缩系统。它在 agent 工作时自动抓取每一条工具调用观察,用 AI 压缩成结构化摘要,再注入到未来的会话里。
核心特性三个关键词:持久记忆、分层检索、自动运行。
里程碑数据:GitHub Stars 突破 90,541,当前版本 v13.4.0,Node 20+ 即可运行。被收录进 Vercel 开源计划,并登上 Awesome Claude Code 列表。
适配范围极广:Claude Code、OpenClaw、Codex、Gemini、Hermes、Copilot、OpenCode 全部覆盖,几乎是「装一次,所有代理都用得上」。
三、核心功能深度解析
1. 5 个生命周期 Hook 自动捕获
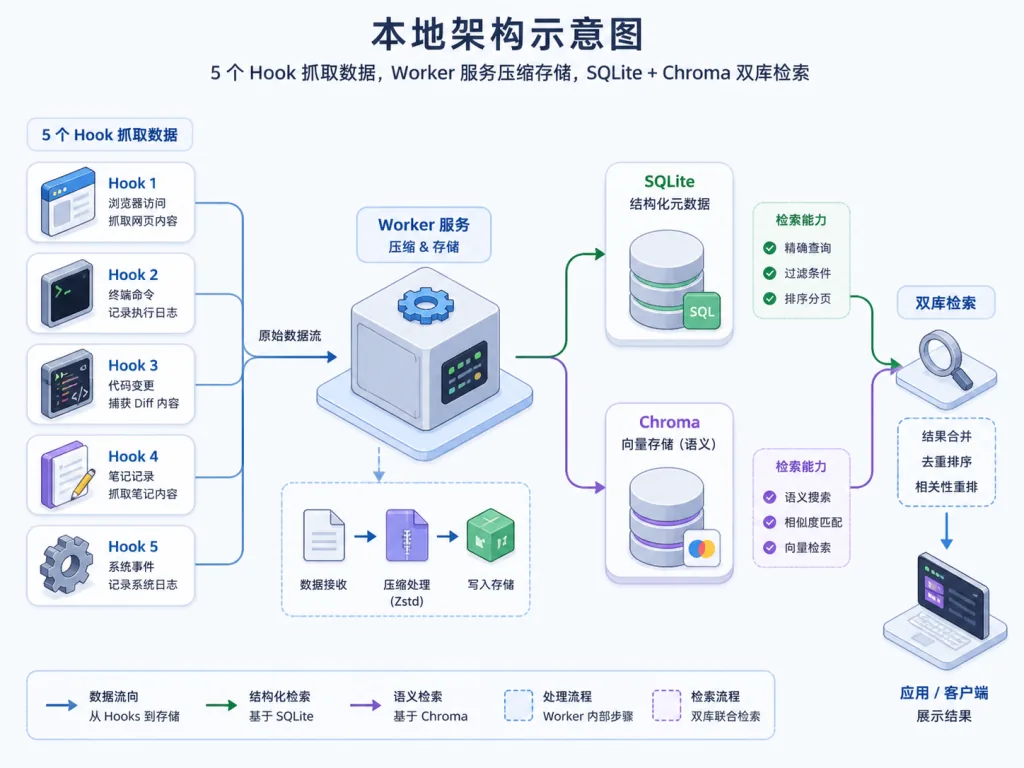
Claude-Mem 在 SessionStart、UserPromptSubmit、PostToolUse、Stop、SessionEnd 五个时点埋下 Hook,全程零人工干预:每次工具调用结束后,PostToolUse 自动把「读了什么文件、改了什么代码、为什么这么改」记录下来;SessionEnd 时统一压缩归档。开发者只管写代码,记忆系统在一旁安静工作。
2. AI 驱动的语义压缩
原始观察动辄上千 token,Claude-Mem 用 AI 提炼成「这个 session 解决了 X 问题,做了 Y 决策,留下了 Z 风险」这种紧凑摘要。据项目文档,压缩比可达 10:1,存储成本几乎可以忽略。
3. 三层渐进式检索
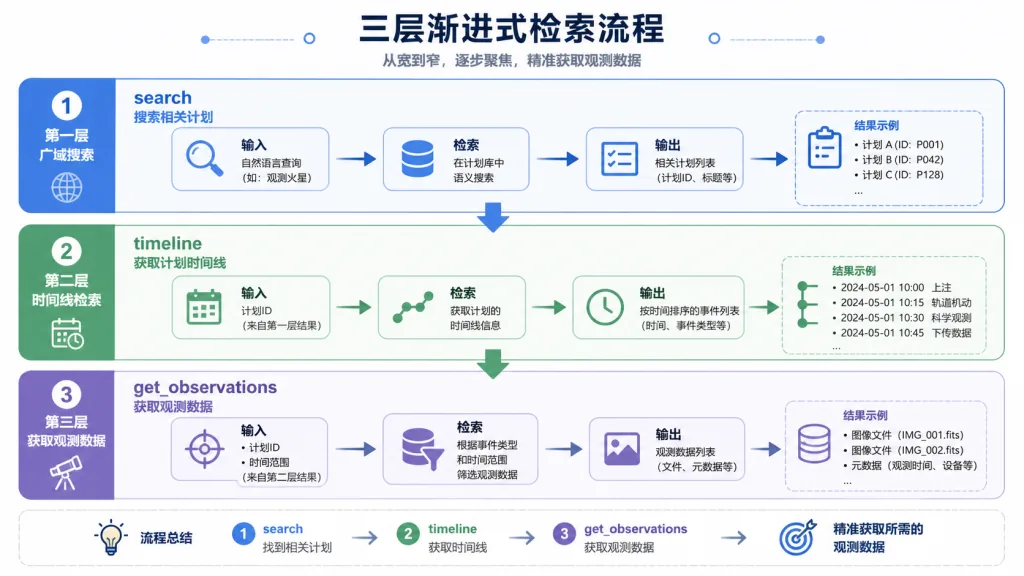
这是最值钱的设计。模型不会一上来就拉全量历史,而是按 search → timeline → get_observations 三步走:
- 第一步
search只返回索引,每条 50–100 token; - 第二步
timeline拉时间线,定位关键节点; - 第三步
get_observations只取最终选中的 ID 详情,每条 500–1,000 token。
官方数据:相比直接拉详情,这种方式节省约 10 倍 token。
4. 混合检索 + 隐私控制
底层用 SQLite FTS5 做全文检索,叠加 Chroma 向量数据库做语义匹配,关键字 + 语义双管齐下。同时支持 <private> 标签,把密钥、token 这类敏感内容挡在存储之外。
四、技术亮点与性能数据
- 架构:5 个生命周期 Hook + 1 个预安装检测脚本 + Bun 管理的本地 Worker 服务 + SQLite + Chroma,全部跑在本地,无云端依赖。
- 检索效率:三层渐进式 workflow 带来约 10 倍 token 节省;混合检索兼顾精确关键字召回与模糊语义匹配。
- 生态兼容:同时支持 Claude Code、OpenClaw、Codex、Gemini、Copilot 等主流 IDE/CLI 代理,OpenClaw 还能一键把记忆实时推送到 Telegram、Discord、Slack。
- 多语言:内置 30+ 种语言界面,包括简体中文
code--zh模式,README 翻译覆盖中文、日文、韩文、阿拉伯文等。 - 多分支发布:
main(稳定版,发布到 npm)、core-dev(核心修复)、community-edge(社区集成),兼顾稳定与尝鲜。
五、适用场景与人群
场景 1:长周期项目维护。 一个跑半年的微服务,每次开新会话都能自动回忆起「上次为什么选 gRPC」「订单模块那个边界 bug 是怎么修的」,新人接手也无需翻文档。
场景 2:多人协作的 AI 编程团队。 团队成员 A 调试过的环境问题、装过的依赖,B 第二天开会话就能直接接着干,不用再问「这个 SDK 是哪个版本」。
场景 3:上下文密集的研究 / 调研任务。 比如性能调优、安全审计,跨多次会话追踪同一主题,Claude-Mem 能保留完整的「实验 → 假设 → 验证 → 结论」链条。
适合谁:每天重度使用 AI 编程助手、长期维护复杂项目的开发者;希望降低 token 成本的团队;做 agent 工具链二次集成的工程师。
不适合谁:只在 IDE 里偶尔问一句「这段代码什么意思」的轻度用户;以及完全不接受本地常驻 Worker 服务的极简主义者。
六、竞品对比
| 项目 | 持久化记忆 | 自动捕获 | 分层检索 | 多代理兼容 | 本地部署 |
|---|---|---|---|---|---|
| Claude-Mem | ✅ 永久 | ✅ 全自动 | ✅ 三层 workflow | ✅ 7+ 代理 | ✅ |
| 手动复制粘贴历史 | ❌ 易丢失 | ❌ 人工 | ❌ | ❌ | — |
| 通用向量数据库(RAG) | ✅ | ❌ 需自建管道 | 一般无 | 需适配 | ✅ |
| IDE 内置历史记录 | 仅当前 IDE | 部分 | ❌ | ❌ | ✅ |
Claude-Mem 的差异点在于「为 AI 代理量身定制」:Hook 时点、AI 压缩、token 成本可见、分层检索协议,这些都是通用 RAG 方案不具备的。
七、如何快速上手
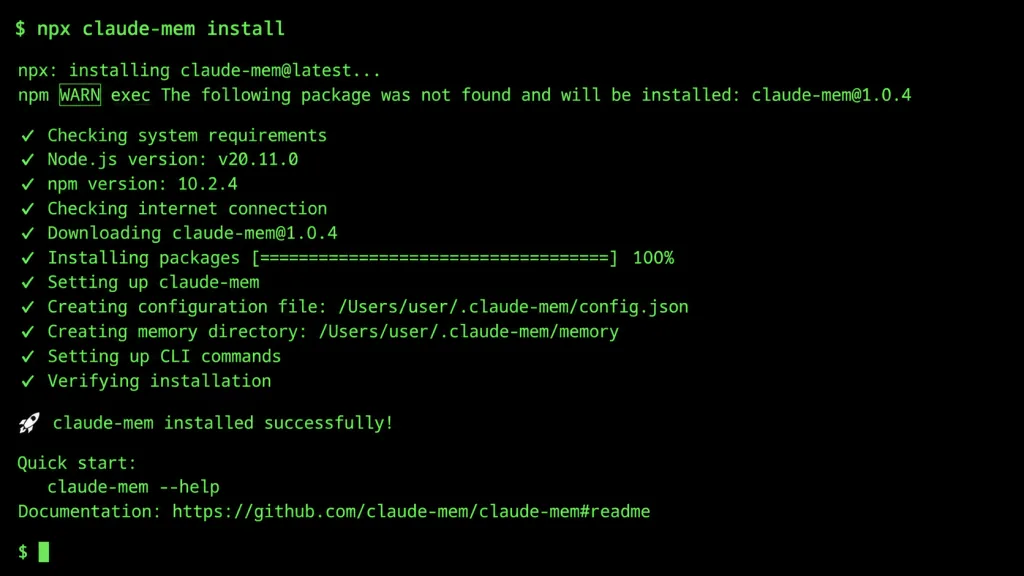
一行命令搞定安装:
npx claude-mem install
如果是 OpenCode 用户,加 --ide opencode;想用在 Antigravity CLI 上,加 --ide antigravity。安装完重启 Claude Code,之前的会话上下文就会自动出现在新会话里。
配置文件在 ~/.claude-mem/settings.json,可以调整 AI 模型、Worker 端口、数据目录等;想切到中文模式,把 CLAUDE_MEM_MODE 设为 code--zh 即可。
进阶建议:把 Cloud Sync 打开(文档见 https://docs.claude-mem.ai/cloud-sync ),多机环境无缝同步记忆;调试时直接访问 Worker 启动时打印的 URL,用 Web Viewer 实时观察记忆流。
八、总结与行动建议
Claude-Mem 的核心价值一句话概括:让 AI 编程助手真正拥有跨会话的长期记忆,同时把 token 成本压到原来的十分之一。
使用建议:先按默认配置跑一周,观察记忆条目是否合理;再用 <private> 标签圈出敏感信息;最后按团队习惯调整 CLAUDE_MEM_MODE 和 Worker 端口。
项目链接:
- GitHub:https://github.com/thedotmack/claude-mem
- 官网:https://claude-mem.ai
- 文档:https://docs.claude-mem.ai
一句话安利:装上它,你的 AI 编程伙伴第一次像个真正记得住事的同事。