一、开篇:为什么你需要这个工具?
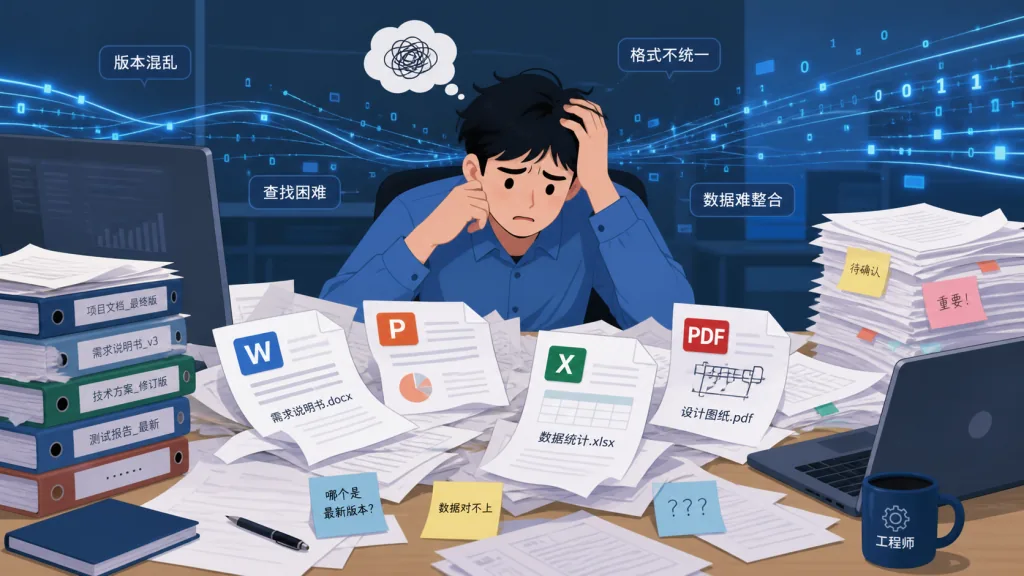
做 RAG 的工程师都懂:业务方扔过来的文档永远是「混合盲盒」——一份 Word 报告、一份老式 .doc、几张 PPT、几张 PDF 扫描件、偶尔还有 .rtf 和 .epub。传统的做法是按格式调用不同的解析器:Word 用 mammoth,PDF 用 pdfplumber,PPT 用 python-pptx……最后输出格式千奇百怪,表格错位、列表丢编号、代码块没语言标识,送进 LLM 之前还得手工清洗一遍。
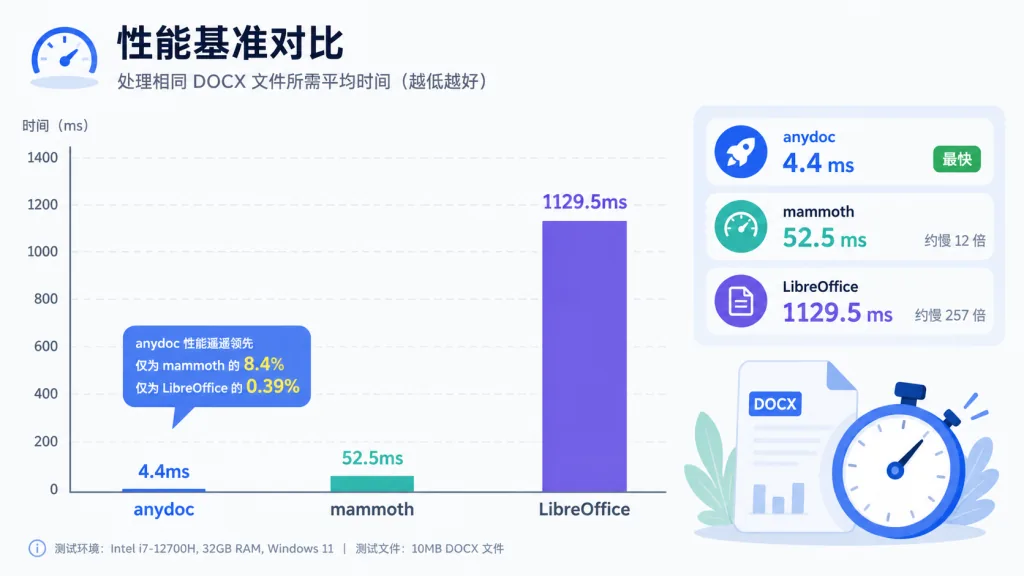
更头疼的是性能。LibreOffice 这类基于启动子进程的工具,单文档转换动辄 1 秒以上;放到批量处理 10 万份文档的管道里,时间成本直接乘以 10 万。
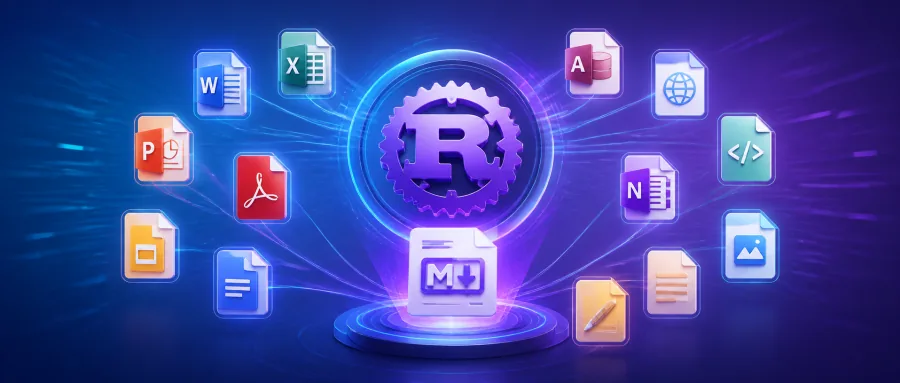
anydoc 的目标就是终结这种混乱:一份 Rust 实现、一套统一输出、毫秒级延迟,把所有办公文档塞进同一个 LLM-ready 管道。
二、项目简介:一句话说明它是什么
anydoc 是 Firecrawl 开源的 Rust 文档转换库,把 Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV、PDF 等 14 种格式统一转成 GitHub-Flavored Markdown(GFM)。它同时提供 Node.js、Python、浏览器(WebAssembly)和 Rust 原生绑定,GitHub 上已收获 14.8K Stars,是 Firecrawl Parse 服务的底层引擎。
核心特性可以用四个关键词概括:统一输出(所有格式共享同一文档模型)、全栈绑定(Rust/Node/Python/WASM 四端可用)、毫秒级速度(中位数 4.4ms)、Agent 原生(已发布为 Agent Skill,可被 Claude Code、Cursor、Codex 等直接调用)。
三、核心功能深度解析
1. 统一的文档模型与序列化器
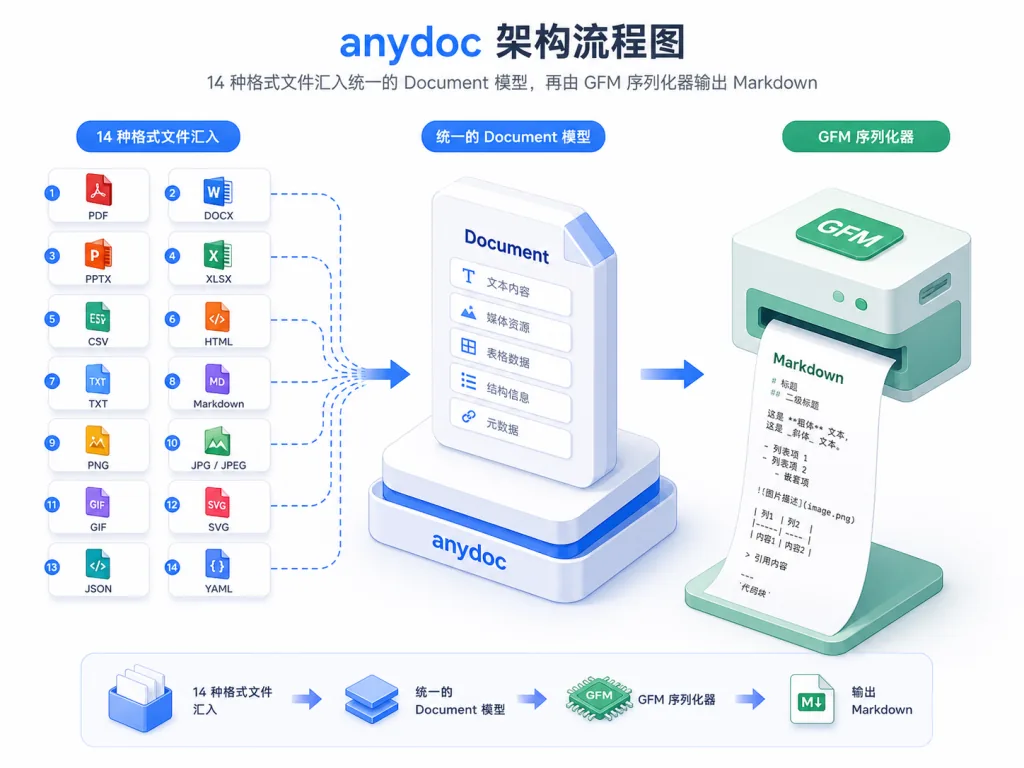
anydoc 的杀手锏不是某个格式解析得多好,而是「单一输出」。每个格式各自解析,但都汇入同一个 Document 模型(包含 blocks、inlines、tables、footnotes、assets),最终由一个 GFM 序列化器统一渲染。这意味着表格转义、标题锚点、代码块语言标识、行内代码这些细节,在 .docx 上修复一次,自动复用到 RTF、ODT、EPUB 等所有格式上——这是其他「各格式各自为政」的工具做不到的。
2. 基于内容而非扩展名的格式识别
任何以 .pdf 为后缀的 RTF 文件都会被自动识别为 RTF。anydoc 直接读取字节里的特征标记:PDF 头、RTF 开组符、OLE 流名、ZIP 包的 mimetype 和 content types。CSV 没有签名特征,因此走扩展名或显式声明路径。识别逻辑封装为 Format::from_bytes、Format::from_extension、Format::from_path 三个函数,三端 API 完全对齐。
3. 完整的文档结构保留
输出不是「纯文本 + 表格」这么简单,而是带结构信息的 Markdown:标题带锚点、粗体/斜体/删除线、行内代码与代码块、链接与内部交叉引用、保留源文档编号的有序/无序/嵌套/任务列表、合并单元格与表头识别、引用块、脚注与尾注、PPT 演讲者备注。图片用 alt 文本占位,原始字节挂在 Document 模型上,按 media type 标记,外部 URL 图片直接渲染为标准 Markdown 图像。
4. 内置 PDF 支持
文本型 PDF 不需要 OCR 服务,直接通过同组织的 pdf-inspector 库在本地转 Markdown;扫描型 PDF 才会触发 Unsupported 错误,配合 Firecrawl Parse 托管 API 可接力处理。
5. Agent Skill 一键接入
npx skills add firecrawl/anydoc 把转换能力塞进任何兼容 Agent,Claude Code、Cursor、OpenCode、Codex 都能直接「读懂」办公文档——这是同类工具普遍缺失的能力。
四、技术亮点与性能数据
性能数据最能说明问题:在 14 种格式 100 个真实文档的基准测试中,anydoc 中位数耗时 4.4ms,比第二名 mammoth 的 52.5ms 快一个数量级,比 LibreOffice 的 1129.5ms 快近 260 倍。
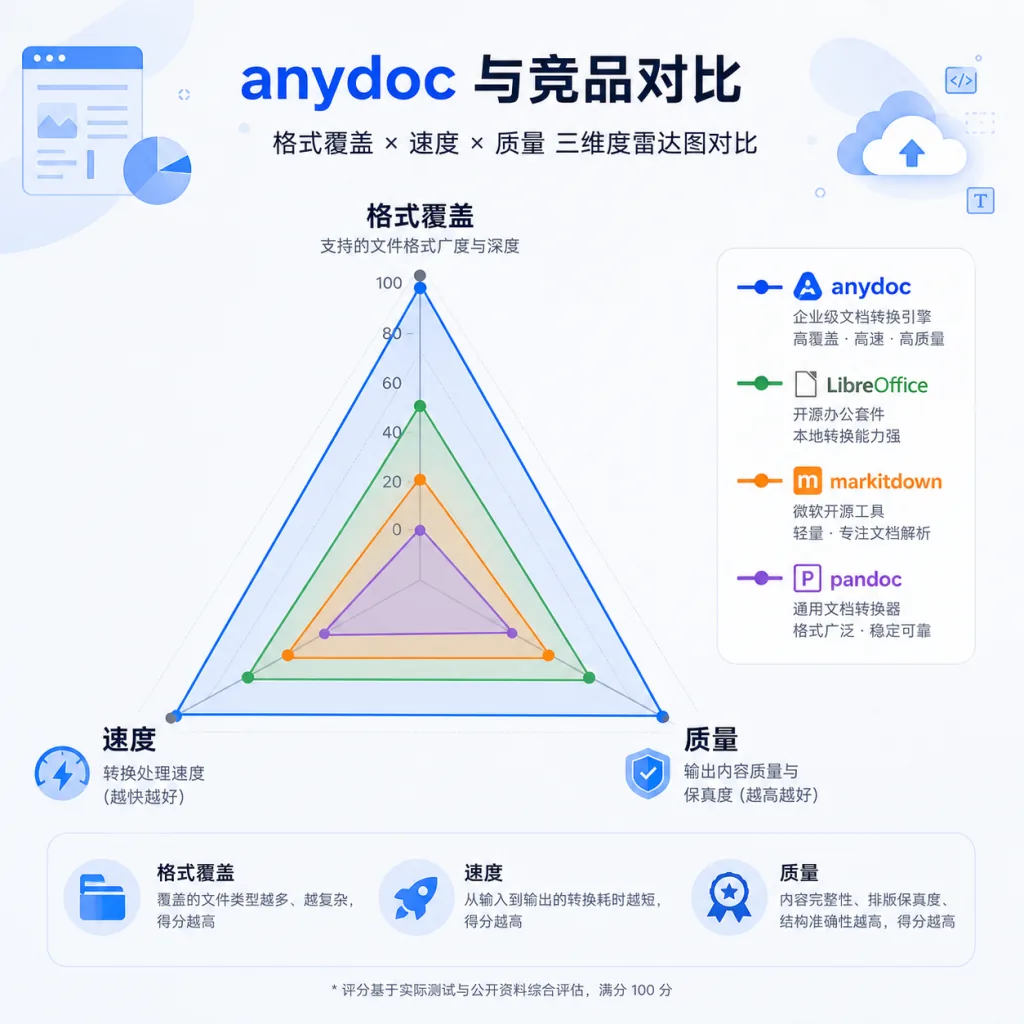
质量层面同样领先:综合分 81(满分 100),覆盖 14/14 格式——其他工具覆盖最广的也只有 12 种(LibreOffice),markitdown 仅 6 种、mammoth 仅 1 种。在 LLM 双盲评审(Claude Sonnet 5 对照真值图像,共 482 次判定)的四个维度上,anydoc 全部第一:completeness 87、structure 79、formatting 78、cleanliness 81。
架构亮点包括:纯 Rust 无 ML 模型,单二进制零外部依赖;Node.js 端转换跑在 libuv 线程池,不阻塞事件循环;Python 端转换释放 GIL,多线程并发可用;TypeScript 类型与 Python stubs 随包发布,开箱即用;测试覆盖 fixture 快照测试、mutation 测试和 cargo-fuzz 模糊测试三层。
五、适用场景与人群
场景一:RAG 与知识库构建。把客户上传的异构文档统一成 GFM 喂给向量库,再也不用为每种格式单独写清洗脚本。
场景二:AI Agent 与代码助手。让 Claude Code、Cursor 这类 Agent 直接读 Word/PPT/Excel,工具描述里写一句「用 anydoc 转换」即可。
场景三:浏览器端隐私转换。WebAssembly 版本完全在浏览器本地运行,文件不上传——医疗、法律、政府等数据敏感场景的刚需。
场景四:批量 ETL 管道。10 万份文档、毫秒级单条耗时,整批可在分钟级完成,比 LibreOffice 节省 99% 时间。
适合谁:做 RAG 的工程师、做 Agent 工具链的开发者、做文档自动化的团队。不适合谁:纯扫描型 PDF OCR 场景(需配合 Firecrawl Parse 托管 API);需要保留原始排版而非 Markdown 的用户。
六、竞品对比
| 工具 | 覆盖格式 | 中位耗时 | 综合分 | 特色 |
|---|---|---|---|---|
| anydoc | 14/14 | 4.4ms | 81 | 全格式覆盖、统一输出、毫秒级 |
| LibreOffice | 12/14 | 1129.5ms | 40 | 老牌、格式广但慢且脏 |
| markitdown | 6/14 | 134.8ms | 65 | 微软出品、生态熟但格式窄 |
| pandoc | 5/14 | 102.1ms | 56 | 学术圈标准、不支持 xlsx/pptx |
| docling | 4/14 | 513.6ms | 57 | IBM 出品、覆盖极窄 |
| mammoth | 1/14 | 52.5ms | 70 | 只做 docx、文档质量不错 |
| unstructured | 8/14 | 572.9ms | 63 | Python 生态熟、慢且格式不全 |
逐格式对比表中,anydoc 在 14 种格式全部排名第一,且往往是断崖式领先——比如 ODP 它拿 86 分,LibreOffice 仅 23 分。
七、如何快速上手
命令行(最快路径)
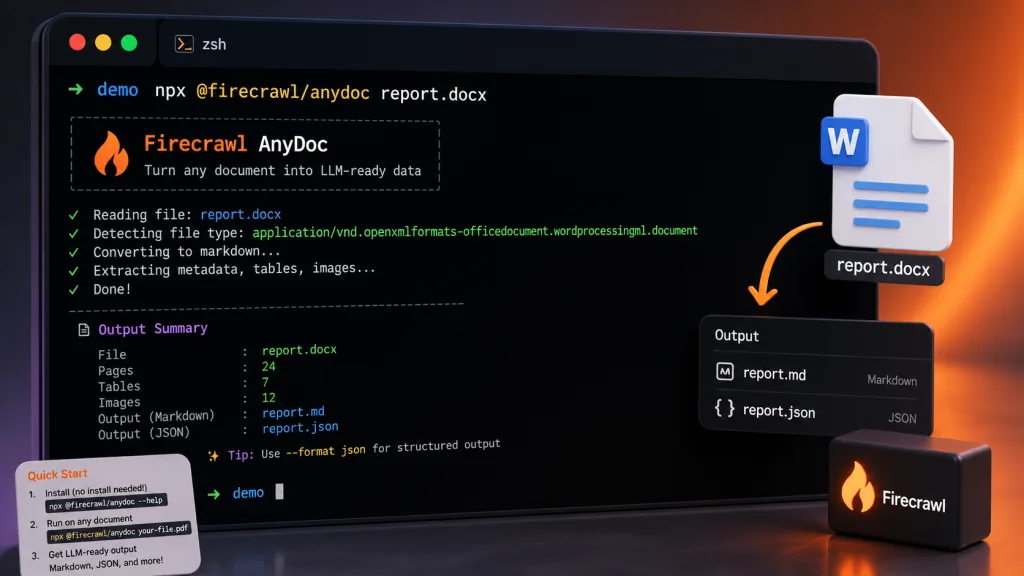
npx @firecrawl/anydoc report.docx                  # 输出到 stdout
npx @firecrawl/anydoc slides.pptx -o slides.md     # 输出到文件
npx @firecrawl/anydoc - --format csv < data.csv    # 从 stdin 读
Node.js
npm install @firecrawl/anydoc
import { toMarkdown, toMarkdownBytes } from '@firecrawl/anydoc';
const md = await toMarkdown('report.docx');
const fromBytes = await toMarkdownBytes(bytes);         // 自动识别格式
const fromCsv = await toMarkdownBytes(bytes, 'csv');    // 无签名格式需显式声明
Python
pip install firecrawl-anydoc
import anydoc
markdown = anydoc.to_markdown("report.docx")
markdown = anydoc.to_markdown_bytes(data, "csv")  # 显式声明 CSV
浏览器端(WASM)
npm install @firecrawl/anydoc-wasm
import init, { toMarkdownBytes } from '@firecrawl/anydoc-wasm';
await init();
const md = toMarkdownBytes(bytes);
Agent Skill
npx skills add firecrawl/anydoc
进阶建议:批量处理时用 to_document 拿到完整文档模型(含 assets 原始字节),按需落盘图片;处理失败的文件会被打上 Encrypted 或 Unsupported 标签,可放进重试队列交给 Firecrawl Parse OCR。
八、总结与行动建议
anydoc 用一份 Rust 代码、统一输出、毫秒级延迟解决了「办公文档 → LLM-ready Markdown」这条管道上所有格式兼容、输出一致性、性能瓶颈的老大难问题。它是当前唯一覆盖 14 种主流格式、质量分 81、速度 4.4ms 的工具,并且原生支持 Node/Python/WASM/Rust 四端和 Agent Skill 工作流。
使用建议:命令行试用先跑 npx @firecrawl/anydoc your.doc 看效果;生产集成优先选 Node.js 或 Python 绑定(避开 LibreOffice 启动开销);纯前端或隐私场景用 WASM;需要 OCR 扫描件再上 Firecrawl Parse 托管 API。
- GitHub:https://github.com/firecrawl/anydoc
- 在线试用:https://firecrawl.github.io/anydoc/
- 文档主页:https://firecrawl.dev/parse
一句话推荐:anydoc 是当下覆盖最全、速度最快、质量最高的开源文档转 Markdown 工具,做 RAG 和 Agent 的人应该人手一份。