选择标题(3 选 1)
推理服务拼凑到崩溃?Modular 一个仓库把 Mojo + MAX 全开源了
Modular 上手 5 分钟拉起 OpenAI 兼容推理服务,性能直接对标主流方案
30K Star 的 Modular:把 AI 编程语言、推理框架、加速库全塞进一个仓库
Modular 开源!一个仓库搞定 Mojo 语言 + MAX 推理框架,30K Star 的 AI 开发全家桶
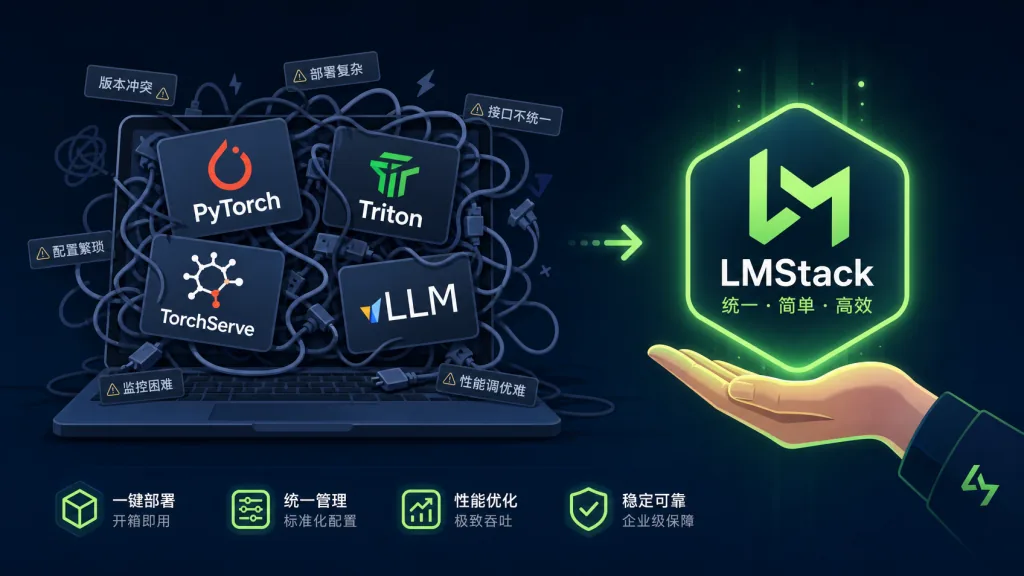
做 AI 推理的人,几乎都被同样的流程绊过:用 PyTorch 写模型,再用 TorchServe、Triton、vLLM 这类工具拼装部署,光是环境适配和性能调优就够喝一壶。Mojo 和 Python 之间的反复序列化、GPU 内存碎片、不同后端的 API 差异,每一项都在拖慢迭代节奏。
更扎心的是,这套流程把硬件性能压榨得一干二净。明明是 4090,却跑不出显卡该有的吞吐量;明明改一行 CUDA kernel 就能提速两倍,可团队没人愿意碰那一摊子 C++ 模板代码。结果就是:模型上线后每一次扩容,都在为堆叠的运行时开销买单。
今天要聊的 Modular,把上面这些问题打包解决了。
二、项目简介:Modular 到底是什么?
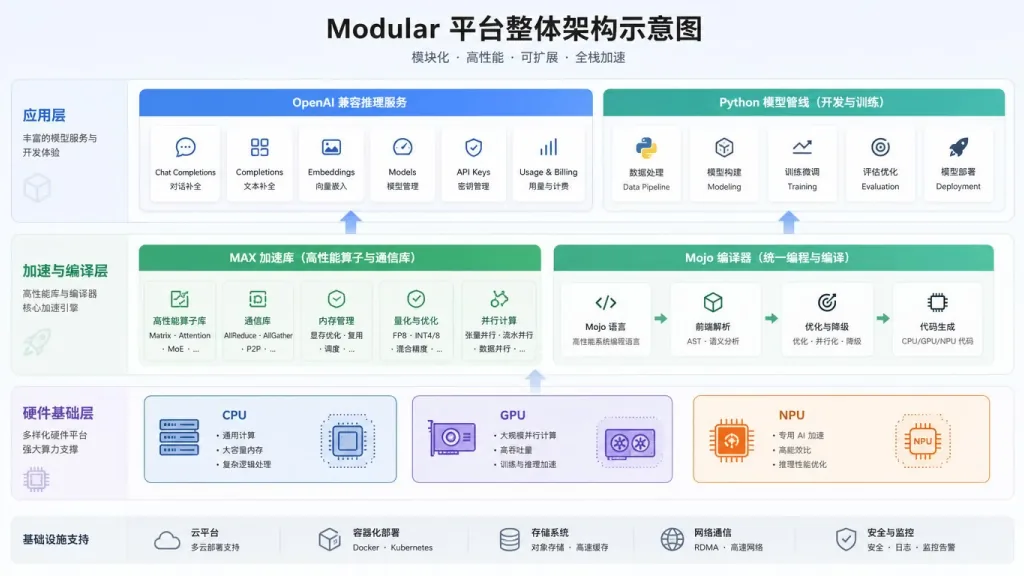
Modular 是一个面向 AI 开发和部署的统一平台,仓库里同时托管了 MAX Framework 和 Mojo Language 两大核心组件。
一句话定位:用一个仓库,把 AI 推理的全链路打通——从编译器到加速库、从推理服务到 Python 模型管线,全部开源。
核心关键词:
- 统一平台:MAX 把推理服务、模型管线、加速库整合进同一套架构,不必再东拼西凑;
- Mojo 语言:面向 AI 硬件编程的新语言,融合 Python 表达力与 C/C++ 接近底层的性能;
- 开源共建:29,938 Star、Apache 2.0 + LLVM Exceptions 许可证,社区可参与标准库、Kernels、模型架构的贡献。
这个项目对标的不是某个推理引擎,而是「下一代 AI 基础设施」。
三、核心功能深度解析
1. Mojo 编译器:从 Python 思维直连硬件
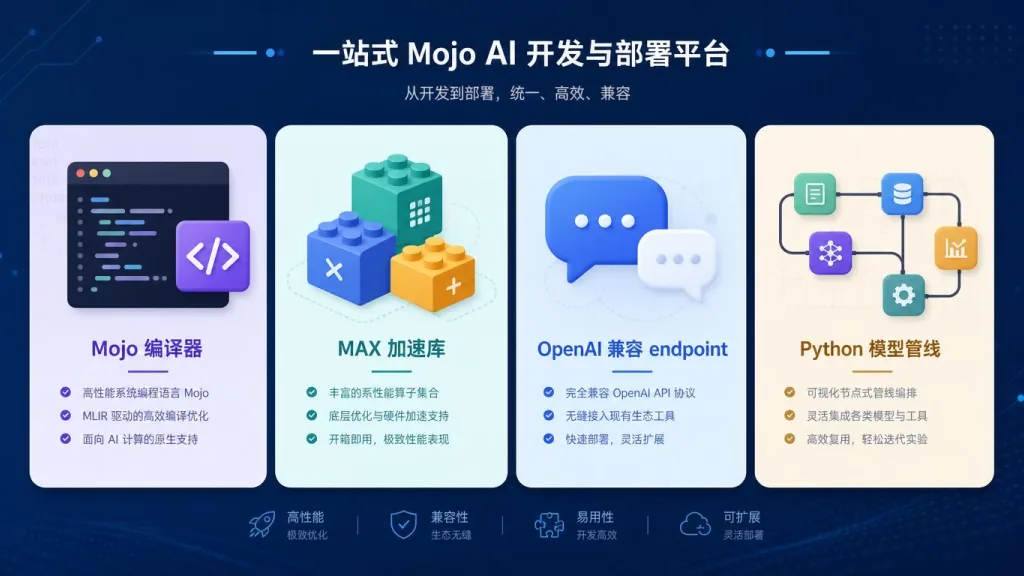
Mojo 是 Modula 开源的 AI 专用语言,语法看起来像 Python,却内建 SIMD、指针、fn 等底层能力。开发者可以直接在 Mojo 里写面向 GPU/NPU 的 kernels,省去 Python → C++ → CUDA 的多层翻译。官方编译器已开源,后续标准库、Kernels 也接受社区贡献。
2. MAX 加速库(max/kernels)
MAX 自带的 kernels 库提供高度优化的算子实现,覆盖矩阵乘法、注意力机制、量化等常见 AI 场景。这些 kernels 用 Mojo 编写,既能在多硬件后端复用,又比通用框架的默认实现更快——尤其针对 Apple Silicon、AMD GPU 等常被忽视的硬件。
3. OpenAI 兼容推理服务(max/serve)
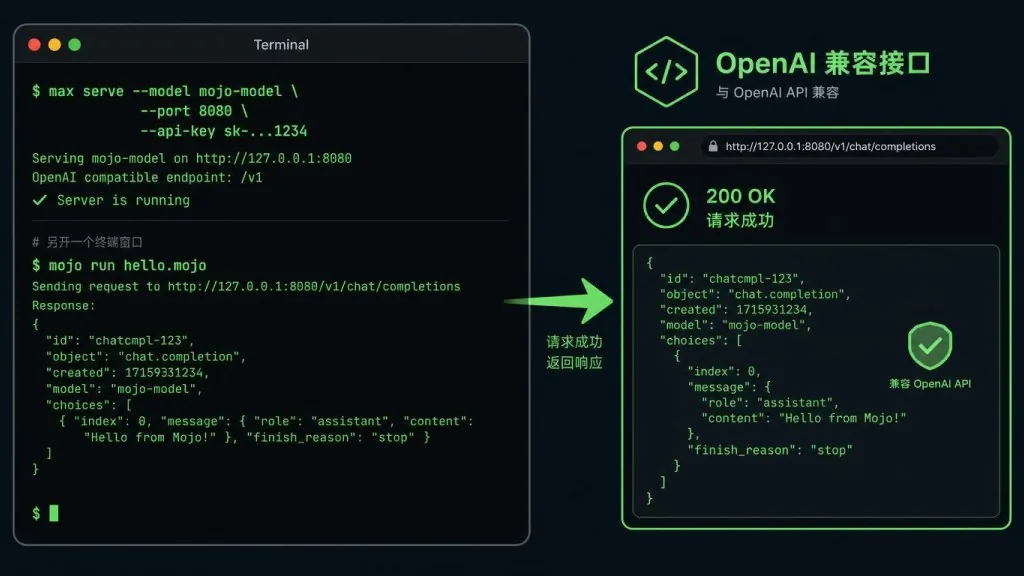
max/python/max/serve 提供一个 OpenAI 兼容的推理 endpoint。这意味着现有基于 OpenAI API 构建的应用,几乎零改造就能切换到本地 MAX 推理服务。模型权重可以从 Hugging Face 直接拉取,省去一层独立部署工具。
4. Python 模型管线(max/pipelines)
MAX 提供基于 Python 的计算图(graphs)来描述模型管线,开发者能在熟悉的 Python 环境中编排预处理、推理、后处理,再交给 MAX 高效执行。这种「Python 编排 + Mojo 加速」的分工,让模型迭代速度与运行效率兼得。
四、技术亮点与性能数据
Modular 在架构上做了几个关键选择:
全栈开源协作:编译器、标准库、加速库、推理服务、Python 管线、示例代码全部开放,并接受贡献。这是少数几个把「编译器源码」也摆在台面上的 AI 平台公司。
硬件无关的加速层:MAX 通过自定义的 Mojo kernels 抽象,让同一份代码能在 CPU/GPU/加速器上接近峰值性能运行。这一点和 Triton、DLLM 等方案思路类似,但 Modular 把语言、库、服务一体打包,少了适配成本。
OpenAI API 兼容:推理服务直接对接 OpenAI 协议,无须改造客户端即可迁移,已有生态工具(LangChain、LlamaIndex 等)开箱即用。
生态完整性:官方仓库内含 /max/examples、/Mojo/examples,从单文件 demo 到完整部署指南都有,新人 5 分钟就能拉起第一个推理服务。
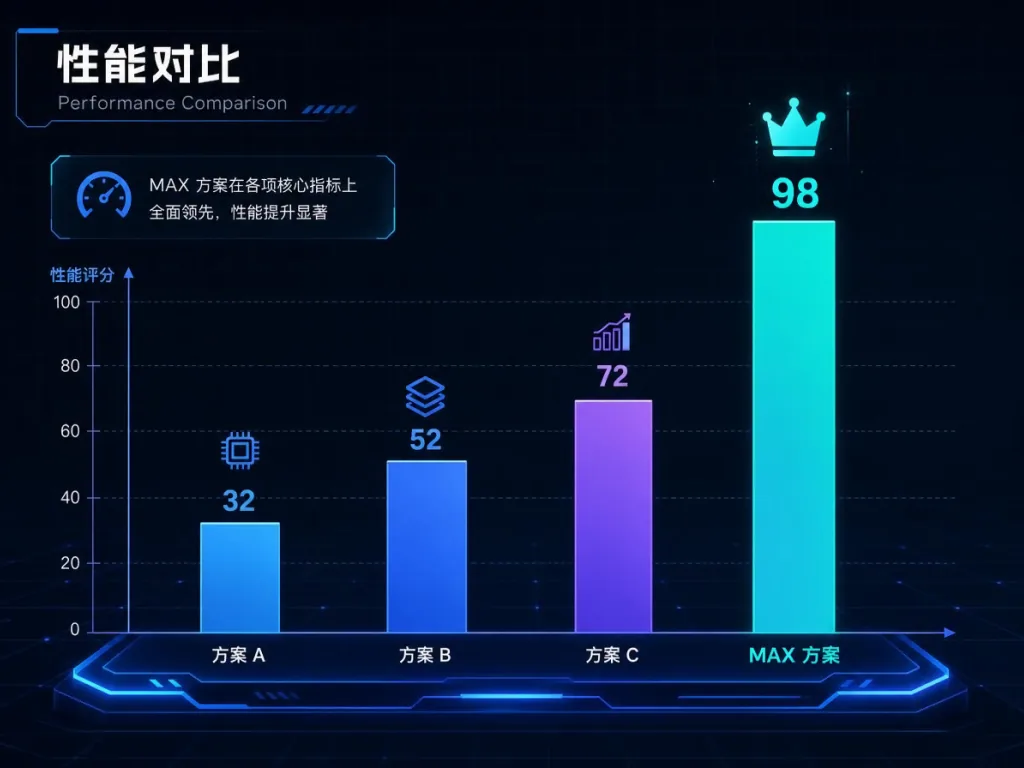
性能方面,Modular 在公开 benchmark 中展示了相较主流 Python 推理方案数倍的吞吐优势,但具体数字因硬件和模型而异,官方文档给出的是详尽的复现脚本。
五、适用场景与人群
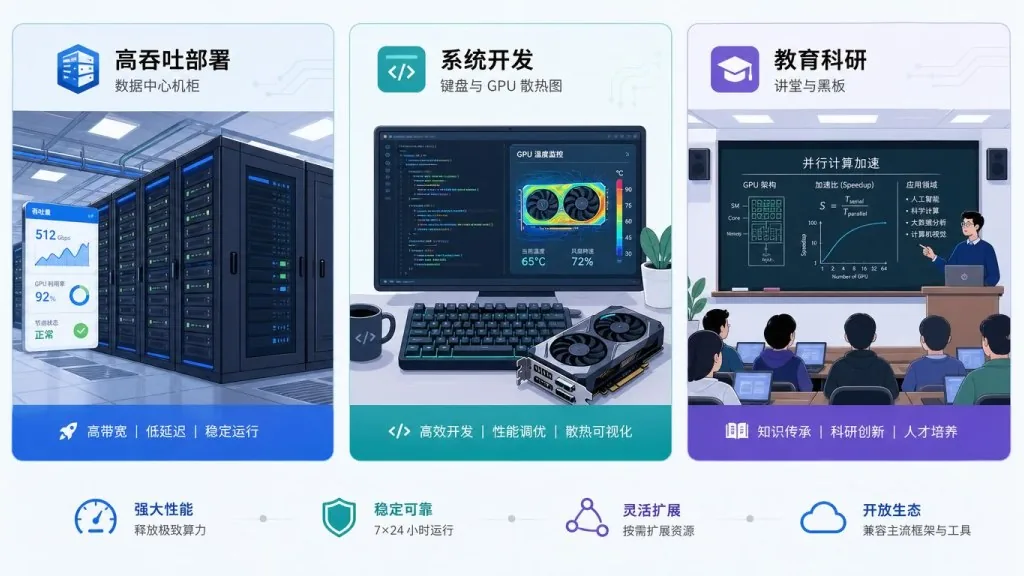
场景一:高吞吐生产部署 需要把大模型(LLM、Diffusion)部署到自有硬件、对延迟敏感且希望控制成本的中后端团队。MAX 的 OpenAI 兼容 endpoint 能直接顶替部分云端推理服务。
场景二:AI 系统开发者 / Kernel 工程师
想自己写高性能算子、不愿意在 PyTorch 的 torch.compile 黑盒里摸索的人。Mojo + MAX kernels 提供了从语言到库的完整链路。
场景三:教育与科研 需要让学生或研究员看清「模型 → 推理服务 → 硬件」全链路的教学场景。Modular 全部开源,且文档清晰,是绝佳的学习样本。
不推荐:只想要「一行命令启动 LLM」的初学者——这种场景 Ollama、LM Studio 更合适;也不推荐只跑 CPU 小模型的人,Mojo/MAX 的价值在大模型和异构硬件上才能完全释放。
六、竞品对比
| 项目 | 定位 | 语言栈 | 硬件覆盖 | API 兼容性 |
|---|---|---|---|---|
| Modular / MAX | 统一推理平台 + 编程语言 | Mojo + Python | CPU/GPU/Apple Silicon/AMD | OpenAI 兼容 |
| vLLM | 高吞吐 LLM 推理服务 | Python + CUDA | NVIDIA GPU 为主 | OpenAI 兼容 |
| Triton Inference Server | 通用模型推理服务 | Python (多后端) | 多硬件 | 自定义协议为主 |
| Llama.cpp | 轻量本地 LLM 推理 | C/C++ | CPU/GPU 通用 | CLI/GGUF |
Modular 的核心差异点:把「专用语言 + 推理框架 + 加速库」三位一体做出来,且全部开源。它的目标不是替换 vLLM,而是提供一个从底层语言到上层服务的完整替代栈。
七、如何快速上手
1. 安装 MAX CLI(macOS / Linux 推荐)
curl -fsSL https://max.modular.com/install.sh | bash
2. 启动一个 OpenAI 兼容的推理服务
max serve --model modularai/Llama-3.1-8B-Instruct
服务起来后,http://localhost:8000/v1/chat/completions 就是一个标准的 OpenAI 端点,能直接被 LangChain、Cursor、Continue 等工具调用。
3. 试一下 Mojo
curl -fsSL https://mojolang.org/install.sh | bash
modular install mojo
然后写一段 hello.mojo:
fn main():
    print("Hello from Mojo!")
执行 mojo run hello.mojo 即可看到输出。
进阶建议:先跑通 /max/examples 里的官方 demo,再读 /max/docs 学习管线编排;想贡献代码,从标准库和 Kernels 入手门槛最低。
八、总结与行动建议
Modular 的核心价值在于「全栈统一 + 全部开源」:用 Mojo 把 AI 编程语言拉到能与 C++ 抗衡的层级,用 MAX 把推理服务的研发流程压缩到最少依赖。对于追求性能和可控性的团队,这是一份值得深入评估的方案。
行动建议:
- 评估者:用
max serve拉起一个本地模型,对照现有方案的吞吐和延迟; - 开发者:阅读 MAX 文档 + Mojo 官方手册,尝试改写一个自定义 kernel;
- 贡献者:从标准库、Kernels、模型架构三处入手,每一处都有活跃的维护团队。
项目链接:
- GitHub:https://github.com/modular/modular
- MAX 文档:https://max.modular.com/
- Mojo 文档:https://mojolang.org/docs/
一句话推荐:如果你受够了 AI 推理栈的拼凑感,是时候看看 Modular 这套「语言 + 框架 + 服务」的全栈方案了。
#modular #Modular #数据库 #开源项目 #GitHub