选择标题(3 选 1)
还在为云端 OCR 烧钱?这部 iPhone App 帮你省下所有调用费
零部署门槛:旧 iPhone 跑 Vision 框架,本地 OCR 直接对标云厂商
不写一行 OCR 代码:我用一部闲置手机搭起了私有识别服务
把旧 iPhone 变成 OCR 服务器:这个 2K Star 项目做到了
一、开篇:为什么你需要这个工具?
你正在批量处理扫描件,需要把上百张图片里的文字提取出来做后续处理;你用着 Baidu OCR、阿里云 OCR、腾讯云 OCR 这类在线服务,每调用一次都在烧钱;你更担心的是:营业执照、身份证、合同截图一旦上传到第三方服务器,敏感数据就完全不受你控制了。
这种场景下,大多数人的选择只有两个:要么硬着头皮继续付费跑云端 OCR,要么退而求其次自己搭 PaddleOCR / Tesseract 服务。前者烧钱且泄露数据,后者要么依赖 Python 环境,要么要折腾 Docker、模型权重文件,部署流程劝退一大部分人。
GitHub 上一个名为 iOS-OCR-Server 的项目给出了第三种答案:把一部闲置 iPhone 变成一台本地 OCR 服务器,开机即用、无需云端、完全离线。它已经在 GitHub 拿下 2089 Stars,主仓库使用 Swift 编写,背后调用的是苹果原生的 Vision 框架。
二、项目简介:一句话说明它是什么
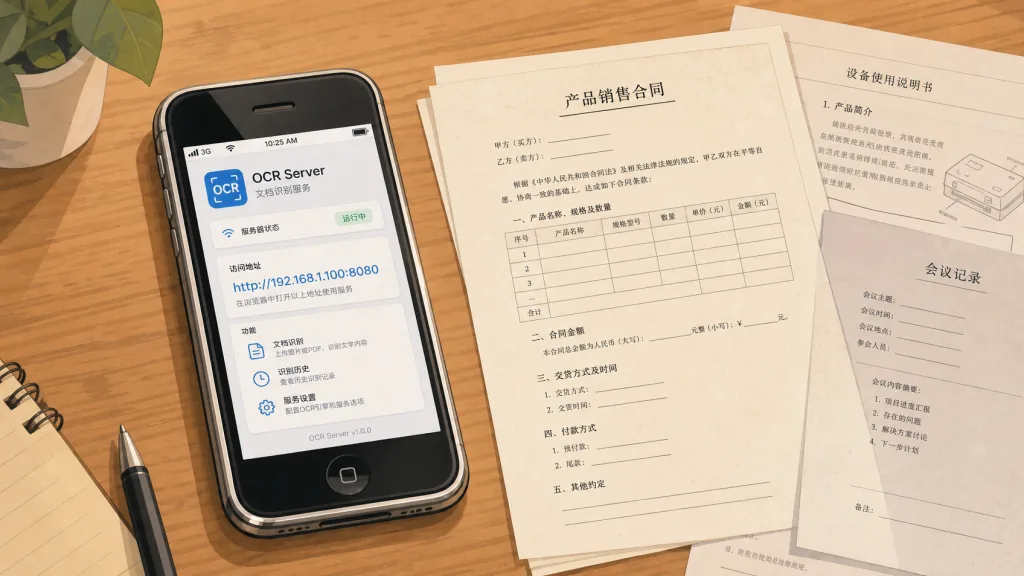
iOS-OCR-Server 是一款上架 App Store 的 iOS 应用,安装到 iPhone 后会自动启动 HTTP 服务器,把这部手机变成局域网内的 OCR 识别节点。它具备四个关键词——Vision 框架、纯本地、JSON API、零云依赖。截至本文写作时,它支持 App Store 直装(ID:6749533041),并已支持英语、日语、简体中文、繁体中文、韩语、法语六种语言界面。
三、核心功能深度解析
1. 基于 Vision 框架的高精度识别
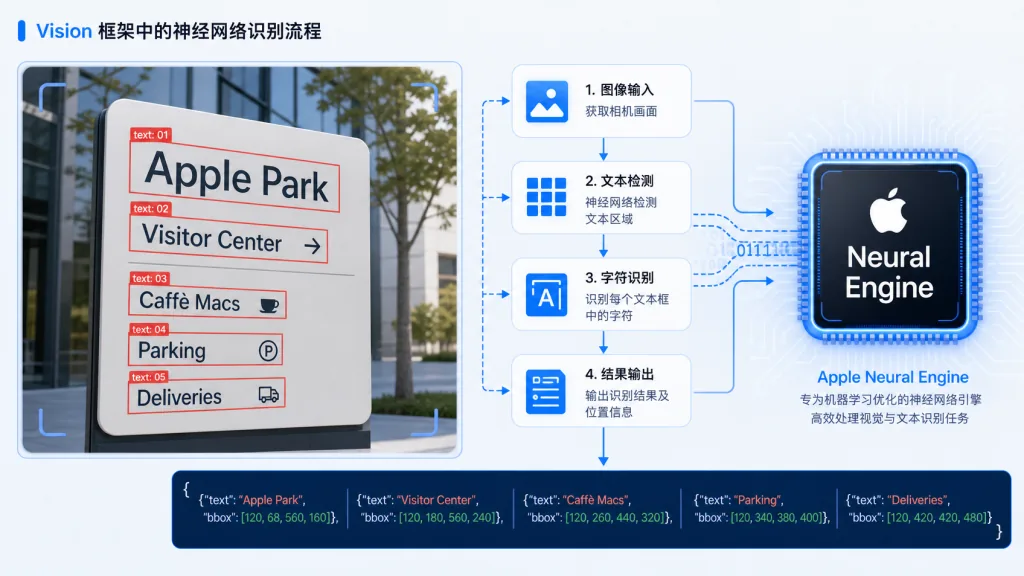
项目直接调用苹果 iOS 系统级的 Vision Framework 进行文字识别,而非引入第三方 OCR 模型。Vision 在 iOS 上经过多年迭代,对印刷体识别率极高,且完全跑在手机本地 NPU/GPU 上,无需联网、无需 token。响应中除了 ocr_result 文本外,还会回传 ocr_boxes 字段,包含每个文本框的坐标、宽高、四角顶点(rect),方便后续做版面还原或可视化标注。
2. 双 API 设计:upload 与 docOCR
项目提供两个 HTTP 接口。/upload 用于逐行/逐词级别的识别,适合普通截图、扫描件;/docOCR 是 iOS 26+ 专属接口,启用「Document Paragraph Detection」后,会按段落而非单词返回整段文字,更适合长文档结构化提取。两者都返回标准 JSON,开发者用 requests 几行代码就能接入。
3. Web UI 直接测试
不需要写代码也能用。打开 App 后记下显示的 IP,在同一局域网任意设备的浏览器访问该地址,就能看到上传页面,拖入图片即可秒级返回识别结果。这种「开箱即用」的设计对非开发者也很友好。
4. 多设备集群化部署
官方 README 明确列出了「Build an OCR processing cluster using multiple iPhones」这一使用场景。把多部闲置 iPhone 分别跑起这个 App,再在业务侧做负载均衡,就能搭出一个完全私有、零运营成本的 OCR 集群,对于中小企业或独立开发者来说非常实用。
四、技术亮点与性能数据
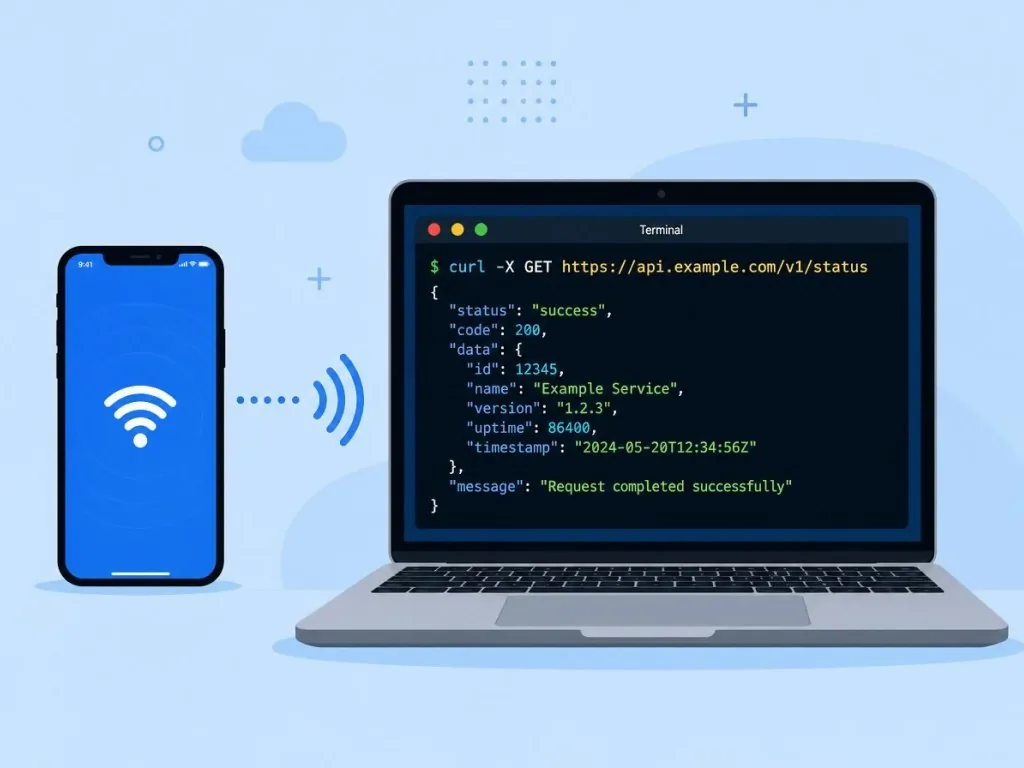
项目把 iPhone 变成了一个本地 HTTP 服务器,这意味着所有计算都跑在 A 系列芯片上,Vision 框架本身在 iPhone 上做了大量硬件加速。配合 iOS 引导访问(Guided Access)保持屏幕常亮,单机可长时间稳定对外提供服务。
相比传统方案,它带来三点差异化价值:
- 零云端依赖:识别过程完全离线,敏感图片不离开局域网,符合 GDPR / 等保等合规要求;
- 无使用次数限制:不像云厂商按调用量计费,可以无限次调用;
- 生态兼容性强:返回的是标准 JSON + 标准坐标,与现有 Web、iOS、Android、Python 后端无门槛对接。
五、适用场景与人群
场景一:企业内部 OCR 中台。财务、法务、行政团队每天要处理大量纸质材料扫描件,对数据合规要求高,本项目可以做到数据不出公司内网。
场景二:开发者的本地开发/调试环境。开发 OCR 相关功能时,每次调试都上传到云端既慢又费钱,本地 iPhone 服务器几行 curl 就能跑通。
场景三:教育/科研场景的离线批处理。在没有稳定网络的教室、实验室环境,把 iPhone 接上电源就能持续提供识别能力。
适合人群:iOS 开发者、独立开发者、中小团队技术负责人、对数据隐私敏感的用户。 不适合人群:需要识别超长卷轴文档(手机内存有限)、需要识别极复杂版面(如古籍竖排混排),这类需求仍建议走专业云 OCR。
六、竞品对比
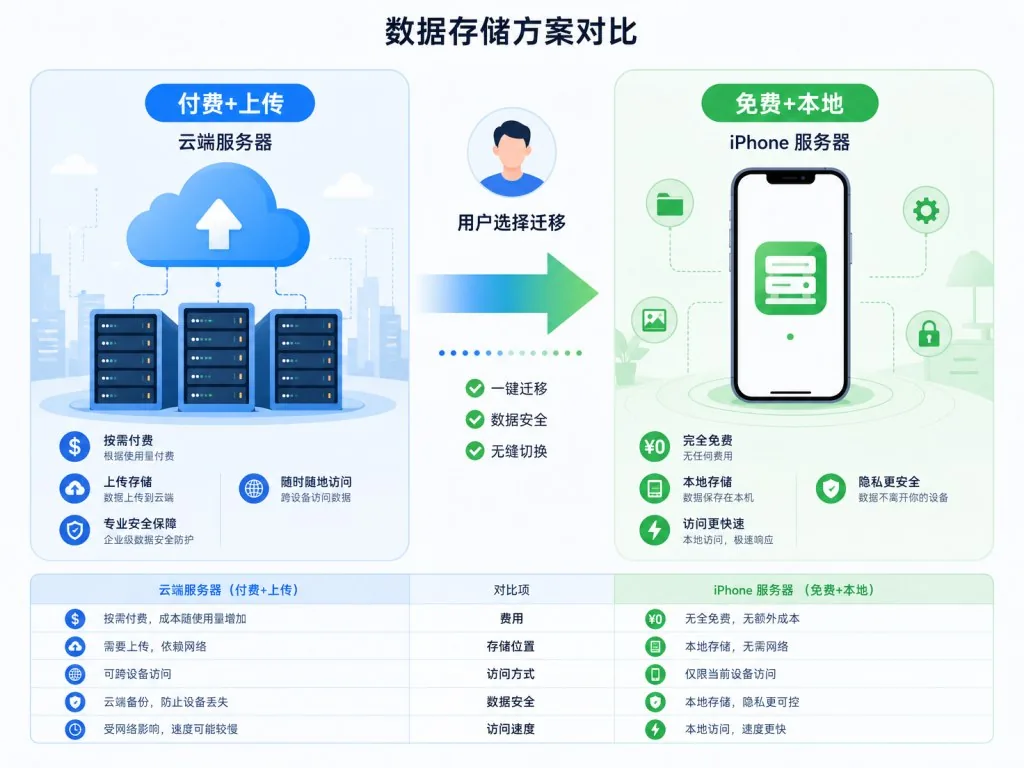
| 方案 | 部署成本 | 单次成本 | 数据隐私 | 离线能力 |
|---|---|---|---|---|
| iOS-OCR-Server | 装个 App 即可 | 0 | 数据不出局域网 | 完全离线 |
| 百度/阿里云 OCR | 注册+鉴权 | 按调用量计费 | 上传第三方 | 需联网 |
| PaddleOCR 自建 | Python+模型+Docker | 0 | 本地 | 离线 |
| Tesseract | 命令行+训练数据 | 0 | 本地 | 离线 |
iOS-OCR-Server 的最大优势在于「部署摩擦最低 + 识别质量不输云端」:Tesseract 准确率堪忧,PaddleOCR 部署复杂,云端 OCR 又有合规风险,而这部 App 安装即用、识别精度直接复用苹果 Vision 引擎。
七、如何快速上手
第一步:安装 App。在 App Store 搜索「OCR Server」或访问项目 README 中的下载链接,安装到任意一台 iPhone(iOS 16+ 即可,iOS 26+ 才能用 docOCR)。
第二步:开启 Guided Access。进入「设置 > 辅助功能 > 引导访问」,启用后回到 App 三击侧边键锁定屏幕常亮,确保服务不被系统挂起。
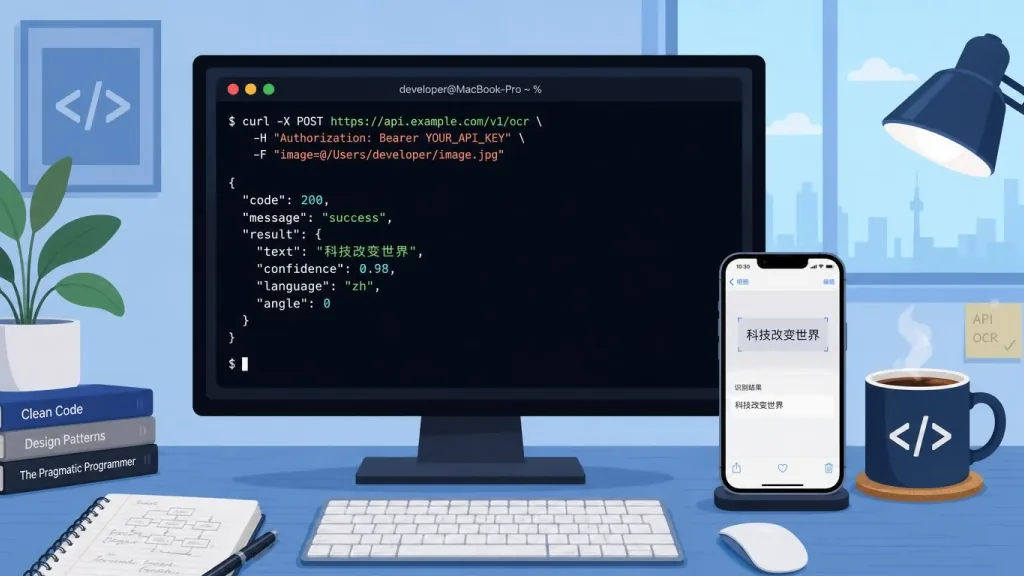
第三步:调用 API。在同一 WiFi 下的电脑执行:
curl -H "Accept: application/json" -X POST http://<YOUR_IP>:8000/upload -F "file=@01.png"
就能拿到 JSON 格式的识别结果,ocr_result 字段是合并后的文本,ocr_boxes 数组里是每个文本框的精确坐标。
第四步:可视化标注(进阶)。README 给出了完整的 Python 示例,使用 PIL + OpenCV 把 ocr_boxes 绘制回原图,红框 + 角标文字非常直观,直接复制粘贴即可运行。
八、总结与行动建议
iOS-OCR-Server 的核心价值可以用一句话概括:把「云端 OCR 服务」的能力,免费搬进你口袋里那部旧 iPhone,并且做到数据完全本地化、零运营成本、零部署门槛。
如果你正在被云端 OCR 的费用和合规问题困扰,或者只是想给手头的 iOS 项目加一个不烧钱的本地识别能力,不妨试试它。App Store 下载链接:https://apps.apple.com/us/app/ocr-server/id6749533041,GitHub 仓库:https://github.com/riddleling/iOS-OCR-Server。两千多颗 Star 已经在替你做了一次筛选。
#ios-ocr-server #IosOcrServer #riddleling #开源项目 #GitHub