选择标题(3 选 1)
每次提问都从零开始?让 OpenKB 把你的文档编译成会生长的 Wiki
丢进 100 份 PDF,OpenKB 帮你蒸馏成可分发的 Agent Skill
不用向量数据库,OpenKB 用「推理式检索」啃下 20 页长文档
一、开篇:每次提问都从零开始,你的知识库在原地踏步
你有没有过这种体验:团队里来新人,你把过去三年的项目文档、调研报告、合规材料一股脑丢给他,让他自己看。可当他第一次问你问题时,你发现——这些材料他根本没消化完。
传统 RAG 就是这个「新人」:每次提问,它都把所有文档重新读一遍、重新检索一遍、重新拼一遍上下文。看似在干活,实际上知识从不积累。同一份 PDF 被解析一百次,问答之间毫无关联,上一轮聊到的关键概念,下一轮就忘了。
更要命的是,PDF 里那些关键的图表、公式、扫描件,传统 RAG 基本读不懂;超过 20 页的长文档,召回率和准确率会断崖式下跌。
如果有个工具能把零散的文档「编译」成一份持续生长的 Wiki,知识在每次新增文档时被复用、被关联、被更新——情况会完全不同。OpenKB 就是这样一个项目。
二、项目简介:用一句话概括
OpenKB(Open Knowledge Base)是一个开源 CLI 工具,由 VectifyAI 推出。它使用 LLM 把 PDF、Word、PPT、Excel、HTML、CSV、URL 等原始文档编译成结构化、可互链的 Wiki 式知识库,并基于同团队的 PageIndex 实现面向长文档的「无向量、推理式」检索。
四个关键词:长文档可扩展、推理式检索、原生多模态、无需向量数据库。Apache 2.0 协议,已支持 Web UI(Knowledge Workbench)和 Claude Code / Codex / Gemini CLI 集成。
三、核心功能深度解析
1. 知识编译:一次入库,持续生长
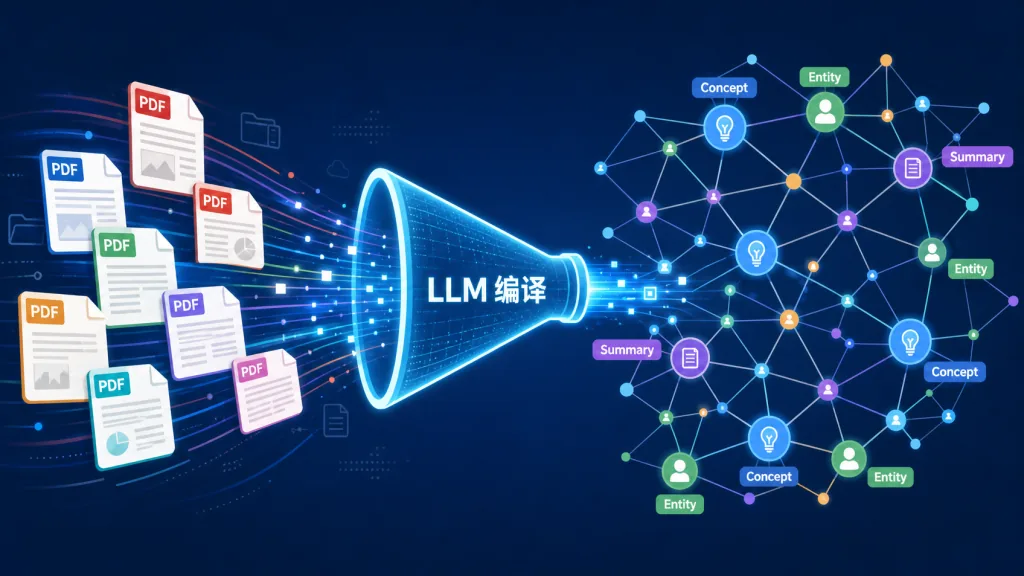
openkb add 一份文档后,LLM 会完成五件事:生成摘要页、读取已有概念页和实体页、跨文档综合创建或更新概念页、抽取人物/组织/地点/产品等实体页、更新索引与日志。一份资料往往会触及 10–15 个 Wiki 页面,后续每份新文档都会「站在前人的肩膀上」综合,而不是孤立存放。
2. 长文档推理检索:丢掉向量数据库
OpenKB 直接对接同团队的 PageIndex,对 ≥20 页的 PDF 自动构建层级树索引。LLM 读的是「文档结构树」而不是全文,更不存在分块切片导致的语义断裂。结合按需展开的子节点推理,长文档的检索既准又省 Token。
3. 原生多模态:图文表一起读
通过 markitdown 和 pymupdf,PDF、Word、PPT、Excel、HTML 中的图片、表格、公式都会被抽取和理解,不只是纯文本。这意味着财报里的图表、论文里的架构图、扫描件里的版式,都能进入知识库并被问答命中。
4. 生成器层:Wiki 不只是静态页面
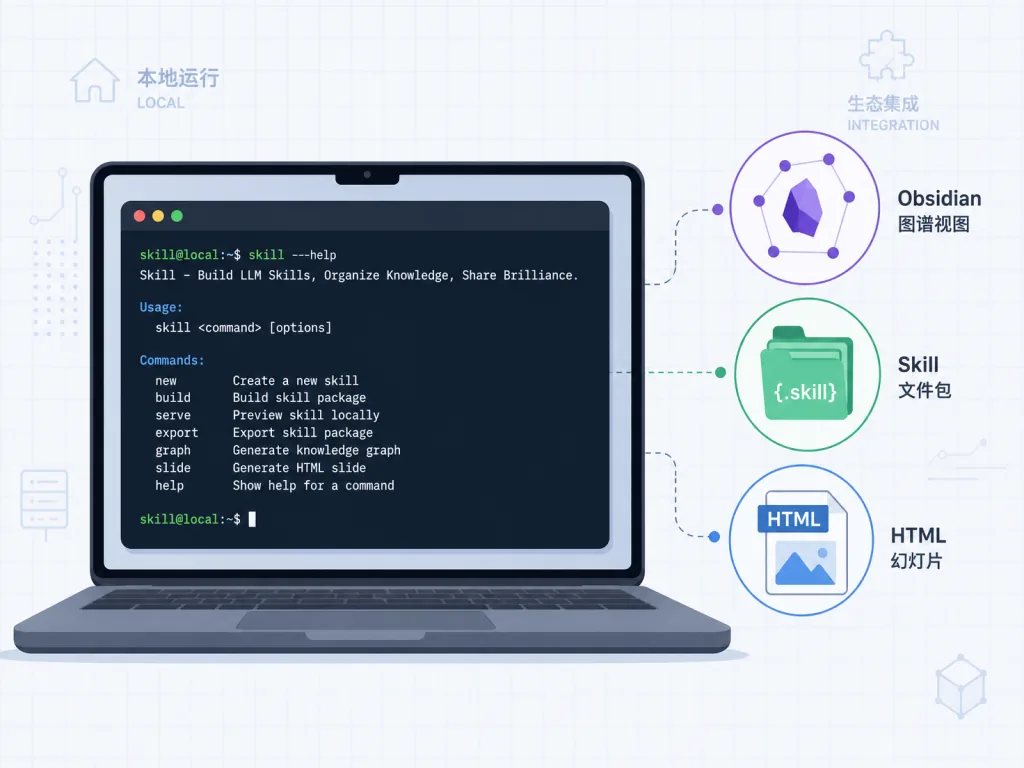
Wiki 是「地基」,生成器是「地表建筑」:openkb query 输出带引用的回答;openkb chat 支持多轮会话并持久化、可断点续聊;openkb visualize 生成 3D / 思维导图 / 径向三种交互式知识图谱;openkb skill new 把 Wiki 蒸馏成可分发的 Agent Skill(Claude Code、Codex、Gemini 可直接安装调用);openkb deck new 一键生成单文件 HTML 幻灯片。
四、技术亮点与性能数据
- 架构层:CLI(Click)+ Agent 框架(OpenAI Agents SDK,兼容 LiteLLM 多提供商)+ PageIndex 长文档引擎 + watchdog 文件监听,整体松耦合、易扩展。
- 检索范式:在主流 RAG 框架普遍依赖向量数据库的当下,OpenKB 选择 PageIndex 的「推理式检索」路线,绕开了 embedding 召回不准、分块破坏语义这两大痛点。
- 生态兼容:Wiki 是纯 Markdown +
[[wikilinks]],直接拖进 Obsidian 就是带图谱视图的 Vault;FastAPI 提供 REST API 与 SSE 流式接口;内置 Web UI 在http://127.0.0.1:7566/即可使用。 - 多模型支持:通过 LiteLLM 统一接入 OpenAI、Claude、Gemini 等;ChatGPT 与 GitHub Copilot 这类 OAuth 设备流认证的提供商甚至无需 API Key。
五、适用场景与人群
适合谁:
- 研究者与博士生:要把几十上百篇论文整理成可查询、可关联的知识网络;
- 咨询 / 投研团队:每天消化大量 PDF 报告,需要图表问答和跨文档综合;
- 企业知识管理 / 法务合规:把历史合同、政策文件、监管文件沉淀为可追溯的 Wiki;
- AI Agent 开发者:想用
openkb skill new把私域知识蒸馏成可分发的 Skill 给 Claude Code / Codex / Gemini 调用。
不太适合:只有几份短文档、临时查一次的轻量场景;完全不能联网、又不想跑本地模型的离线环境。
六、竞品对比
| 维度 | 传统 RAG(LangChain + 向量库) | Karpathy 的 Wiki 工作流 | OpenKB |
|---|---|---|---|
| 知识累积 | 每次从零检索 | 手动维护 | LLM 自动编译、跨文档综合 |
| 长文档处理 | 分块易丢语义 | 受上下文窗口限制 | PageIndex 树索引 + 推理检索 |
| 多模态 | 多为纯文本 | 手动 | PDF/Word/PPT/Excel/HTML/CSV 原生 |
| 实体抽取 | 需额外 NLP | 手动 | 自动(人物/组织/地点/产品) |
| 输出形态 | 问答 | Wiki | Wiki + 知识图谱 + Agent Skill + 幻灯片 |
| 检索范式 | 向量召回 | 全文 | 无向量、推理式 |
七、如何快速上手
安装与初始化
pip install openkb
mkdir my-kb && cd my-kb
openkb init
按提示选择模型(如 gpt-5.4 或 anthropic/claude-sonnet-4-6),并在 .env 中写入 LLM_API_KEY。
最小可用示例
openkb add paper.pdf
openkb add ~/papers/
openkb add https://arxiv.org/pdf/2509.11420
openkb query "What are the main findings?"
openkb chat
进阶建议
- 想用浏览器管理 KB:
pip install "openkb[web]"后执行openkb-web; - 想让 Wiki 在 Obsidian 里看图谱:直接用
wiki/作为 Vault; - 接入 Agent:
openkb skill new my-expert "Reason like an expert on <your-topic>"; - 持续沉淀:把新资料丢到
raw/,执行openkb watch即可自动编译。
八、总结与行动建议
OpenKB 的核心价值,是把「散落文档」变成「会生长的知识库」:LLM 帮你写摘要、抽实体、建交叉引用,长文档交给 PageIndex 做无向量推理检索,输出层既有问答、又有 Skill、又能可视化。知识每新增一份就被复用一次,而不是每次提问都从零开始。
如果你正被「文档越攒越多、检索越来越难」困扰,不妨从一个 20 页 PDF 开始跑 openkb add,感受一次「知识自己长出来」的过程。
- GitHub:https://github.com/VectifyAI/OpenKB
- 官网:https://openkb.ai
- 同生态:PageIndex(长文档检索)、ChatIndex(长对话记忆)、ConDB(KV-cache 原生上下文库)
一句话安利:丢进去一份 PDF,长出来的是一座会自己长大的 Wiki。
#openkb #Openkb #vectifyai #开源项目 #GitHub