一、开篇:为什么你需要这个工具?
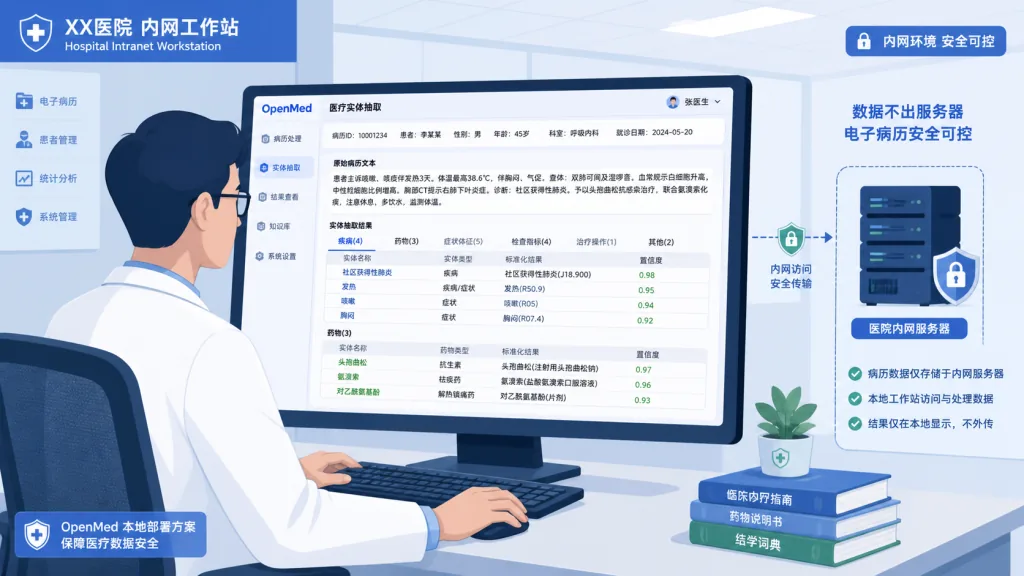
医院信息科王主任最近遇到一个棘手问题:科室要上一个临床 NLP 系统,从电子病历里抽取疾病、药物、剂量。安全部门一句话卡死——「病历不能出医院内网」。他先后试了三个云端方案,每次都要走安全评估、签数据处理协议,预算报价单上写着年付 36 万起。
这不是个例。医疗数据的合规要求让大量团队卡在「想用 AI 干点活」的第一步:HIPAA、GDPR、院内网络安全规定都在说同一件事——别把 PHI 发到外部 API。可一旦要求 100% 本地化,市面上能跑得动临床 NER 的开源方案屈指可数,而且大多数只支持英语。
OpenMed 想解决的正是这个矛盾:本地跑、海量医疗模型、覆盖多语言 PII、自带去标识化能力。GitHub 4,976 stars,PyPI 月下载量超 340 万,已经在不少医院的内网工作站上稳定运行。
二、项目简介:用一句话概括
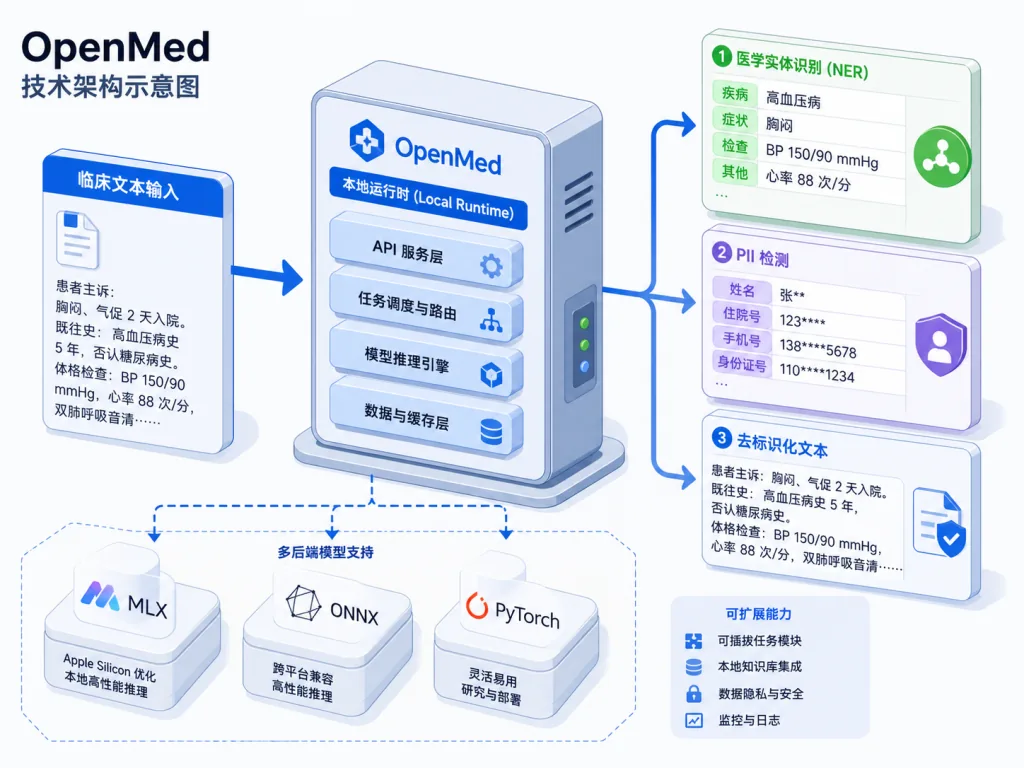
OpenMed 是一个本地优先(local-first)的医疗 AI 工具包,围绕临床命名实体识别(NER)和 HIPAA 对齐的 PII 去标识化两条主线展开,2,200+ 医疗模型、33 种 PII 语言、Apache-2.0 开源协议。核心运行时默认完全离线,数据不出内网,可部署在 CPU、CUDA、Apple MLX、Android ONNX 和浏览器上。SDK 用 Python,移动端配 Swift/Kotlin 双端,REST 服务、FHIR/HL7 互通、Transformers.js 导出都已就位。
三、核心功能深度解析
1. 临床 NER:识别疾病、药物、解剖、基因
OpenMed 的模型目录覆盖五个垂直方向:disease_detection_superclinical(疾病/诊断,434M)、pharma_detection_superclinical(药物/治疗,434M)、pii_superclinical_large(PII,434M)、anatomy_detection_electramed(解剖/器官,109M)、gene_detection_genecorpus(基因/蛋白,109M)。一行代码即可调用:
from openmed import analyze_text
result = analyze_text(
    "Patient started on imatinib for chronic myeloid leukemia.",
    model_name="disease_detection_superclinical",
)
for entity in result.entities:
    print(f"{entity.label:<12} {entity.text:<28} {entity.confidence:.2f}")
输出:DISEASE chronic myeloid leukemia 0.98;DRUG imatinib 0.95。这种开箱即用的 API 形态让临床 NLP 不再需要几周的数据标注和微调周期。
2. PII 去标识化:HIPAA Safe Harbor 对齐
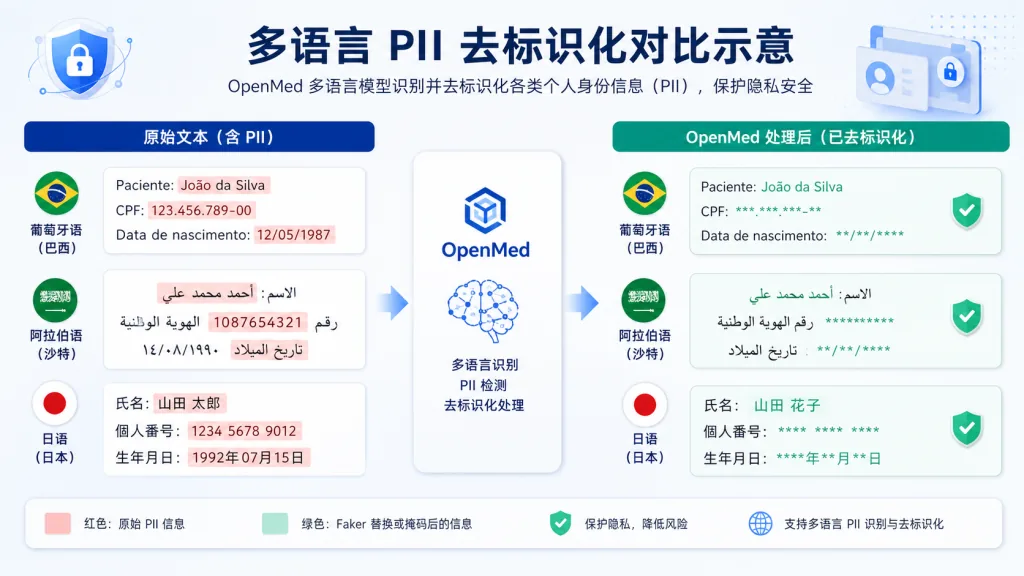
extract_pii 和 deidentify 两个函数构成隐私保护核心。支持 18 类标识符,覆盖姓名、生日、SSN、电话、邮箱、地址、就诊号等。脱敏方法四种可选:mask(掩码)、replace(Faker 替换为同语种伪数据)、hash(哈希)、shift_dates(日期偏移保留时间序列)。
值得注意的是 smart entity merging 机制:传统 NER 常把 01/15/1970 切成 01、/15、/1970 三个碎片,OpenMed 通过合并策略把完整日期、电话、身份证号作为一个实体保留,避免下游规则引擎漏判。
3. 33 种 PII 语言 + 国家 ID 校验
从阿拉伯语的 29801011234567 到日本的 マイナンバー 1234 5678 9012、荷兰的 BSN、巴西的 CPF、西班牙的 DNI,OpenMed 都配了对应 Faker locale 和校验器。一行 lang="ja" 就能切换,无需手动加载多份模型。
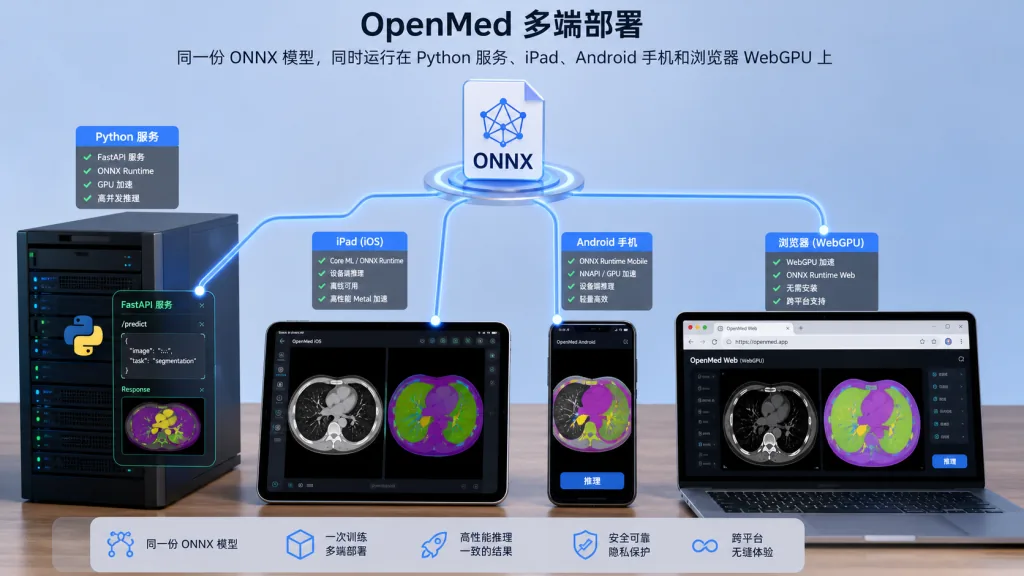
4. 多端部署:Python / Swift / Kotlin / 浏览器
同一份 ONNX 模型既能在 Python CPU 上跑,也能在 Android ONNX Runtime Mobile、iOS 的 Apple MLX、浏览器 Transformers.js + WebGPU 上跑。对需要在手机端离线录入病历的野外场景,OpenMedKit (Swift) 提供了扫描即去标识化的链路。
四、技术亮点与性能数据
MLX 加速 在 Apple Silicon 上表现亮眼:Privacy Filter 推理延迟比 CPU PyTorch 快 24–33 倍(中位数推理时延)。批量 PII 处理 在 CPU 上吞吐提升 3.3 倍,在 MLX 上提升 2.2 倍,相比逐文档处理。
架构层面有几个值得关注的点:
- OpenAI Privacy Filter 架构作为基座(gpt-oss 风格稀疏 MoE + 局部注意力 + sink tokens + RoPE+YaRN + tiktoken
o200k_base),OpenMed 提供三个变体(baseline、Nemotron 微调、多语言),共用同一 API; - 后端自动路由:MLX 模型名在非 Apple 硬件上自动回退到 PyTorch 检查点;
- 离线/气隙部署:把
model_id指向本地目录,运行时完全不再联系 Hugging Face Hub; - 生态兼容:PyTorch、CUDA、MLX、CoreML、ONNX Runtime Mobile、Transformers.js、WebGPU 全覆盖;
- REST 服务 提供
/health、/analyze、/pii/extract、/pii/deidentify四类接口,附 keep_alive、模型热卸载、API key/JWT、动态批处理、限流、可观测指标。
五、适用场景与人群
典型场景:
- 医院信息科要把 10 年电子病历批量结构化抽实体,又要满足数据不出内网;
- 保险科技公司在本地工作站跑理赔文本去标识化,再喂给下游分析;
- 跨国多语言病历研究,需要葡萄牙语、阿拉伯语、日语、土耳其语混合抽取;
- 移动端随访 App 让医生在 iPad 上离线录入并自动遮蔽患者姓名;
- 学术研究用 FHIR/HL7 把脱敏后的临床数据接入队列分析。
适合谁: 医疗信息化工程师、临床研究人员、医学 NLP 团队、医疗 SaaS 初创、需要合规审计的乙方集成商。不适合谁: 只想跑几个公开数据集 demo、不在意本地化部署的纯算法爱好者——直接用 Hugging Face 云端推理更省事。
六、竞品对比
| 维度 | OpenMed | AWS Comprehend Medical | Hugging Face 云端 NER | 自训 BERT-Biomedical |
|---|---|---|---|---|
| 部署形态 | 本地 / 移动 / 浏览器 | 仅云 API | 仅云 API | 本地 |
| 模型数量 | 2,200+ 医疗模型 | 闭源单一模型 | 通用模型 | 自己训练 |
| 多语言 PII | 33 种 + 国家 ID 校验 | 有限 | 需自配 | 从零搭建 |
| 去标识化方法 | 4 种 + 策略配置文件 | 单一方案 | 无内置 | 无内置 |
| 数据出网 | 默认不出 | 必须出 | 必须出 | 可不出 |
| 许可 | Apache-2.0 | 商业付费 | Apache/MIT | 自定 |
选择 OpenMed 的核心理由只有一个:它是少数同时满足「医疗垂直模型丰富」「完全本地化」「多语言 PII 内建」三个条件的开源方案,而且 SDK 是 Apache-2.0,商用没有授权障碍。
七、如何快速上手
1. 安装(30 秒)
# CPU / CUDA
pip install --upgrade "openmed[hf]"

# Apple Silicon 加速
pip install --upgrade "openmed[mlx]"

# REST 服务
pip install --upgrade "openmed[hf,service]"
2. 最小可用示例
from openmed import analyze_text

result = analyze_text(
    "Patient received 75mg clopidogrel for NSTEMI.",
    model_name="pharma_detection_superclinical",
)
print([(e.label, e.text) for e in result.entities])
3. 进阶建议
- 内网环境把
model_id指向预下载的本地目录,断网也能跑; - 用
BatchProcessor(operation="deidentify", batch_size=16)处理万级文档; - 生产部署用 Docker 镜像 +
OPENMED_PROFILE=prod启动 REST 服务; - Android 集成参考
android/README.md,iOS 集成参考swift/OpenMedKit; - Agent 开发者可直接装
./install-skills.sh把 Skill 注入 Claude Code / Codex / OpenCode。
八、总结与行动建议
OpenMed 把「医疗 NLP 必须上云」这件事的默认假设打破了。2,200+ 模型、33 种 PII 语言、Apple MLX 24 倍加速、Apache-2.0 商用友好,再加上 iOS/Android/浏览器全端覆盖——它已经不是一个 demo 项目,而是一套可以塞进医院内网工作站的工程化方案。
使用建议: 先用 disease_detection_superclinical 跑通你科室的真实数据样本,确认实体准确率;再叠加 pii_superclinical_large 加一道合规护栏;最后用 REST 服务或 Docker 镜像接入现有 ETL。如果你正在做多语言项目,强烈建议跑一遍 lang="pt"、lang="ja"、lang="ar" 的端到端 demo,亲眼看 Faker 替换的伪数据是否符合本地习惯。
- GitHub:https://github.com/maziyarpanahi/openmed
- 官网:https://openmed.life/
- 文档:https://openmed.life/docs/
- PyPI:https://pypi.org/project/openmed/
- 论文:https://arxiv.org/abs/2508.01630
一句话推荐:如果你受够了病历不能出内网和 NLP 精度不可兼得的拉扯,OpenMed 是当下最值得在本地工作站上跑一遍的开源医疗 AI 工具包。