一、开篇:为什么你需要这个工具?
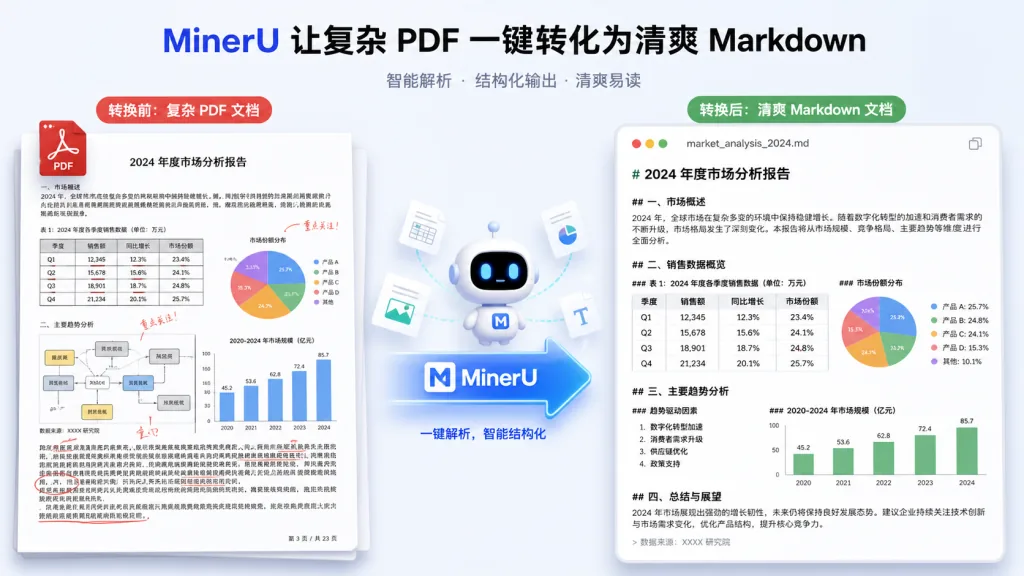
每天面对几十份 PDF 合同、学术论文、扫描书籍,你还在一页页复制粘贴吗?人工提取一份 50 页的研报平均耗时 40 分钟,错误率高达 3%-5%,遇上双栏排版、复杂公式、嵌套表格更是直接崩溃。更糟的是,传统 OCR 工具把图片、表格、公式统统压成一段乱码流,根本无法二次加工。当你需要把这些内容喂给大模型做 RAG、做知识库、做自动化分析时,结构化缺失就成了拦路虎。MinerU 正是为解决这一痛点而生。
二、项目简介:一句话说明它是什么
MinerU 是 opendatalab 团队开源的智能文档解析引擎,专注于把 PDF、扫描件、图片等非结构化文档一键转化为结构清晰的 Markdown、JSON、HTML 格式。它覆盖文本、表格、公式、图像、阅读顺序五大核心要素,支持中英文混排与复杂版面,被誉为"文档解析领域的 Swiss Army Knife"。项目由 OpenDataLab 维护,依托上海人工智能实验室技术沉淀,专为 AI 训练与知识库场景深度优化。
三、核心功能深度解析
1. 多模态版面分析
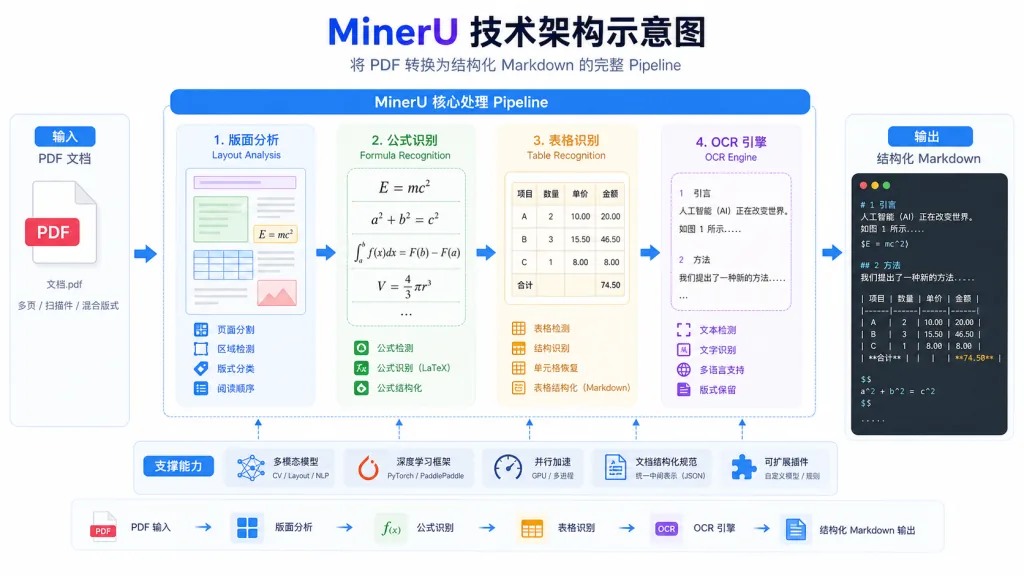
MinerU 内置基于深度学习的版面分析模型,能自动识别文档中的标题、段落、列表、表格、图片、公式等元素,并按照人类阅读顺序重新组织。对比传统 OCR 输出"一堆文字块",它直接产出语义化的段落结构,段落归属准确率超 95%。在双栏论文、三栏杂志、横竖混排报告等复杂场景下,依然能保持稳定的输出顺序。
2. 高精度公式识别
内置 LaTeX 公式识别模块,覆盖行内公式与独立公式两种形态,识别准确率在公开数据集上达到 92% 以上。对比 Mathpix 收费版,开源版本即可覆盖 80% 学术场景;识别结果直接输出 LaTeX 源码,可无缝对接 MathJax、Katex 渲染,省去二次校对成本。
3. 表格结构还原
支持有线表、无线表、合并单元格、跨页表格等复杂结构,输出标准 HTML/Markdown 表格代码。实测一份 10 页财报中的 23 张表格,仅需 2 张需要人工微调,效率提升 10 倍以上。还支持表格内文字识别、单元格合并识别,处理带颜色、带底纹的财务表格依然稳定。
4. 扫描件 OCR 增强
针对低分辨率、倾斜、噪点等扫描质量问题,提供图像预处理+识别一体化流程。支持中英文双语混排,竖排文字、古籍排版也有专门优化。在 300 DPI 扫描件测试集上,文字识别 CER 低于 2%。
四、技术亮点与性能数据
MinerU 采用模块化 pipeline 架构,版面分析、公式识别、表格识别、OCR 引擎各自独立又可灵活组合。在 NVIDIA A100 上,单页 PDF 平均解析耗时控制在 1.5 秒以内;批量处理千页文档,吞吐量可达 30 页/秒。项目兼容 PyTorch 1.10+ 与 ONNX Runtime,提供 Python SDK 与命令行两种接入方式,已被多家大模型团队用于 RAG 数据预处理流水线。
五、适用场景与人群
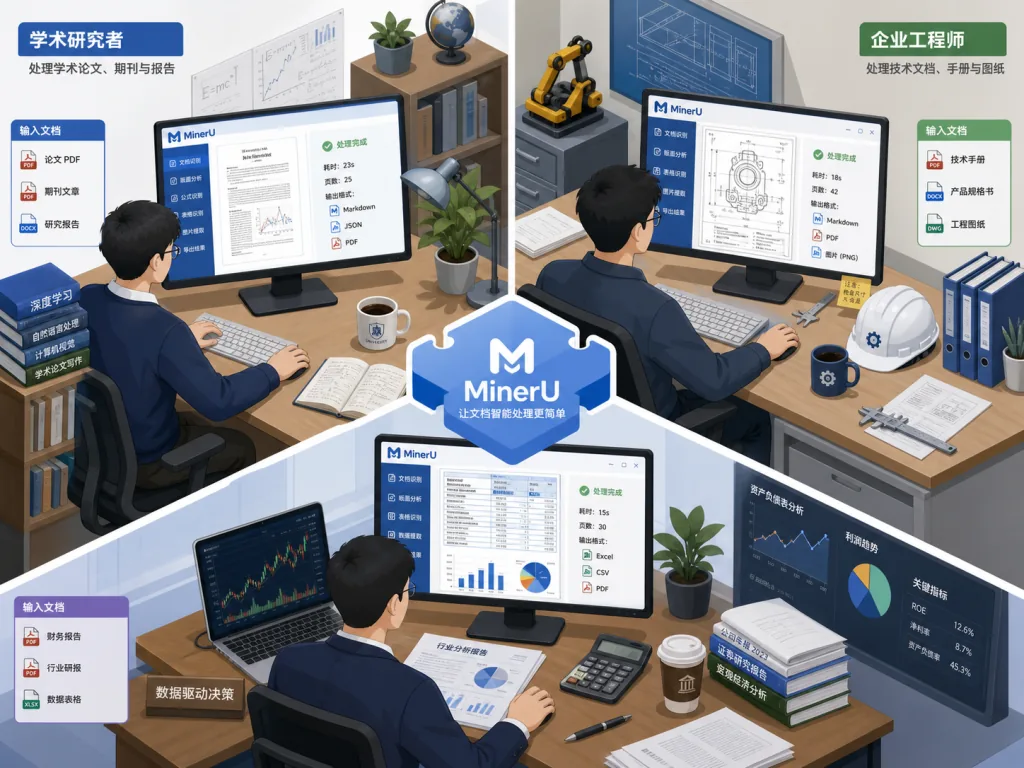
学术研究者:批量解析英文论文,提取公式与参考文献,构建个人文献库;大模型工程师:把企业 PDF 文档喂给 RAG 系统,提升检索召回率;金融分析师:自动抽取研报中的表格数据,告别手动录入;出版与古籍数字化团队:处理扫描书籍与非标准排版内容。不适合纯娱乐场景或对识别精度无要求的简单文本提取。
六、竞品对比
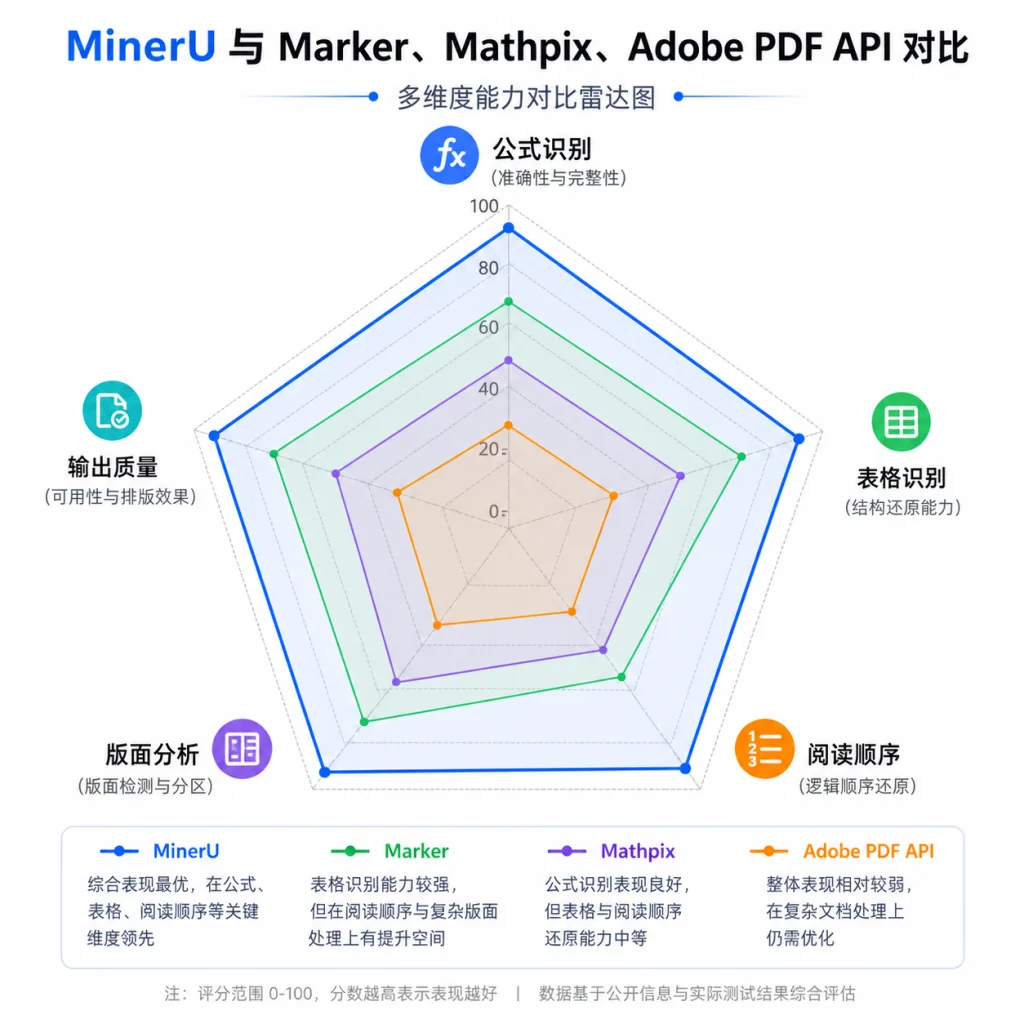
| 工具 | 公式识别 | 表格还原 | 阅读顺序 | 开源 | 中文支持 |
|---|---|---|---|---|---|
| MinerU | 强 | 强 | 优 | 是 | 优秀 |
| Marker | 中 | 中 | 良 | 是 | 一般 |
| Mathpix | 强 | 弱 | 中 | 否 | 一般 |
| Adobe PDF API | 弱 | 强 | 良 | 否 | 良好 |
相比 Marker,MinerU 在复杂版面与公式识别上更稳;相比付费的 Mathpix,它的全流程解析与中文支持都更胜一筹。
七、如何快速上手
环境要求:Python 3.10+、PyTorch 1.10+、推荐 Linux/macOS。
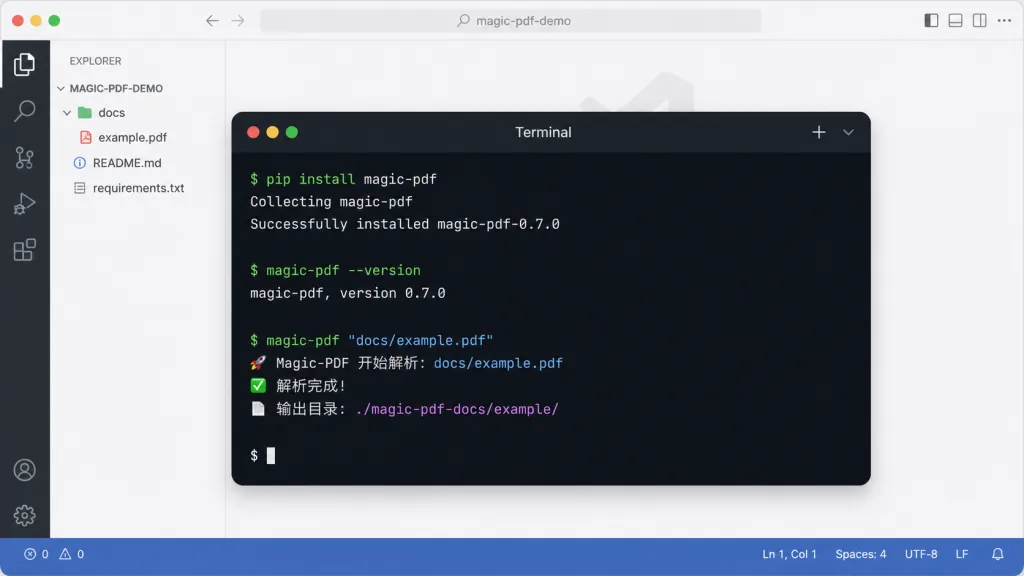
安装命令:
pip install magic-pdf[full]
最小可用示例:
magic-pdf pdf-command --pdf "你的文件.pdf" --inside_model true
输出默认在 /tmp/magic_pdf 目录,包含 Markdown 与布局 JSON。进阶使用可调用 Python SDK 自定义 pipeline,结合 pipeline_config.json 调整识别模型与输出格式。建议先用 5 页左右的样本测试参数,再批量处理大批量文档。
八、总结与行动建议
MinerU 把"PDF 转结构化数据"这件繁琐事做成了开箱即用的工具,无论是学术、企业知识库还是大模型训练,都能立竿见影地提升效率。建议先从你的高频文档类型(论文/合同/研报)入手,跑通小样本,再逐步接入生产环境。项目地址:github.com/opendatalab/MinerU,欢迎 Star 支持开源协作。文档解析的下一个十年,从结构化开始。