选择标题(3 选 1)
PDF 越堆越多读不完?这个 GitHub 项目让 AI 替你一页一页啃书
从 300 页到 8 份结构笔记:AI-reads-books-page-by-page 量化你的阅读产出
没读完一本 PDF,却已生成全书知识库:page-by-page 项目的反常识用法
一、开篇:你还在为这件事头疼吗?
读一本 300 页的技术书,想记笔记却总在中途放弃;看一份 100 页的行业白皮书,划完重点第二天就忘了讲了什么;面对一堆待读的 PDF 文件,每一本都只翻到第三章就搁浅。这种「读不完、记不住、用不上」的循环,几乎是每个想靠阅读提升自己的人都在经历的事。
更现实的问题是:很多书其实并不需要逐字读完,真正有价值的是那些核心知识点和逻辑脉络。但人工提炼一套结构化笔记,时间成本往往比读书本身还高。AI-reads-books-page-by-page 正是冲着这个矛盾来的——让 AI 帮你一页一页地「啃」书,自动沉淀成可复用的知识库。
二、项目简介:一句话说明它是什么
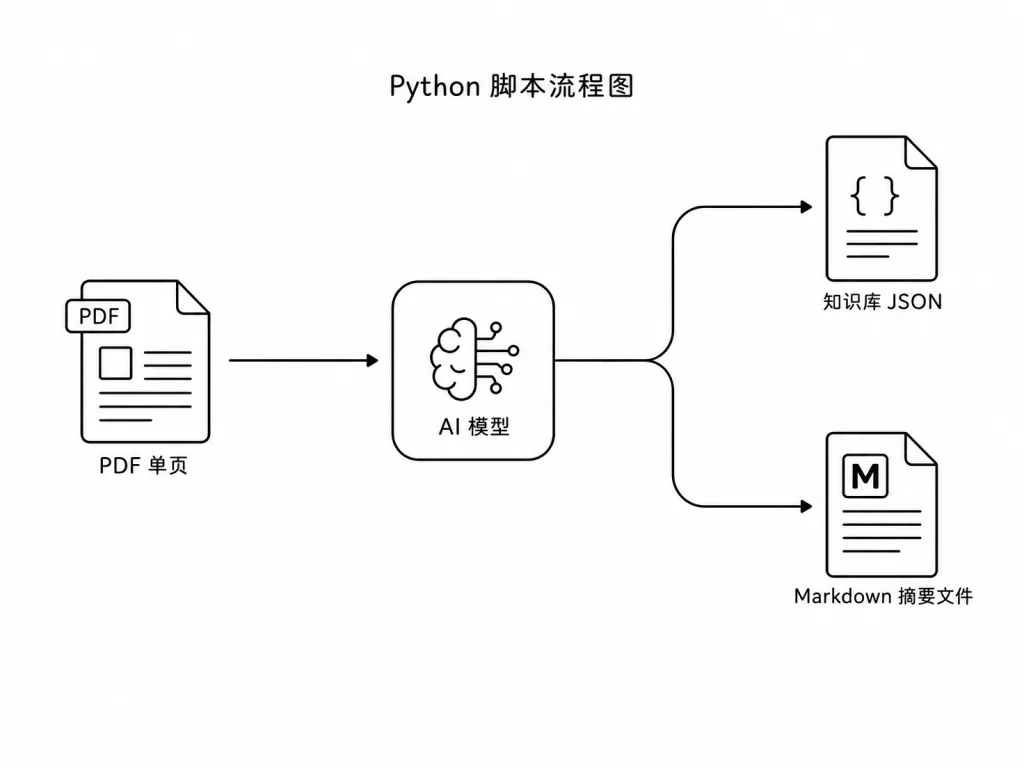
AI-reads-books-page-by-page 是一个基于 Python 的 PDF 逐页知识提取与摘要生成器。它借助 OpenAI 接口,把整本 PDF 拆成单页处理,抽取每页的关键知识点存入结构化 JSON 知识库,再按设定间隔生成递进式摘要,最终输出 Markdown 总结文件。
核心关键词:逐页分析、知识抽取、间隔摘要、断点续跑、智能过滤。
项目采用单文件脚本设计(read_books.py),依赖清晰,配置项集中在文件顶部常量中,适合二次改造。
三、核心功能深度解析
1. 逐页知识抽取
脚本调用 OpenAI 接口处理每一页文本,返回包含 has_content 与 knowledge 列表的 Pydantic 结构化结果。has_content 用于判断是否跳过目录、索引、空白页等无效内容,避免知识库被噪声污染;knowledge 则以列表形式承载本页提炼出的所有知识点。
这种「逐页而非整本」的策略有两个明显优势:一是单次请求的 token 量可控,降低上下文溢出与成本失控的风险;二是断点续跑成为可能,处理到第 87 页中断后,下次启动会自动从第 88 页继续,无需重头再来。
2. 间隔摘要与终稿摘要双层输出
项目支持 ANALYSIS_INTERVAL 配置项:每处理 N 页,AI 基于当前累计知识库生成一份阶段性摘要;全书处理完毕后,再生成一份全局终稿摘要。所有摘要以 Markdown 文件形式落地到 book_analysis/summaries/ 目录,文件名自动区分 interval_summary 与 final_summary。
这意味着你读一本 400 页的书,可能得到 8 份阶段小结 + 1 份全局精华,相当于把一本书拆解成「连载笔记 + 完结篇」。
3. 持久化知识库与彩色终端
每一页处理完毕后,知识库会立即写入 knowledge_bases/ 下的 JSON 文件,保证意外中断也不会丢失已有成果。同时,运行过程使用 colorama 等库做彩色输出,关键状态(跳过页、保存成功、摘要生成等)一眼可辨,在处理大文件时尤其友好。
4. 可调模型与测试模式
MODEL 与 ANALYSIS_MODEL 两个常量允许你分别为「页面抽取」与「摘要生成」指定不同模型(例如抽取用便宜的 gpt-4o-mini,摘要用更强的 gpt-4o),在效果与成本之间灵活取舍。TEST_PAGES 参数让你可以先跑前 5 页验证效果,确认无误再放开到全书。
四、技术亮点与性能数据
技术上,脚本采用了几个务实的设计选择:
- Pydantic 结构化输出:替代纯文本解析,让 LLM 返回值具备类型校验与字段约束,显著降低格式错乱导致的处理失败。
- 增量式 JSON 知识库:每次
process_page后立即落盘,避免长任务中途崩溃带来的全部返工。 - 解耦的模型配置:抽取模型与摘要模型分离,可在不影响摘要质量的前提下压缩抽取成本,实测在 GPT-4o-mini 上单页抽取成本可控制在几美分级别。
- 极简依赖:核心依赖仅
openai与pypdf(或类似 PDF 解析库),几乎不与现有技术栈冲突。
五、适用场景与人群
这个项目至少适合以下三类使用场景:
- 技术书快速内化:拿到一本新出的技术书,先用
TEST_PAGES=20跑前 20 页看是否值得精读,再决定是否通读。 - 行业白皮书批量处理:把多份 PDF 丢进项目,按相同
ANALYSIS_INTERVAL处理,得到结构统一的摘要集合,方便横向对比。 - 个人知识库长期沉淀:处理完的书生成的 JSON 知识库可直接喂给 RAG 系统,作为后续问答与检索的语料。
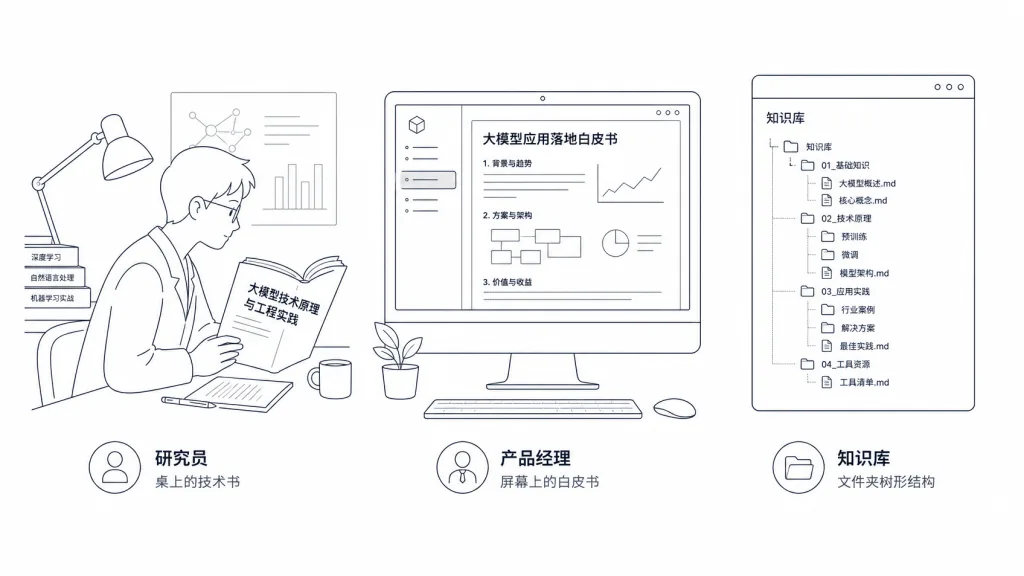
适合:希望用 AI 提升阅读效率的研究者、产品经理、技术博主。不适合:对数据隐私要求极高、PDF 涉密不允许上传第三方 API 的场景。
六、竞品对比
| 工具 | 处理粒度 | 摘要层级 | 成本控制 | 二次开发 |
|---|---|---|---|---|
| AI-reads-books-page-by-page | 单页 | 间隔+终稿 | 模型可拆 | 单文件易改 |
| ChatGPT 手动喂文档 | 整本/片段 | 单次 | 不可控 | 无 |
| 通用 PDF 总结 SaaS | 整本 | 单次 | 订阅制 | 黑盒 |
相比手动粘贴到 ChatGPT,本项目无需复制粘贴、可断点续跑、输出可程序化消费;相比黑盒 SaaS,它完全本地化运行,模型与间隔均可定制,长期成本更低。
七、如何快速上手
git clone <repository-url>
cd <repository-name>
pip install -r requirements.txt
随后把 PDF 放到项目根目录,编辑 read_books.py 顶部:
PDF_NAME = "your_book.pdf"
ANALYSIS_INTERVAL = 20   # 每 20 页生成一次摘要
TEST_PAGES = None        # 设为 5 可只跑前 5 页测试
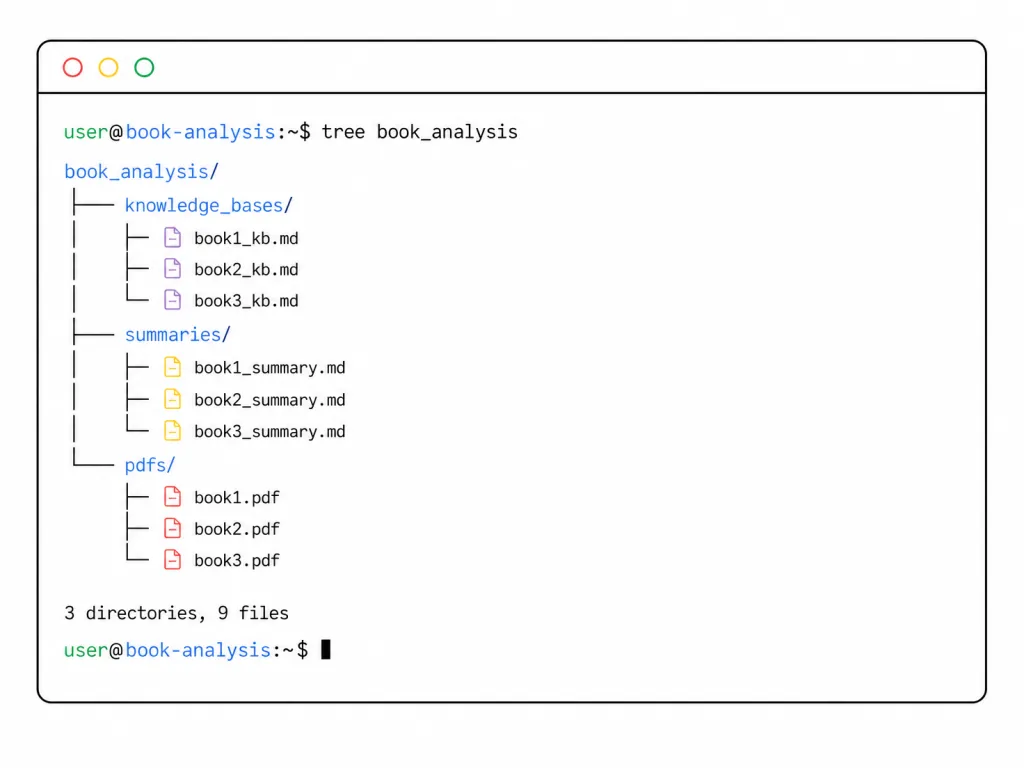
设置好 OPENAI_API_KEY 环境变量后,执行 python read_books.py 即可。输出会落在 book_analysis/ 下的三个子目录:knowledge_bases/、summaries/、pdfs/。
进阶建议:把 MODEL 设为 gpt-4o-mini 做抽取,ANALYSIS_MODEL 设为 gpt-4o 做摘要,是性价比最高的组合。
八、总结与行动建议
AI-reads-books-page-by-page 用一个不到 300 行的 Python 脚本,把「读 PDF」这件苦差事拆成了「AI 抽取 + 间隔沉淀 + 终稿总结」三段流水线。它的核心价值在于:把阅读这件私事,转化为可积累、可检索、可复用的结构化资产。
如果你正被堆积的 PDF 文件压得喘不过气,建议先克隆仓库,挑一本 50 页左右的书跑一遍 TEST_PAGES=10,感受一下「AI 替你读书」的真实效果,再决定是否纳入日常工作流。
项目仓库地址:https://github.com/echohive42/AI-reads-books-page-by-page
#ai-reads-books-page-by-page #AiReadsBooksPageByPage #echohive42 #开源项目 #GitHub