选择标题(3 选 1)
做公众号还在手动抄排版?这个工具一键把别人的版式拆成模板
扔个公众号链接进去,5 分钟拿到一份可复用的富文本模板
没装任何设计软件,他靠 154 Star 的开源工具复制了爆款排版
一、开篇:做公众号,光是抄个排版就能熬到半夜
做公众号的人都知道,最痛苦的不是写稿,而是「对版式」。看到一篇阅读量爆炸的文章想研究它的视觉风格,手动复制到编辑器后,标题字号变了、行间距塌了、配色全丢、卡片背景图变灰……好不容易敲定一个模板,下一篇又得重来一遍。
样式提取这个需求,零散工具要么只能截屏分析颜色、无法复用排版结构,要么干脆只给个「样式参考」,照样要你手动一点点还原。一款能把「别人的排版」一键拆成「自己可编辑模板」的工具,长期缺位。
样格(WeChat Style Extractor)瞄准的就是这个缺口:直接把公众号链接丢进去,自动吐出可视化参数和可粘贴的富文本。
二、项目简介:把链接变成排版参数表
样格是一款基于 TypeScript 开发的公众号样式提取工具,目标是把「看中的排版」从一篇现成公众号文章里完整提取出来,并交付一个能在浏览器中预览、直接复制到微信编辑器使用的富文本模板。
核心关键词四个:链接解析、样式归一化、富文本复制、手机端预览。当前 GitHub 仓库 154 Stars,需要 Node.js 22.13+ 即可本地启动。
三、核心功能深度解析
1. 全自动样式抓取与统计
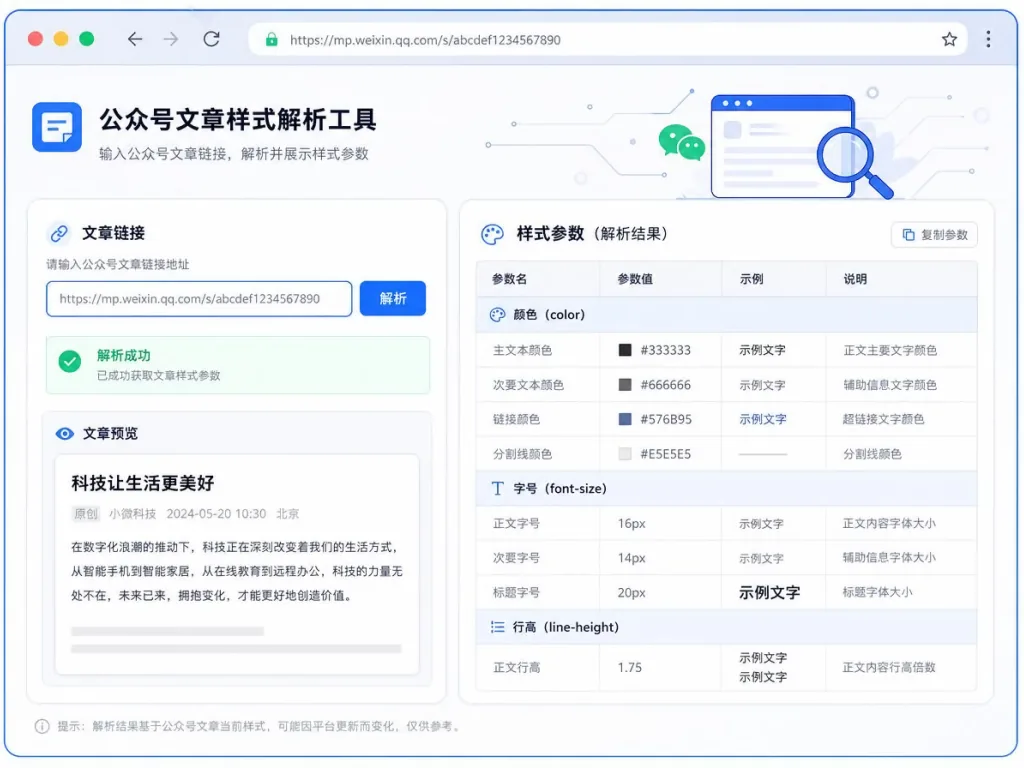
样格的服务端抓取流程只对 https://mp.weixin.qq.com 域名生效,并限制跳转域名、响应体积与读取时间。拿到 HTML 后进入清洗与样式归一化阶段,启发式识别标题层级、正文颜色、字号、行高、内外边距等视觉参数,把内联样式和 <style> 表单统一处理,保留网格、定位、阴影、列表、表格等关键排版指令。
未识别到的字段不会强行填默认值,而是直接不显示,避免对作者造成误导。
2. 富文本一键复制到公众号编辑器
样式参数提取完成后,页面会生成一份「富文本版本」,支持一键复制到公众号后台编辑器。这个过程保留了原始文章中的正文图片、懒加载图片,以及卡片中的 CSS 背景图。配合自动内联样式表,确保复制后不会立刻出现「样式丢失」。
注意:因为公众号编辑器自身的限制,内联样式有时会被部分剥离。样格给出的预览会尽量还原原始排版,给作者一个准确的预期。
3. 手机端公众号阅读器预览
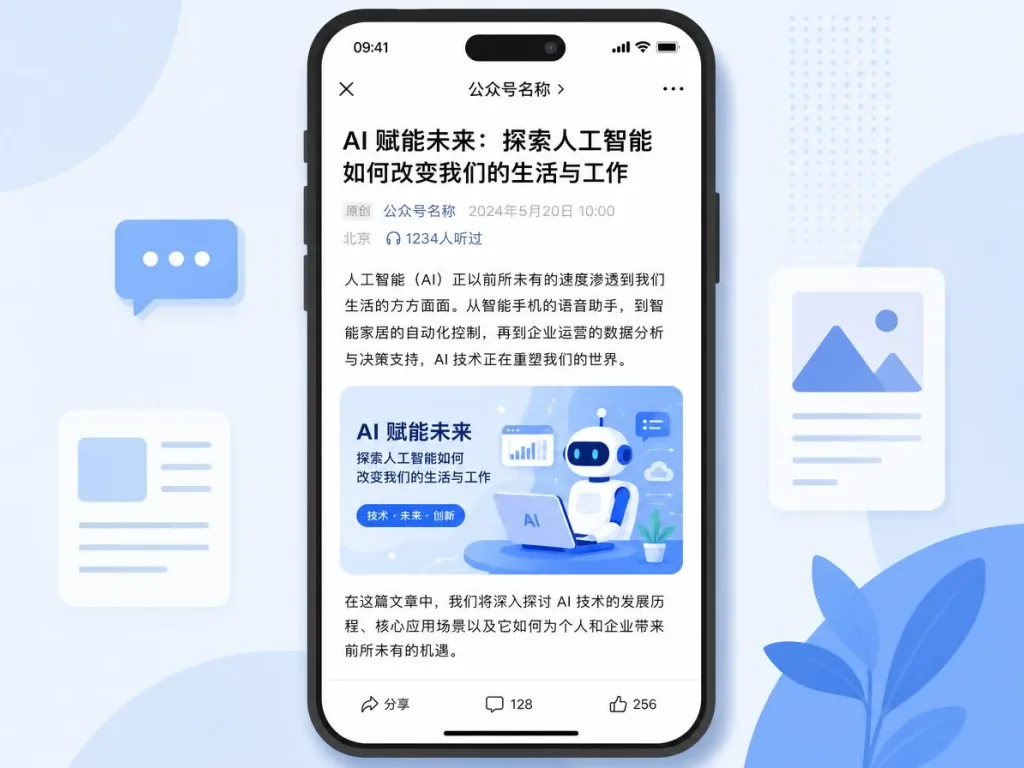
工具内置一个手机端公众号文章预览窗口,样式参数、卡片组件、图文混排全部按移动端真实呈现。再也不用在手机和电脑之间来回切换测试字号行高。
4. 安全边界与失败提示
出于安全考虑,解析接口固定访问公众号官方域名,并对响应大小、读取时间做了硬性限制。微信偶尔对服务器访问触发安全验证页时,工具会主动提示「请稍后重试」,而不是无声地返回空数据。这种「明确失败」的设计对内容运营来说非常友好。
四、技术亮点与性能数据
- 类型安全:TypeScript 全量开发,搭配单元测试(
npm test),重构友好。 - 构建链路:提供
npm run dev开发模式与npm run build生产构建,对前端贡献者门槛极低。 - 托管与源码解耦:GitHub 源码仓库与体验站托管仓库相互独立,每次发版都会在
main上创建backup/pre-upgrade-<date>标签,确保可回滚。 - 样式归一化算法:不依赖「截图 + OCR」这种重方案,而是基于 HTML 与 CSS 直接解析,保留网格、定位、阴影等高保真信息。
五、适用场景与人群
- 公众号内容运营:追热点时要快速复用其他账号的视觉模板,又不想每次手动抠样式。
- 新媒体编辑团队:做品牌矩阵时希望统一视觉语言,把样板文章「扒下来」做内部排版规范。
- 自媒体创作者:研究爆款文章配色、字号节奏,用数据化方式建立自己的风格库。
不适合:希望 100% 像素级还原原文章视觉的人——公众号编辑器本身会对部分内联样式做二次过滤,工具能给出高保真预览,但无法绕过编辑器自身的渲染策略。
六、竞品对比
| 维度 | 样格 | 通用样式嗅探工具 | 截图类参考工具 |
|---|---|---|---|
| 输入方式 | 公众号链接直传 | 任意网页 HTML | 仅截图 |
| 输出形式 | 可复制富文本 + 参数表 | 样式表片段 | 静态图片 |
| 原图/卡片背景保留 | 支持 | 一般不支持 | 不支持 |
| 移动端预览 | 内置 | 通常无 | 无 |
| 失败提示 | 明确 | 静默失败 | 不适用 |
样格把「解析 + 预览 + 复制」三段流程整合到单页工具里,对公众号场景的适配度高于通用方案。
七、如何快速上手
环境要求:Node.js 22.13 或更高版本。
git clone <repo>
npm install
npm run dev
启动后访问本地端口,输入一个公开公众号文章链接即可进入解析流程。进阶建议:搭配版本标签 backup/pre-upgrade-<date> 做体验站回滚演练,避免发版后无法降级。
八、总结与行动建议
样格把「扒样式」这件内容运营的脏活累活,做成了一个有明确输入、明确输出、明确边界的可复用工具。它对公众号链接场景做了深度优化,从抓取、清洗、归一化到富文本复制,每一步都有取舍说明,不会为了「看起来很强」而隐瞒局限性。
建议:先拿一篇你日常阅读量稳定的爆款文章测试,观察工具识别的标题字号、行间距、配色是不是符合肉眼判断,再把它纳入团队的排版工作流。
体验地址:https://wechat-style-extractor.godkey810.chatgpt.site/ GitHub 仓库:sennkuwu/wechat-style-extractor
下次想「抄」别人的排版时,先让样格帮你跑一遍——你喝杯咖啡的工夫,模板已经躺在剪贴板里了。
#wechat-style-extractor #WechatStyleExtractor #sennkuwu #大模型 #LLM #RAG #开源项目 #GitHub