一、开篇:如果有个工具能替你做完这一步…
做短视频搬运或者二创的朋友,几乎都卡在同一个环节:拿到一段英文/日文视频,听不懂、没法配字幕、找人配音又贵。于是大多数人只能放弃海外选题,眼睁睁看着流量溜走。也有人硬着头皮上 Whisper 跑识别、再丢进翻译接口、切到剪辑软件一条条对齐字幕、配音单独找 TTS 网站导出音频、最后用 FFmpeg 命令合成——光是记住那一长串参数就把人劝退。
更现实的问题是:每换一段素材,就要把这套流程跑一遍,单条 10 分钟视频折腾两小时是常态。pyVideoTrans 这个在 GitHub 上拿下超过 18.6k Stars 的开源项目,正是冲着这条"流水线"来的。
二、项目简介:用一句话概括
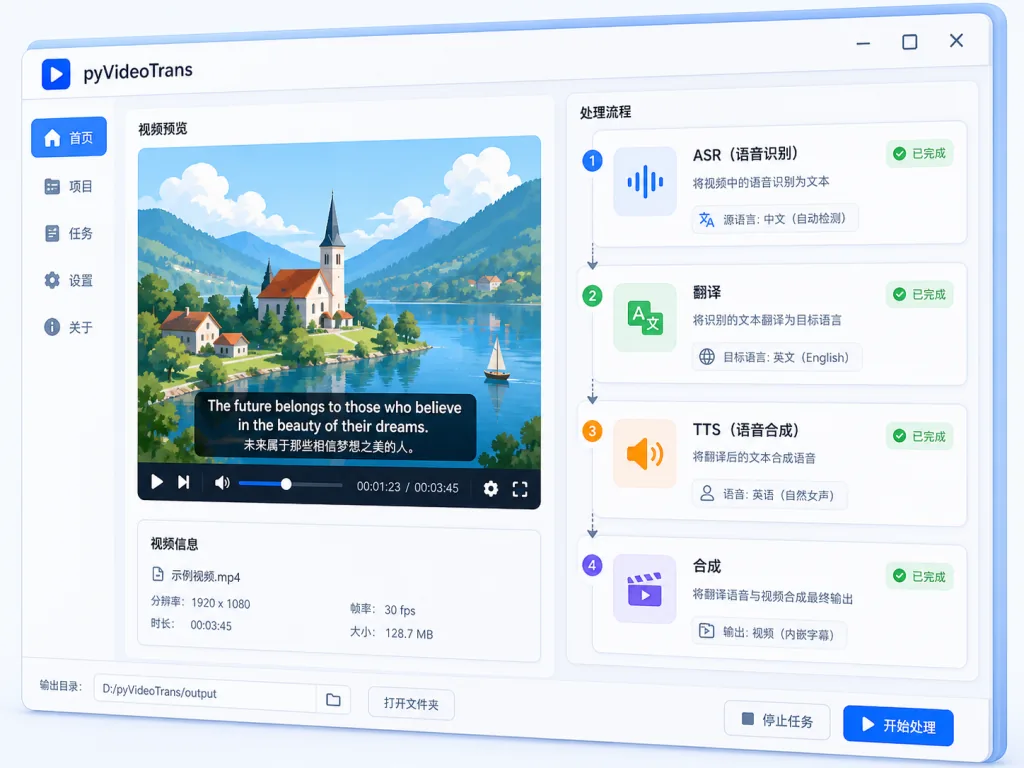
pyVideoTrans 是一款一键式 AI 视频翻译 + 配音 + 字幕生成工具,把"语音识别 → 字幕翻译 → AI 配音 → 字幕烧录 → 音画合成"串成一条流水线,支持本地离线部署和主流在线 API 双模式。它覆盖 Windows / macOS / Linux 三平台,GitHub Stars 18.6k+,主仓库为 jianchang512/pyvideotrans。
三、核心功能深度解析
1. 全自动视频翻译流水线
这是 pyVideoTrans 的主路径:导入视频后,按 ASR → LLM 翻译 → TTS 配音 → FFmpeg 合成的顺序自动推进,每一步都可以暂停并手动校对。支持 Faster-Whisper、WhisperX、阿里 Qwen3-ASR、字节火山等识别通道,翻译侧可接 DeepSeek、ChatGPT、Claude、Gemini、MiniMax 等大模型,配音侧默认走免费的 Edge-TTS,也能上 F5-TTS、CosyVoice、GPT-SoVITS 实现零样本声音克隆。
2. 多角色 AI 配音与声纹克隆
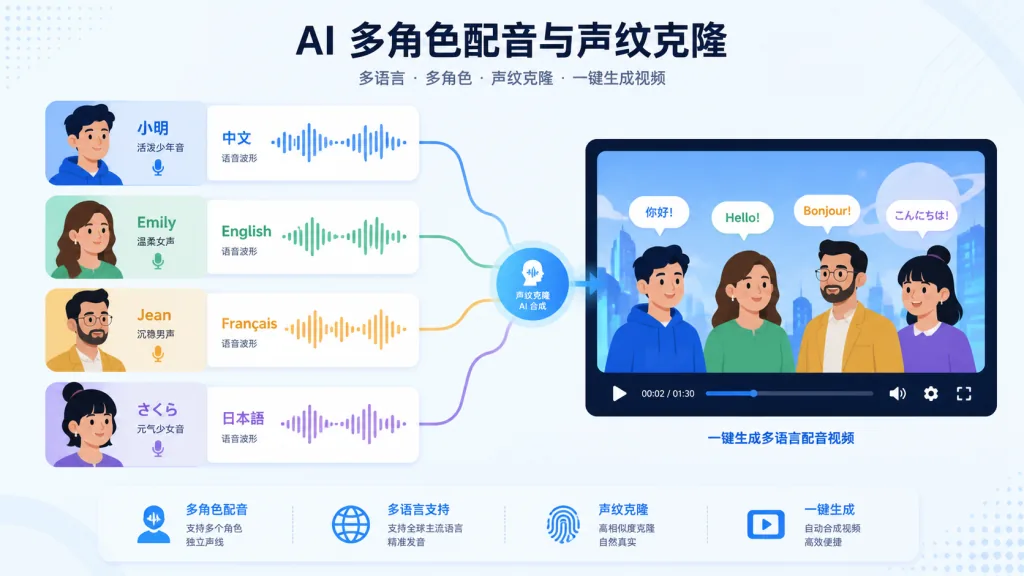
借助说话人分离(Speaker Diarization)功能,系统能识别"主持人""嘉宾""旁白"三个角色,并为每个角色分配不同的 TTS 音色。如果想完全复刻某个人的声线,可以挂载 F5-TTS、CosyVoice、GPT-SoVITS 这类本地模型跑 5–10 秒参考音频做 zero-shot 克隆。
3. 字幕相关工具箱
除了主流程,pyVideoTrans 还提供字幕翻译、字幕与音轨对齐、批量 SRT 生成、人声分离、字幕与音视频合并等小工具,相当于把字幕处理这条线吃透了——翻译人员可以直接拿 SRT 文件喂给翻译通道生成目标语言版本,再回灌回项目。
4. 三种运行形态:GUI / CLI / WebUI
- GUI:直接
uv run sp.py,可视化界面适合日常使用; - CLI:
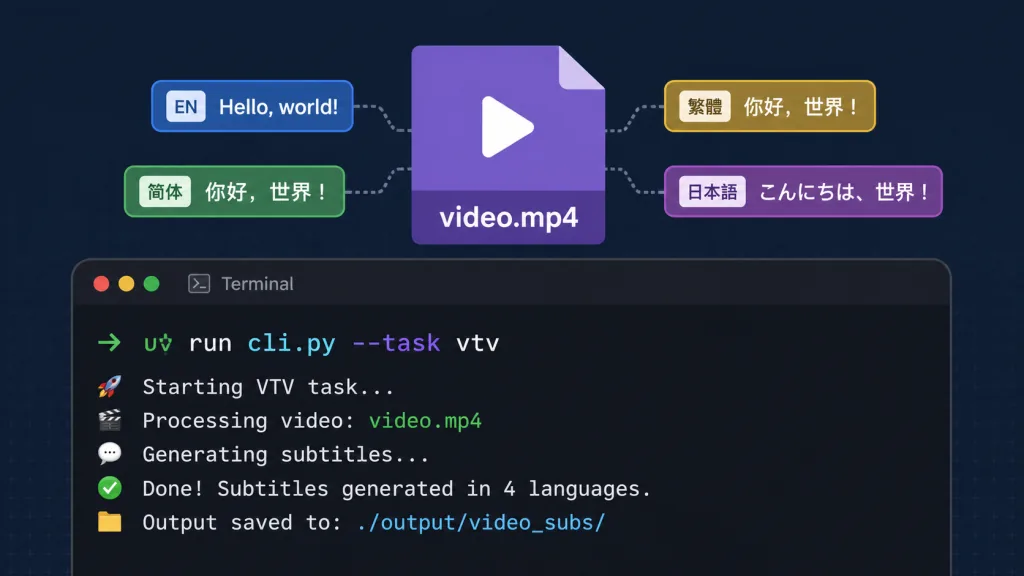
uv run cli.py --task vtv ...,可对接服务器批处理; - WebUI:
uv run webui.py后浏览器访问 7860 端口,适合内网远程协作或统一部署; - Docker:官方镜像直接
docker run,数据卷挂载也支持。
四、技术亮点与性能数据
- 识别效率:Faster-Whisper large-v3 在普通消费级显卡上即可跑出接近实时的 1.0x–1.5x 转写速度,长视频批量处理不卡顿;
- 翻译质量:默认走 DeepSeek / ChatGPT 这类支持上下文的大模型,相比 Google 传统机器翻译,断句更自然、术语更一致;
- 配音通道:Edge-TTS 走微软免费接口,零成本即可拿到接近真人的中文/英文/日文/韩文发音;
- 架构解耦:ASR、翻译、TTS 三层独立,每个环节都能独立替换为本地模型或第三方 API,方便按预算组合;
- 生态兼容:Python 3.10+,底层依赖 FFmpeg、PySide6、sherpa-onnx、Gradio 等成熟组件,二次开发门槛低;
- GPU 加速:可选 CUDA 12.8 + cuDNN 9.11,配合
uv add torch==2.7 --index-url https://download.pytorch.org/whl/cu128一行切换 GPU 版 PyTorch。
五、适用场景与人群
适合谁
- 短视频二创 / 搬运团队:把英文 YouTube、TikTok、播客自动转成中文配音 + 双语字幕,产能直接翻倍;
- 跨境电商运营:产品讲解视频批量翻译成多语言版本,降低外投放成本;
- 在线教育 / 字幕组:把公开课、纪录片转写为 SRT 字幕,再走 LLM 做精修;
- 企业内训部署:通过 WebUI + Docker 在内网部署,统一出片。
不适合谁
需要电影级别的精细对齐、角色口型同步,或者对生成内容有商业合规强约束的场景,建议直接使用专业达芬奇/PR 工作流,pyVideoTrans 更适合"批量产出可用版本"。
六、竞品对比
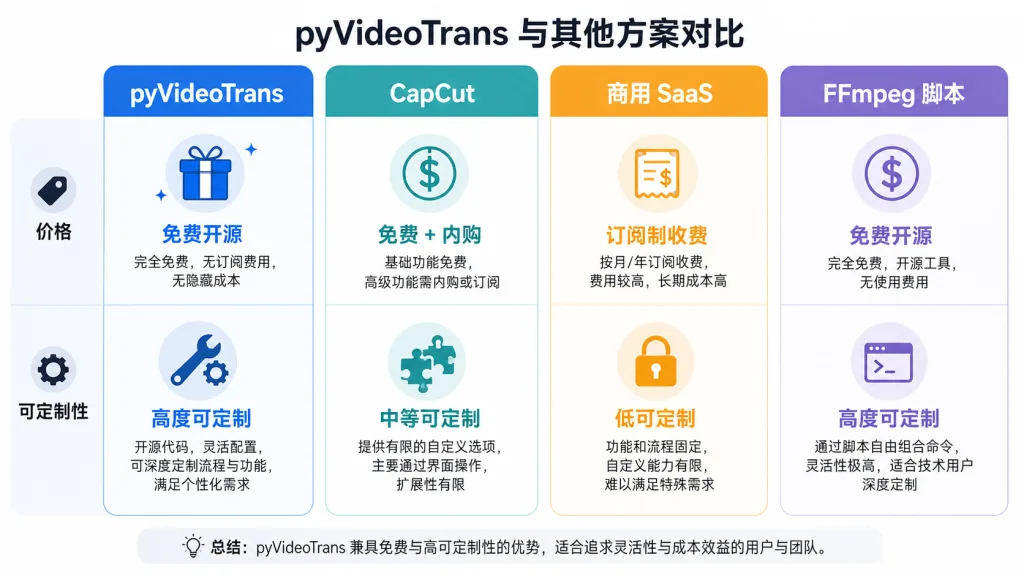
| 维度 | pyVideoTrans | 剪映国际版(CapCut) | Heygen / 商用 SaaS | 自己拼 FFmpeg 脚本 |
|---|---|---|---|---|
| 价格 | 完全开源免费 | 限免/会员制 | 按分钟计费 | 免费但耗时 |
| 模型替换 | ASR / 翻译 / TTS 均可热插拔 | 封闭 | 封闭 | 自由但要自己写 |
| 离线能力 | 支持(Ollama + faster-whisper) | 弱 | 几乎无 | 完全可控 |
| 批量/CLI | 原生支持 | 弱 | 弱 | 自己写 |
| 声音克隆 | F5-TTS / CosyVoice / GPT-SoVITS | 不支持 | 支持但收费 | 看自己 |
一句话总结:要批量、要可定制、要开源,pyVideoTrans 是当前性价比最高的选择;要极简、不想折腾,可以先用 CapCut 应急;预算充足又要做数字人,则另当别论。
七、如何快速上手
Windows 用户(零配置)
- 到 Releases 页面 下载最新压缩包;
- 解压到不含中文和空格的路径(例如
D:\pyVideoTrans); - 双击运行
sp.exe,GUI 直接开箱即用。
macOS / Linux 开发者
# 安装 Python 3.10 与 FFmpeg 后:
curl -LsSf https://astral.sh/uv/install.sh | sh
git clone https://github.com/jianchang512/pyvideotrans.git
cd pyvideotrans
uv sync --all-extras
uv run sp.py
CLI 批处理示例
uv run cli.py --task vtv --name "./video.mp4" \
  --source_language_code zh-cn --target_language_code en \
  --voice_role "en-US-GuyNeural"
进阶建议
- 想完全离线:把 ASR 切到 Faster-Whisper,翻译切到 Ollama + Qwen2.5,TTS 切到 Edge-TTS / ChatTTS;
- 想内置 GPU 加速:按官方文档卸载 CPU 版 PyTorch,装 CUDA 12.x 对应版本;
- 想对外提供服务:直接
docker run -d -p 7860:7860 pyvideotrans-webui,挂载数据卷持久化配置和产出。
八、总结与行动建议
pyVideoTrans 用一条开源流水线,把"跨语言视频本地化"这件事的工具门槛打到了几乎为零。18.6k+ Stars、覆盖三大平台、支持本地 + 在线双模式,对个人创作者和企业团队都很能打。
推荐路径:先到 Releases 拿 Windows 预打包版快速体验;如果你是开发者,走 uv sync --all-extras 拉一份源码自己魔改;如果想团队协作,WebUI + Docker 一套就够。要踩坑或者看教程,官方文档 pyvideotrans.com 和社区 bbs.pyvideotrans.com 都准备好了。开源世界又多了一个值得 Star 的项目,现在就去仓库点个 ★ 把它加入你的工具箱吧。