选择标题(3 选 1)
多语种 TTS 选型踩坑无数?这个 0.5B 的 CosyVoice 3 把我治好了
CosyVoice 3 把 9 种语言、18+ 方言、流式 150ms 延迟塞进 0.5B 模型
0.5B 体量干翻 1.5B 对手:CosyVoice 3 凭啥在硬样本榜上封神
一、开篇:这个痛点,几乎每个开发者都踩过
做语音合成的人,多半都经历过这种崩溃:模型跑起来了,但合成出来的中文听着像机器念稿,英语又变成了「chinglish」;想做方言支持,结果只覆盖普通话;想做流式输出,延迟动不动 500ms 起步,对话场景根本没法用。市面上开源 TTS 一抓一大把,真要拿进生产环境,坑一个接一个。
最近一次需求里,我们的目标很明确:500MB 以内的模型、支持中日韩英德等 9 种语言、18+ 方言、流式延迟压到 150ms 附近,还要能零样本克隆音色。横向对比一圈后,CosyVoice 3(Fun-CosyVoice3-0.5B-2512)几乎是为这个清单量身定做的。
二、一句话看懂:这是个什么项目
CosyVoice 是 FunAudioLLM 团队开源的基于大语言模型的 TTS 工具箱,2024 年首发 CosyVoice 1.0,2024 年底迭代到 2.0,2025 年 5 月发布 CosyVoice 3(论文 arXiv:2505.17589)。最新版本主打「in-the-wild 语音生成」,覆盖 9 种主流语言与 18+ 中文方言,仅 0.5B 参数量,在 test-hard 集上 CER 5.44%、SS 75.0%,优于多数 1.5B 量级对手。
三、核心功能深度解析
1. 多语言 + 方言混合零样本克隆
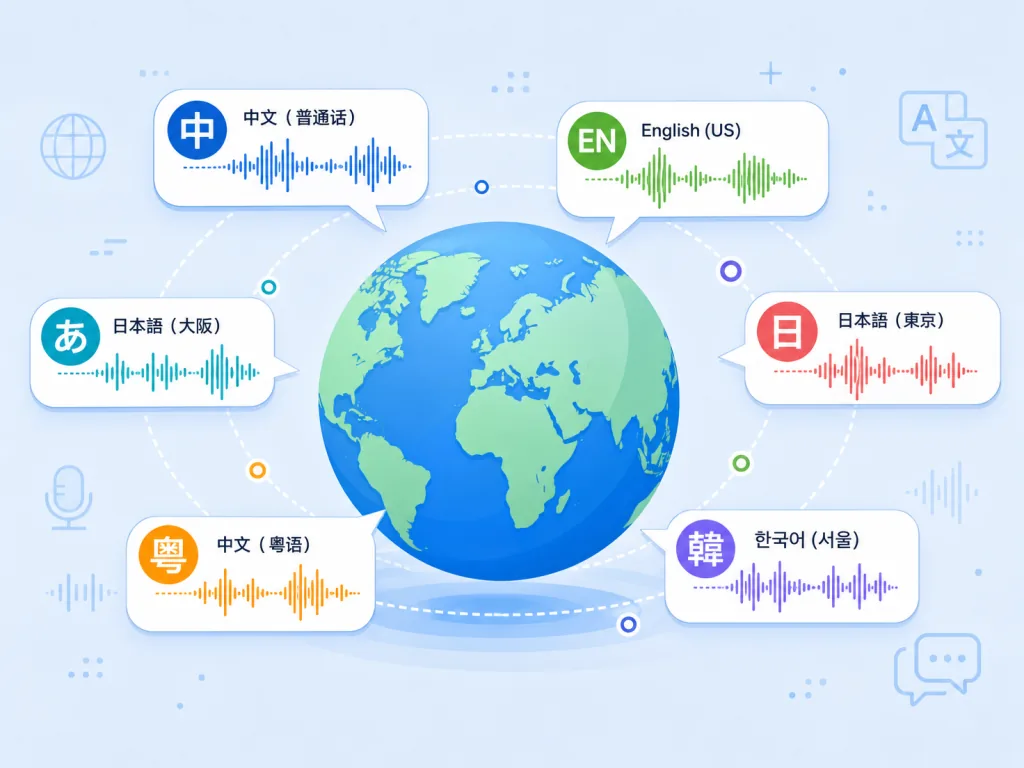
CosyVoice 3 一次性覆盖中、英、日、韩、德、西、法、意、俄 9 种语言,并支持粤语、闽南语、四川话、东北话、陕西话、上海话、天津话、山东话等 18+ 中文方言。借助跨语言零样本音色克隆,一段 10 秒参考音频就能复刻音色,再换一段完全不同语言的文本照样能「说」出来。这对做多语种客服、有声内容本地化的团队非常关键——以前要训练多个单语模型,现在一个模型全搞定。
2. 发音纠正与可控生产
传统 TTS 遇到生僻字、专有名词、多音字几乎必翻车。CosyVoice 3 提供中文拼音和英文 CMU 音素级别的「发音修补」接口,直接指定读音就能精准合成,再也不用反复调前端文本归一化逻辑。配合内置的文本归一化模块,数字、符号、日期、金额都能按自然口语朗读,省掉大量规则开发。
3. 双流式推理与超低延迟
针对实时对话场景,CosyVoice 3 同时支持「文本流式输入」和「音频流式输出」,端到端最低延迟 150ms。配合 Repetition Aware Sampling(RAS)采样策略和 KV cache 优化,长文本合成也不会出现「复读机」现象。vLLM 0.11.x+ 和 TensorRT-LLM 两条加速路径都已经打通,TRT-LLM 比 HuggingFace Transformers 实测快约 4 倍。
4. 自然语言指令控制
直接用自然语言就能控制合成风格,例如「用四川话说」「语速快一点」「开心一点」「声音大一些」,不需要重新训练模型。这让产品经理和运营也能参与调音,省去大量标注和微调工作。
四、技术亮点与性能数据
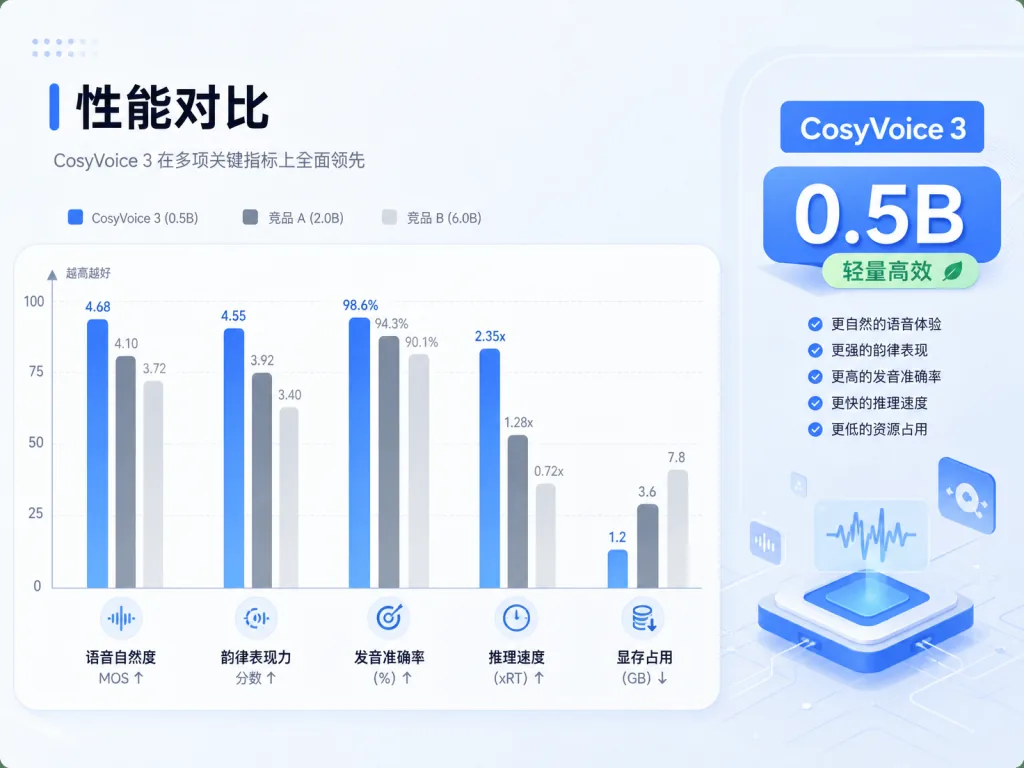
从 README 给出的 test-hard 榜单看,0.5B 的 Fun-CosyVoice3-2512_RL 把 CER 压到 5.44%、SS 75.0%,反超 1.5B 的 Index-TTS2、3B 的 HiggsAudio-v2,与商用闭源模型 Seed-TTS(SS 77.6%)的差距已经非常小。中文 test-zh 集 CER 0.81%,甚至低于人类基线 1.26%。在轻量模型里,这个成绩属于头部水准。
架构上,它延续「LLM 预测语义 token + Flow Matching 声学解码」的路线,并叠加 GRPO 强化学习后训练,工程链路包括 vLLM/TRT-LLM 推理、FastAPI/gRPC 服务化、Docker 一键部署,对生产环境相当友好。
五、适用场景与人群
具体来看三类典型场景:
- 多语种语音产品:跨境电商语音客服、多语种有声书、海外 App 语音播报,一个模型覆盖多语言。
- 方言与个性化内容:方言新闻播报、IP 角色复刻、播客自动配音,零样本克隆 + 指令控制大幅压缩制作周期。
- 实时对话与人形机器人:流式 TTS + 低延迟,适合数字人、智能座舱、陪伴机器人等需要「边说边听」的场景。
适合做 TTS 中间层、AI 语音产品、对话系统、多语种本地化的团队。纯学术研究、模型参数量要求宽松、或者只跑离线长音频合成的场景,可能更倾向 1.5B 以上大模型。
六、竞品对比
| 模型 | 开源 | 参数量 | test-hard CER ↓ | test-hard SS ↑ | 亮点 |
|---|---|---|---|---|---|
| Fun-CosyVoice3-2512_RL | ✅ | 0.5B | 5.44% | 75.0 | 多语言+方言、150ms 流式、RL 后训练 |
| CosyVoice2 | ✅ | 0.5B | 6.83% | 72.4 | 上一代基线 |
| F5-TTS | ✅ | 0.3B | 8.67% | 71.3 | 体量小,但硬样本差 |
| Index-TTS2 | ✅ | 1.5B | 7.12% | 75.5 | 大模型、效果接近 |
| VoxCPM | ✅ | 0.5B | 8.87% | 73.0 | 轻量,硬样本略弱 |
| Seed-TTS | ❌ | - | 7.59% | 77.6 | 闭源商用标杆 |
CosyVoice 3 的核心优势在于「0.5B 体量 + 顶级硬样本表现 + 方言覆盖 + 流式推理」四合一,对资源受限但又要求高质量的工程团队非常友好。
七、如何快速上手
-
克隆与安装
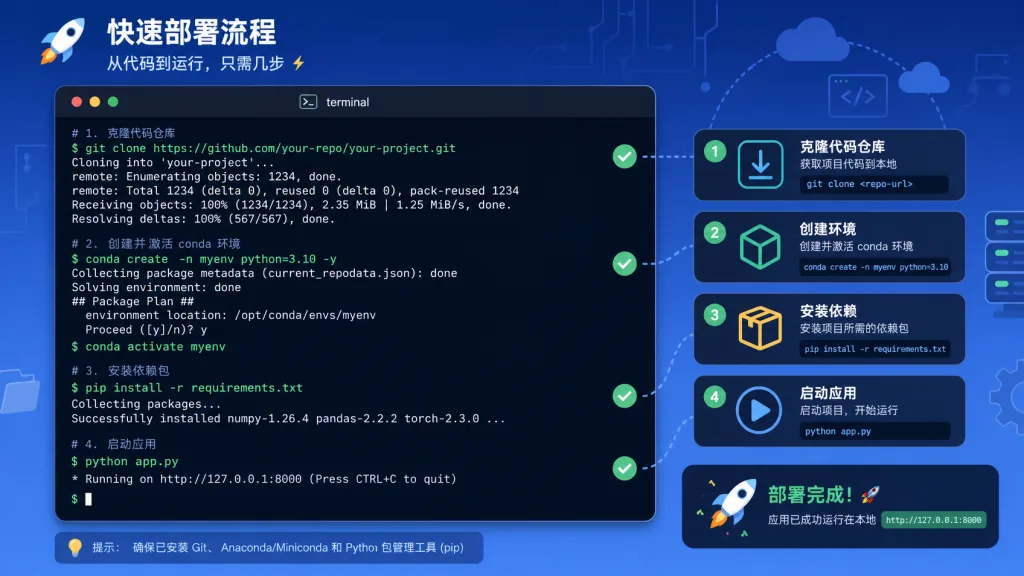
git clone --recursive https://github.com/FunAudioLLM/CosyVoice.git cd CosyVoice conda create -n cosyvoice -y python=3.10 conda activate cosyvoice pip install -r requirements.txt -
下载预训练模型(以 Fun-CosyVoice3 为例):
from modelscope import snapshot_download
snapshot_download('FunAudioLLM/Fun-CosyVoice3-0.5B-2512', local_dir='pretrained_models/Fun-CosyVoice3-0.5B')
海外用户用
huggingface_hub同样能拉。 -
跑基础示例:执行
python example.py即可体验 SFT、零样本、跨语言、指令控制四种模式。 -
进阶:想要流式低延迟,装 vLLM 0.11.0+ 后跑
vllm_example.py;想要服务化部署,runtime/python下提供了 FastAPI/gRPC Docker 镜像;极致性能可上 Triton + TensorRT-LLM,docker compose up -d一键启动。
八、总结与行动建议
CosyVoice 3 用 0.5B 的参数量,把多语言、方言、流式、可控四个生产级需求一次性打包交付,test-hard 上的硬指标甚至超过了多数 1.5B 竞品,对想自建语音能力的团队是当下性价比很高的选择。
如果你正在做多语种客服、方言播报或数字人对话,建议优先尝试 Fun-CosyVoice3-0.5B-2512_RL,先用 example.py 验证效果,再走 vLLM 或 TensorRT-LLM 路线部署到生产。
相关链接:
- GitHub:https://github.com/FunAudioLLM/CosyVoice
- 论文:https://arxiv.org/pdf/2505.17589
- Demo:https://funaudiollm.github.io/cosyvoice3/
- ModelScope / HuggingFace 模型页均有官方权重可下载。
#cosyvoice #Cosyvoice #qwenaudio #语音合成 #语音识别 #开源项目 #GitHub