选择标题(3 选 1)
video-talkcraft:口播视频还在 PPT 翻页?这个 skill 让 Claude Code 替你拍
video-talkcraft 上手:改一个镜头只需 53 秒,108 张动效卡任 agent 调度
没写一行剪辑脚本,AI 把口播稿做成了字级同步的解说片
video-talkcraft:把 Claude Code 变成你的口播视频动效工作室
一、开篇:如果写脚本也算做视频,那谁在拍片?
写完一份 100 秒的口播稿,录好配音,丢给剪辑软件——结果还是三件事:卡时间轴、做花字、找动效模板。这三件事消耗的不是创意,是耐心。你想做的不是「会动」,是「字落哪就动哪」。
更要命的是另一件事:用现成模板拼出来的口播片,一眼就是「PPT 翻页」。每张卡静止两秒以上、镜头一动不动、人物与字幕互不避让,观众的注意力在第 15 秒就散了。问题是,PPT 翻页式的卡顿不是审美问题,是结构问题——只要相机没在推拉、转场没在承接,静止帧就在结构上必然出现。
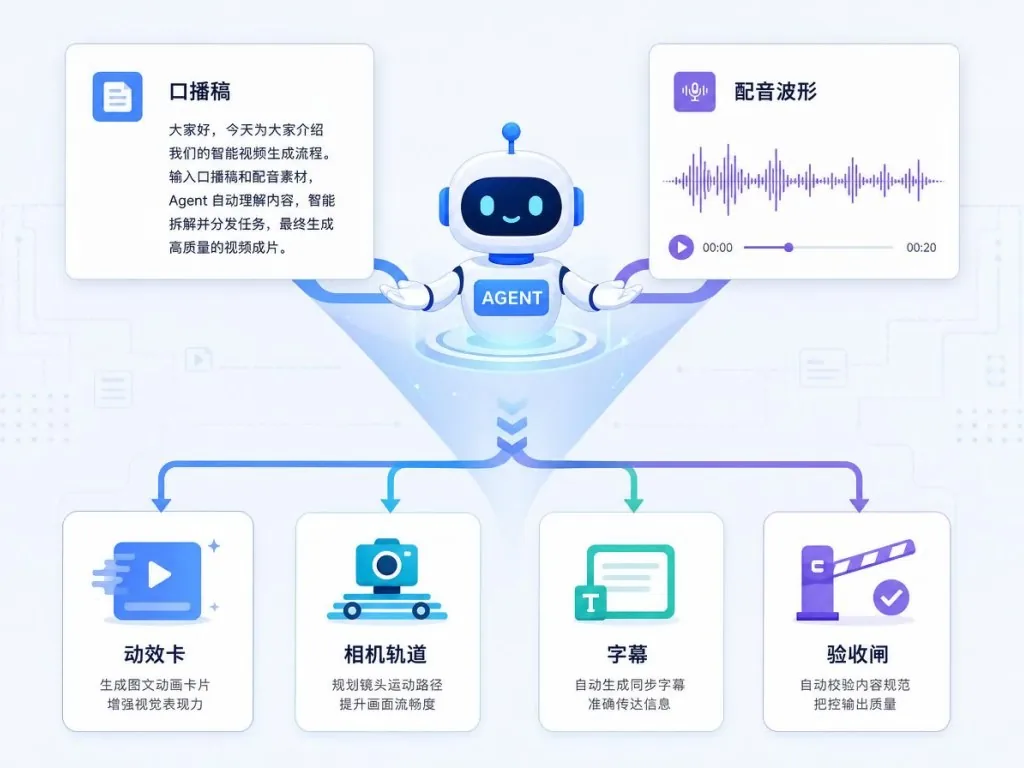
video-talkcraft 想做的事很直接:让 AI agent 读完你的口播稿和成品配音,自己把动效、运镜、字幕、验收全做完——而且每一拍都锁在确切的字上。
二、项目定位:它解决的是什么问题
video-talkcraft 是一个开源的 AI agent skill,把 Claude Code 或 Codex 变成口播视频动效工作室。它的核心能力有四个:
- 字级配音同步:把口播稿对齐到音频,每个动效节拍锚在确切的字上;
- 108 张动效配方卡:每张卡都有意图、参数、已知坑和自包含的 Remotion 源码;
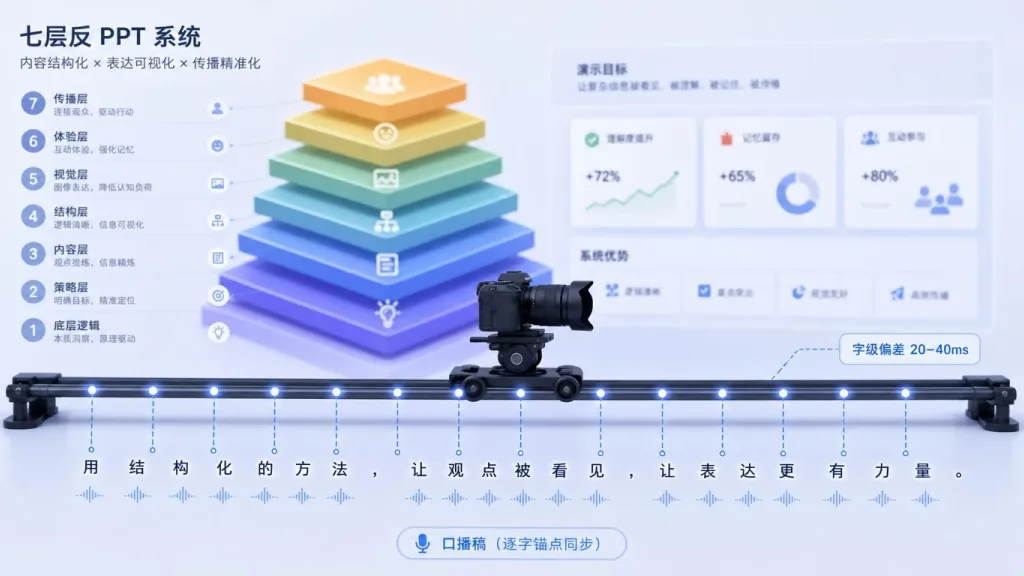
- 七层反 PPT 镜头系统:让「静止帧」在结构上不可能出现;
- 三重验收:画面健康双判定、纯音效轨能量验证、带动效锚点帧的独立评审。
项目当前 1459 Stars,主语言 HTML(动效配方卡的预览层),渲染基于 Remotion。中文口播优先,中英混排完全支持,个人/教育/研究用途免费(PolyForm Noncommercial)。
三、核心功能深度解析
1. 字级配音同步——动效锚在哪个字上?
传统字幕和配音的关系是「一句话配完」,而 video-talkcraft 把粒度细化到「字」。它内置两种 ASR 后端:默认 FireRedASR2-CTC int8(首次使用下载 767MB 模型),备选 faster-whisper(无需手动下载)。在 110 秒中英混合口播上与 GPU 强制对齐器对比,字级偏差中位 20–40ms、最差 200ms、质检零误报。
更关键的是,2026-09-11 新增的「配音预剪」脚本 scripts/voice_trim.py 会先以口播稿为真值剪掉口水词、结巴重说、过长停顿再做时间戳。剪切的边界严格遵循一条规则:稿子里没有的插入段会剪,但 ASR 听错的字永不剪——避免「剪掉了用户想说的字」。
2. 108 张动效配方卡——不是模板,是配方
和剪映模板不同,这里每张卡是「自包含 Remotion tsx 源码 + HTML 预览」:文案、颜色、字号、位置可调,但节奏命门(节拍锚点)固定不暴露——避免被乱拖导致动效变 PPT。
卡的覆盖范围很广:动态字卡、数据镜头、证据巡游、六式运动承接转场、长镜头世界画布、人物合成。每张卡都标了输入类型(视频 / 图片 / 纯文字 / 网页截图),选卡时按素材类型先做一遍过滤。2026-09-05 从姊妹库 video-shotcraft 移植了 19 张,把库存从 89 推到 108。
3. 七层反 PPT 系统——从结构上消灭静止帧
「PPT 翻页」的根源是相机不动 + 转场不承接。video-talkcraft 的对策是七层模型:
- 每场景一条极缓推进 / 拉出的相机曲线;
- 让位生命周期——主角入场 / 出场时其它层主动避让;
- 六式运动承接转场——场景之间不切黑,靠运动衔接;
- 排版预算——同屏元素不超过预算上限;
- 人脸安全区——人物出镜时字幕自动避开(用 OpenCV YuNet 量出来,不是目测);
- 静止段自动检测——机器闸直接抓漏网;
- 节奏锚点——每个语义拍对应一个动效节拍。
2026-09-04 的「做减法」更新里,idle 微动、环境呼吸、脉冲默认全部关掉,只保留推拉相机曲线和让位——少即是多。
4. 动效工作台——剪映式的成片后期台
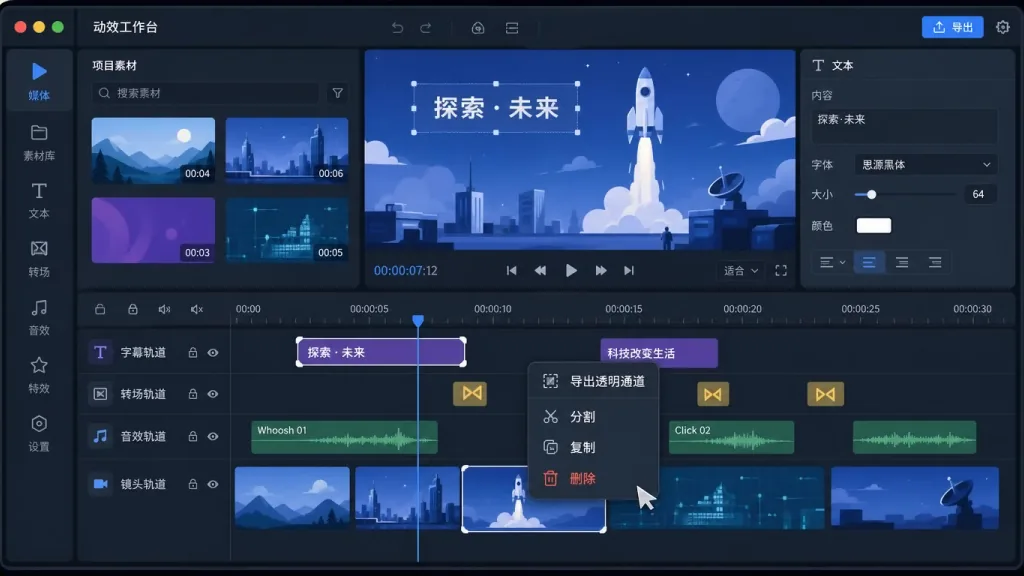
2026-09-02 上线的 workbench/ 是一个多轨时间线工具:素材库(动效库 / 音效 / 背景)+ schema 属性面板 + 实时预览 + 一键导出。108 张卡 100% 参数化,口播成片可一键拆成字幕 / 转场 / 环境 / 数字人 / 镜头 / 配音 / 音效七类多轨单元逐项微调。
特别值得注意的是「右键导出透明通道」:时间轨上右键任一动效片段可导出只含这一段的透明视频(MOV ProRes 4444 / WebM VP9 alpha),自动去掉卡根层幕底与人物剪影占位,给剪映 / PR / AE 当叠加素材。
四、技术亮点与性能数据
渲染速度是它最硬核的指标。在 201 秒竖屏片的实测里:
| 实测 | 之前 | 现在 |
|---|---|---|
| 全片首渲 | 13 min | 9 min |
| 改一个镜头出有声新片 | 整渲 | 53 s |
| 43 张静帧抽样 | 11 min | ~1 min |
| 评审读 160 张 QA 帧 | ≈16 万 token / 21 min | ≈4 万 token / 7 min |
提速的关键是 scripts/render_shots.mjs 按镜头切段并行渲、段内单进程保光栅一致,改一个镜头只重渲该段±邻段。评审提速来自 scripts/contact_sheet.py——把 QA 帧拼成 3×4 网格让评审子代理整版浏览,连拍三帧只在标了 burst 的状态切换锚点抽。
生态兼容性上,所有工程的 remotion/node_modules 与 workbench/node_modules 都软链到 runtime/node_modules,版本只在 runtime/package.json 钉一处。一份 node_modules ≈ 760 MB(含 190 MB 无头浏览器),之前六个工程 3.9 GB 现在不到 1 GB。
五、适用场景与人群
适合的 5 类场景:
- 知识科普口播(3–5 分钟中英混合讲解);
- 产品评测与功能演示(带 B-roll 截图与数据卡);
- 新闻解读与观点锐评(节奏紧凑、强调字级同步);
- 自媒体解说类横屏视频(中文优先);
- 教学课程视频(需要章节主题层与素排字幕)。
适合的人群:
- 内容创作者:想量产解说视频但没时间学剪辑;
- 知识博主:口播稿稳定但动效环节卡壳;
- AI 工具爱好者:已经在用 Claude Code / Codex 做代码生成,想拓展到视频生产;
- 中小团队:没有专职动效设计师,又不想交付 PPT 翻页式的成片。
不适合的场景:纯娱乐短剧、强叙事剧情片、需要真人演出与复杂调色的影视级项目。
六、竞品对比
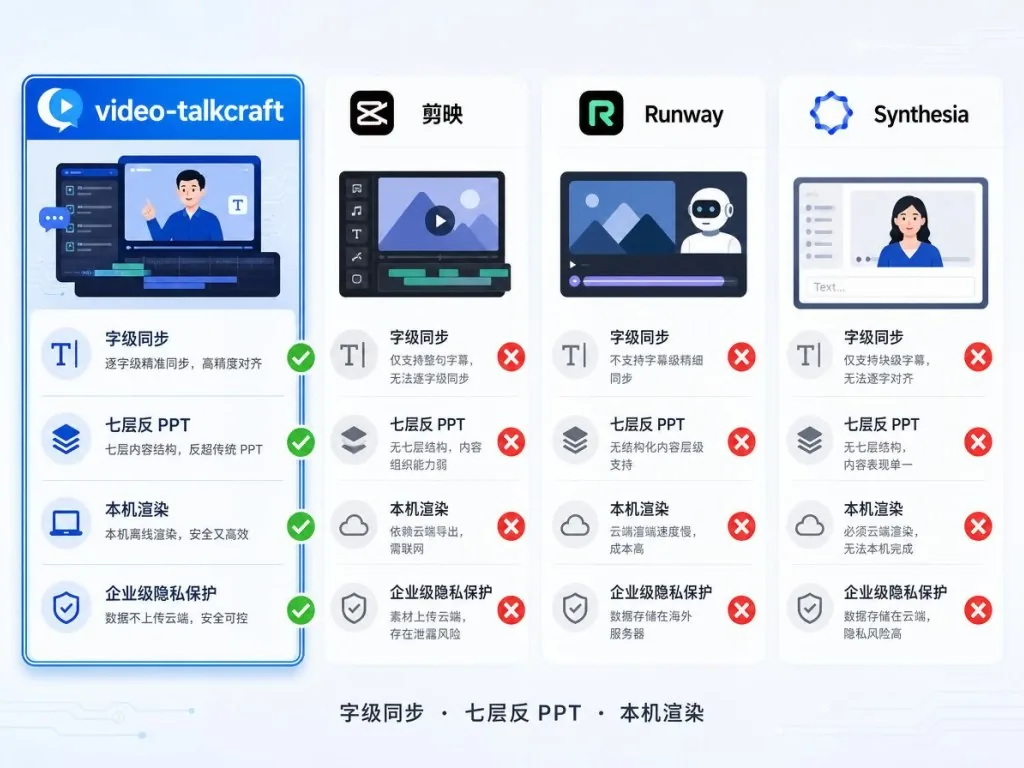
| 维度 | video-talkcraft | 剪映 / CapCut | Runway / Pika | Synthesia |
|---|---|---|---|---|
| 输入 | 口播稿 + 配音 + 可选素材 | 视频片段 + 模板 | 文字 → AI 生成视频 | 文字 → AI 数字人 |
| 字级同步 | 是(字级偏差 20–40ms) | 否(字幕轨独立) | 否 | 部分 |
| 动效粒度 | 108 张可参数化卡 | 固定模板 | AI 随机 | 固定数字人动作 |
| 反 PPT 机制 | 七层结构化系统 | 无 | 无 | 无 |
| 离线 / 本机渲染 | 是(Remotion) | 否 | 否 | 否 |
| 适合口播解说 | 高度匹配 | 一般 | 不匹配 | 一般 |
它的核心优势在于:把「口播视频」当作一个可被结构化拆解的工程问题,而不是模板套用问题——所以它能给你「字落哪就动哪」,而不是「看起来很酷」。
七、如何快速上手
最直接的方式:把仓库链接丢给 agent。
在 Claude Code / Codex 里直接说:
帮我安装这个 skill:https://github.com/Vincentwei1021/video-talkcraft
或者用 skills CLI:
npx skills add Vincentwei1021/video-talkcraft
手动安装:
git clone https://github.com/Vincentwei1021/video-talkcraft.git cd video-talkcraft ln -s "$(pwd)" ~/.claude/skills/video-talkcraft # Claude Code ln -s "$(pwd)" ~/.codex/skills/video-talkcraft # Codex
环境依赖:Node 18+、Python 3.10+(CPU 时间戳对齐需 zhconv pypinyin sherpa-onnx soundfile numpy)、ffmpeg。
最小可用示例:
用 video-talkcraft 把这份口播稿 + voiceover.wav 做成视频。做一条 100 秒的〈话题〉解说,稿子和音频在这里。
进阶建议:
- 没有现成配音时,可选 Fish Audio 流式生成(
scripts/tts_fishaudio.py),默认请求s2.1-pro-free免费层; - 想要后期微调,先让 agent 渲染成片,再打开
workbench/做多轨微调; - 想看动效全貌,访问 在线画廊 一页浏览 108 张预览。
八、总结与行动建议
video-talkcraft 把「口播视频」从一个靠模板拼贴的手工活,变成一个可被 agent 自动化生产的工程问题。字级配音同步解决了「字落哪就动哪」的精度问题;108 张配方卡提供了覆盖绝大多数口播场景的动效组件库;七层反 PPT 系统从结构上消灭了静止帧;动效工作台让你在自动生成之后还有手动微调的余地。
如果你已经在用 Claude Code 或 Codex 做代码生成、口播稿稳定产出、又被剪辑环节卡住——不妨让 video-talkcraft 接一次试试。它不会替你写口播稿,但会把从配音到成片的那段路走完。
链接:
- GitHub:https://github.com/Vincentwei1021/video-talkcraft
- 在线画廊:https://vincentwei1021.github.io/video-talkcraft/
- 文档入口:SKILL.md
用本 skill 做出的视频归你所有。免费授权(PolyForm Noncommercial 1.0.0),个人、教育、研究用途直接用,商业用途需事先联系作者(vincentwei1021@gmail.com)。
#video-talkcraft #VideoTalkcraft #vincentwei1021 #AI视频剪辑 #脚本化视频 #口播视频 #开源项目 #GitHub